

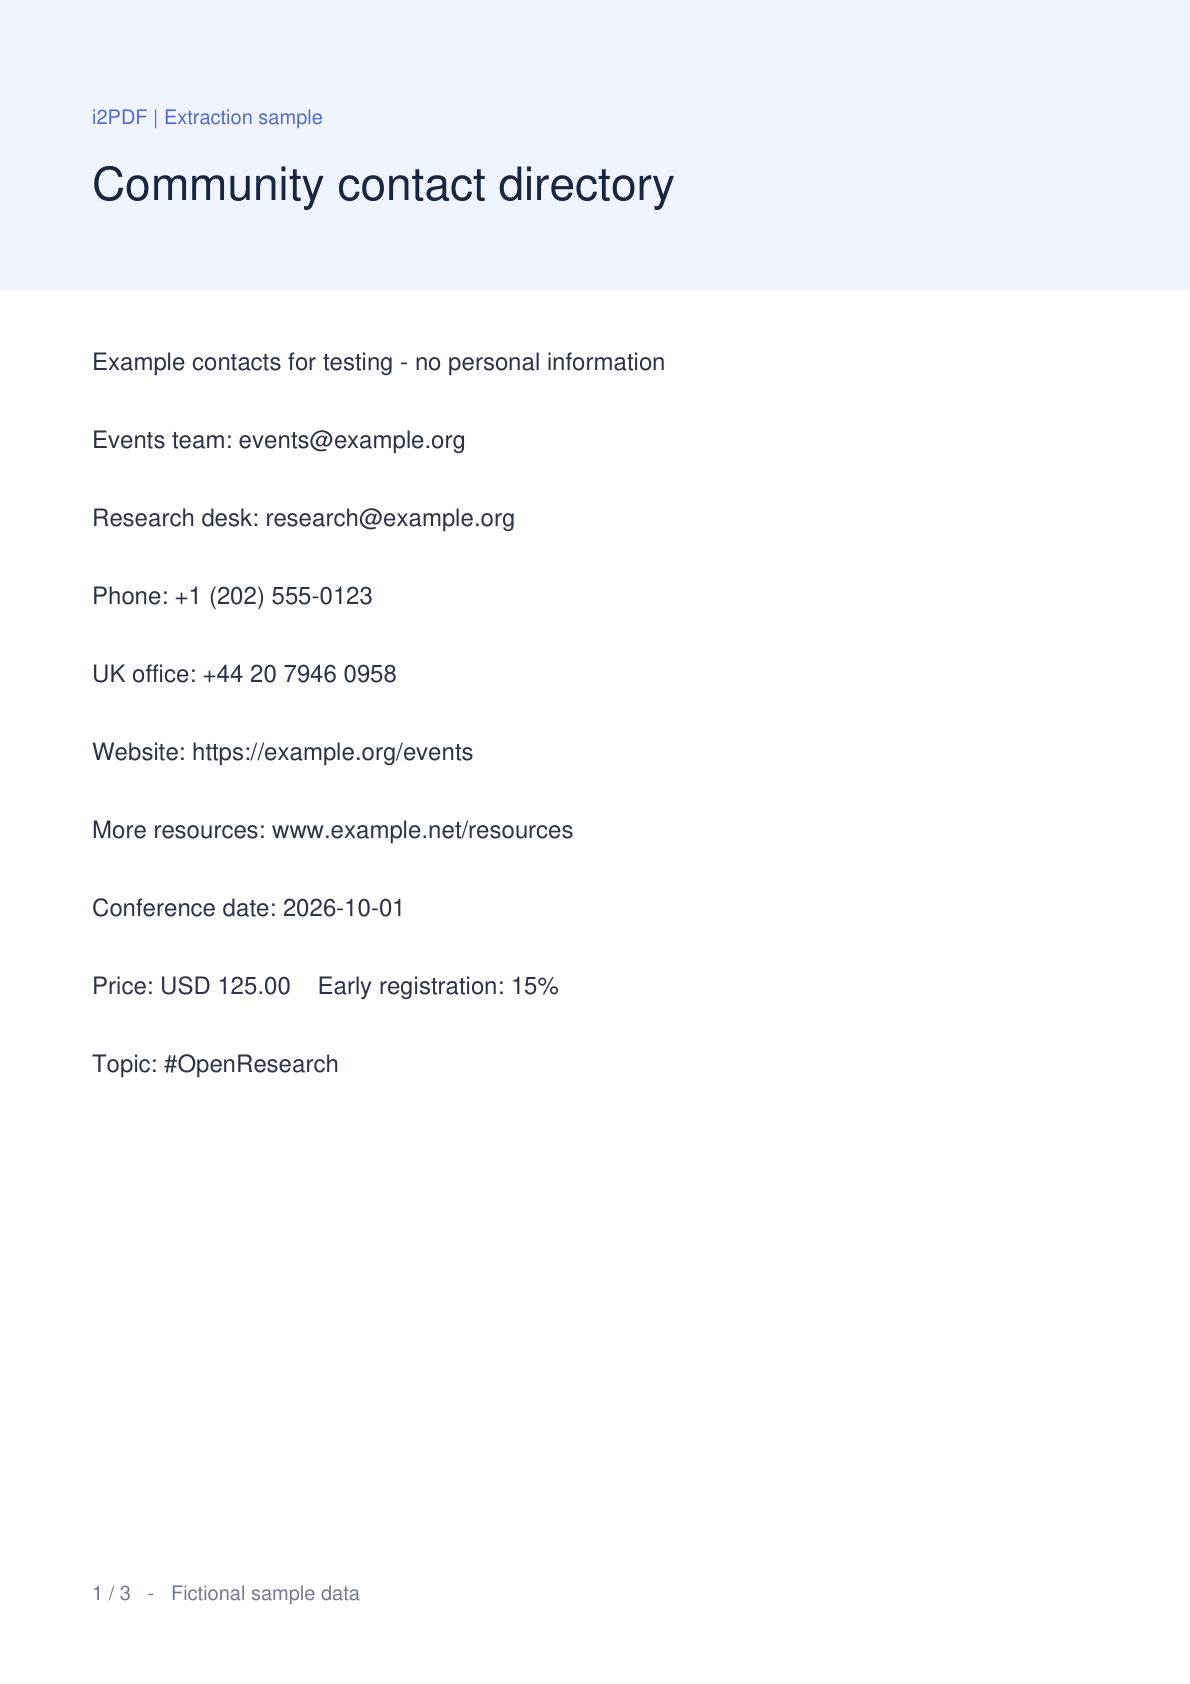
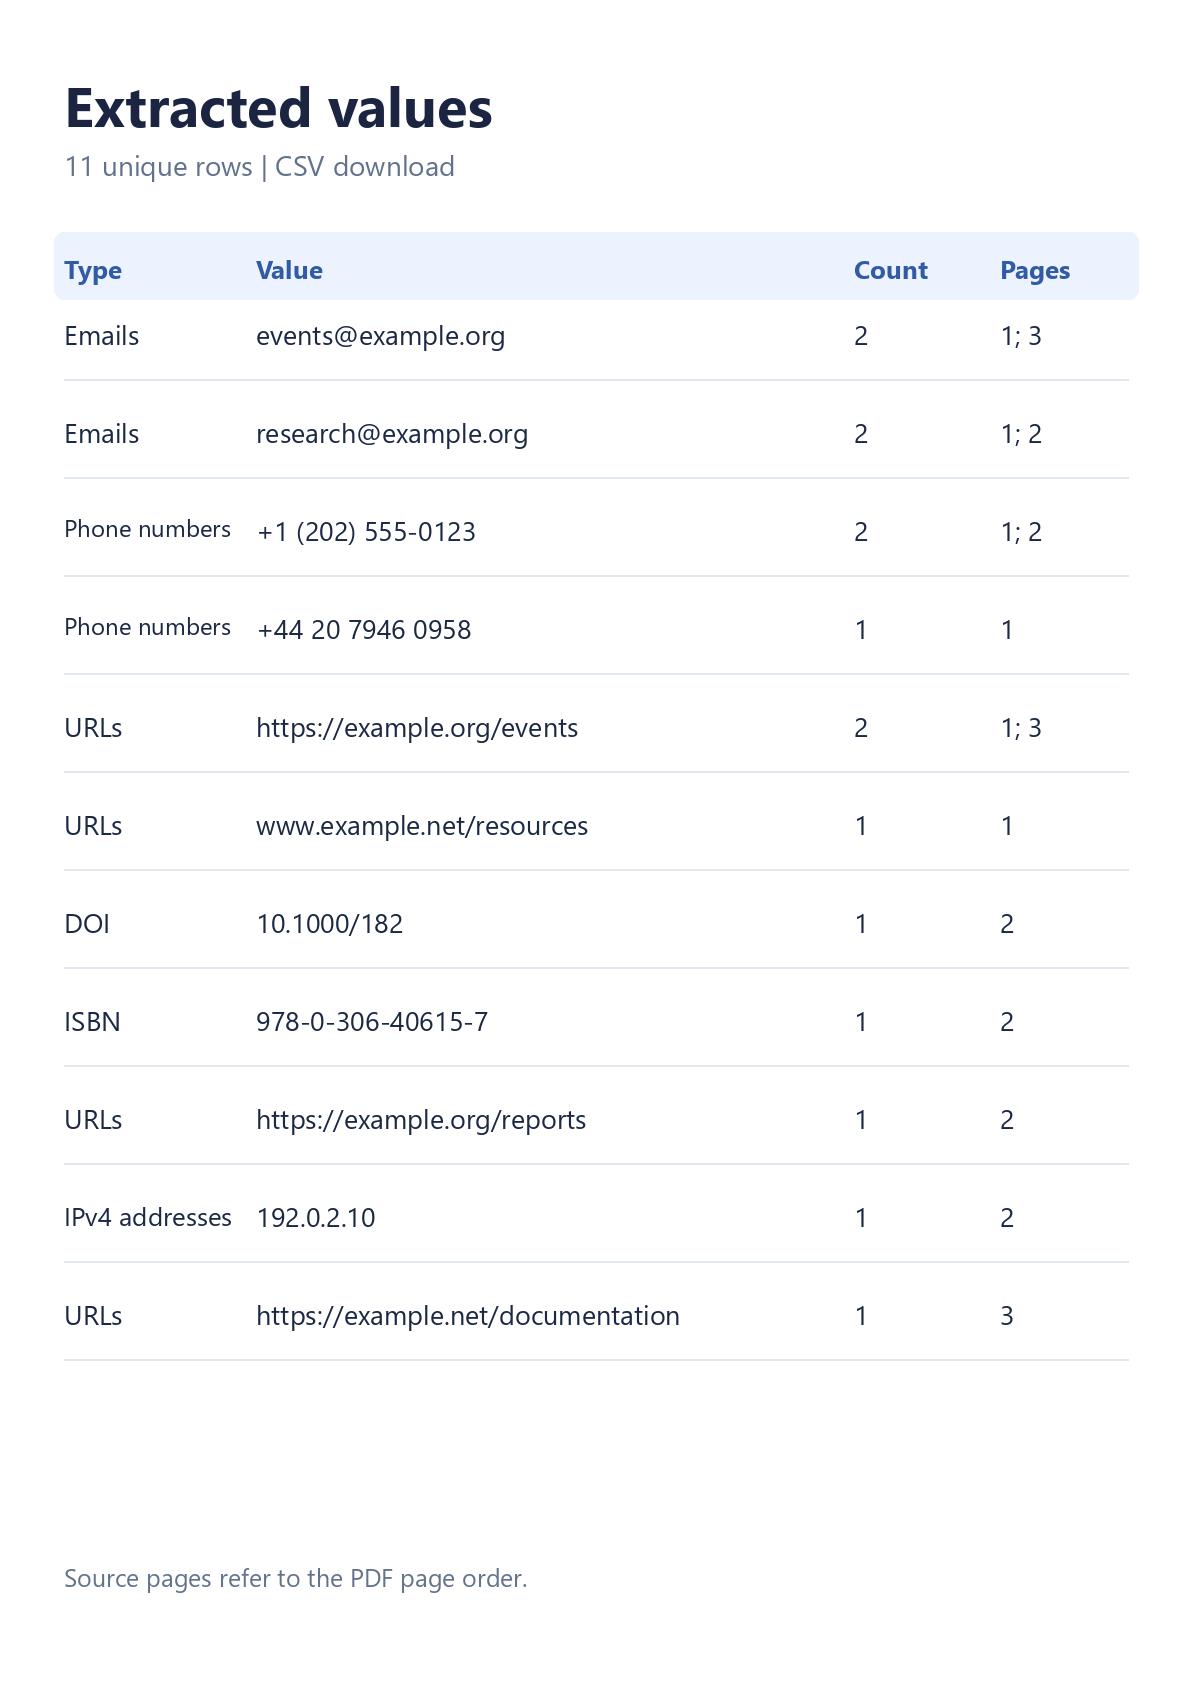

PDF से डेटा निकालें खोलें ताकि एक PDF से मानों को लाइन-दर-लाइन कॉपी किए बिना एकत्र किया जा सके। तुलना वास्तविक नमूना दस्तावेज़ और टूल से डाउनलोड की गई CSV का उपयोग करती है। ईमेल, फ़ोन, URLs, DOI, ISBN और IPv4 चयनित होने पर, तीन-पृष्ठ का नमूना 15 घटनाओं से 11 अद्वितीय पंक्तियाँ उत्पन्न करता है।
अपनी PDF खोलें
एक PDF अपलोड करें, या इस उदाहरण का पालन करने के लिए नमूना आज़माएं चुनें। PDF पूर्वावलोकन और पृष्ठ थंबनेल दिखाई देते हैं। आपकी मूल फ़ाइल अपरिवर्तित रहती है, और एक्सट्रैक्शन आपके ब्राउज़र में चलता है।
एक टेक्स्ट-आधारित निर्देशिका, रिपोर्ट, शोध पत्र या ब्रोशर एक उपयोगी शुरुआती बिंदु है। केवल-छवि स्कैन को उनके मुद्रित टेक्स्ट को पहचानने से पहले OCR की आवश्यकता होती है।
उपयोगी विकल्प चुनें
फ़ोन पर, सेटिंग्स खोलें। डेस्कटॉप पर, पूर्वावलोकन के बगल में सेटिंग्स पैनल का उपयोग करें।
क्या एक्सट्रैक्ट करें के अंतर्गत, ईमेल, फ़ोन नंबर और URLs पहले से चयनित होते हैं। अधिक डेटा प्रकार खोलें और DOI, ISBN और IPv4 पते भी चुनें। डुप्लिकेट हटाने को सक्षम रखें और CSV चुनें।
मिलानों को निकालें और जांचें
एक्सट्रैक्ट करें चुनें। जब प्रोसेसिंग समाप्त हो जाती है, तो परिणाम टैब मान, घटना गणना और स्रोत पृष्ठ दिखाता है। PDF पूर्वावलोकन में इसके स्थान का निरीक्षण करने के लिए एक गोलाकार पृष्ठ संख्या चुनें, फिर परिणामों पर वापस आएं।
आउटपुट संपर्क सूची को DOI 10.1000/182, ISBN 978-0-306-40615-7 और पृष्ठ 2 से IPv4 पता 192.0.2.10 के साथ जोड़ता है। प्रकार कॉलम प्रत्येक मान की पहचान करता है। एक छोटा सबसेट कॉपी या डाउनलोड करने से पहले किसी प्रासंगिक शब्द या पहचानकर्ता के लिए फ़िल्टर करें।
सूची को सीमित करने के लिए परिणाम फ़िल्टर करें का उपयोग करें। कॉपी और डाउनलोड में सभी मिलान वाली पंक्तियाँ शामिल होती हैं, तब भी जब परिणाम तालिका कई स्क्रीन तक फैली हो।
CSV या TXT डाउनलोड करें
CSV डाउनलोड करें चुनें, फिर तैयार स्क्रीन पर मुख्य डाउनलोड बटन का उपयोग करें। CSV में प्रकार, मान, गणना और पृष्ठ कॉलम होते हैं। TXT और सभी कॉपी करें में प्रति पंक्ति एक मान होता है।
CSV मान जिन्हें स्प्रेडशीट फ़ार्मुलों के रूप में व्याख्यायित किया जा सकता है, उन्हें एक अग्रणी अपोस्ट्रोफी के साथ सुरक्षित किया जाता है। उदाहरण के लिए, एक अंतरराष्ट्रीय फ़ोन नंबर प्लस चिह्न से शुरू होता है। यदि आपको स्प्रेडशीट सुरक्षा के बिना एक सादी सूची चाहिए तो TXT का उपयोग करें।
सामान्य प्रश्न
क्या यह कोई भी नंबर या हर पहचानकर्ता निकालता है?
नहीं। प्रत्येक चयनित श्रेणी के अपने मान्यता नियम हैं। IPv6, प्रतिशत, कीमतें और भुगतान-कार्ड नंबर एक्सट्रैक्ट नहीं किए जाते हैं। स्रोत के विरुद्ध मिलानों की समीक्षा करें; वैध स्वरूपण यह पुष्टि नहीं कर सकता कि कोई संपर्क या पहचानकर्ता मौजूद है।
मुझे स्कैन की गई PDF के साथ क्या करना चाहिए?
पहले PDF OCR चलाएं, फिर मान्यता प्राप्त प्रति को इस टूल में लोड करें। OCR आउटपुट की सावधानीपूर्वक जांच करें: एक गलत वर्ण पता या पहचानकर्ता को बदल सकता है।
एक्सट्रैक्शन सीमाएं क्या हैं?
50 MiB और 750 पृष्ठों तक की एक PDF का उपयोग करें। एक्सट्रैक्शन कुल मिलाकर 20,000 मिलानों और प्रति पृष्ठ 2,000 तक सीमित है, जिसमें 90-सेकंड का प्रोसेसिंग बजट है। टेक्स्ट और एनोटेशन सीमाएं भी लागू होती हैं। यदि कोई सीमा या अपठनीय पृष्ठ स्कैन को बाधित करता है, तो टूल एक आंशिक-परिणाम सूचना दिखाता है और निर्यात फ़ाइल नाम को आंशिक के रूप में चिह्नित करता है।
क्या मेरे PDF लिंक स्वचालित रूप से खुल जाते हैं?
नहीं। एक्सट्रैक्शन ब्राउज़र में फ़ाइल को पढ़ता है और एक्सट्रैक्ट किए गए गंतव्यों पर नहीं जाता है। पृष्ठ बटन PDF पूर्वावलोकन के भीतर नेविगेट करते हैं।
मानों और उनके संदर्भ को रखें
एक केंद्रित सूची निकालें, स्रोत पृष्ठों की जांच करें, और वह प्रारूप डाउनलोड करें जो आपके अगले चरण के लिए उपयुक्त हो।


