

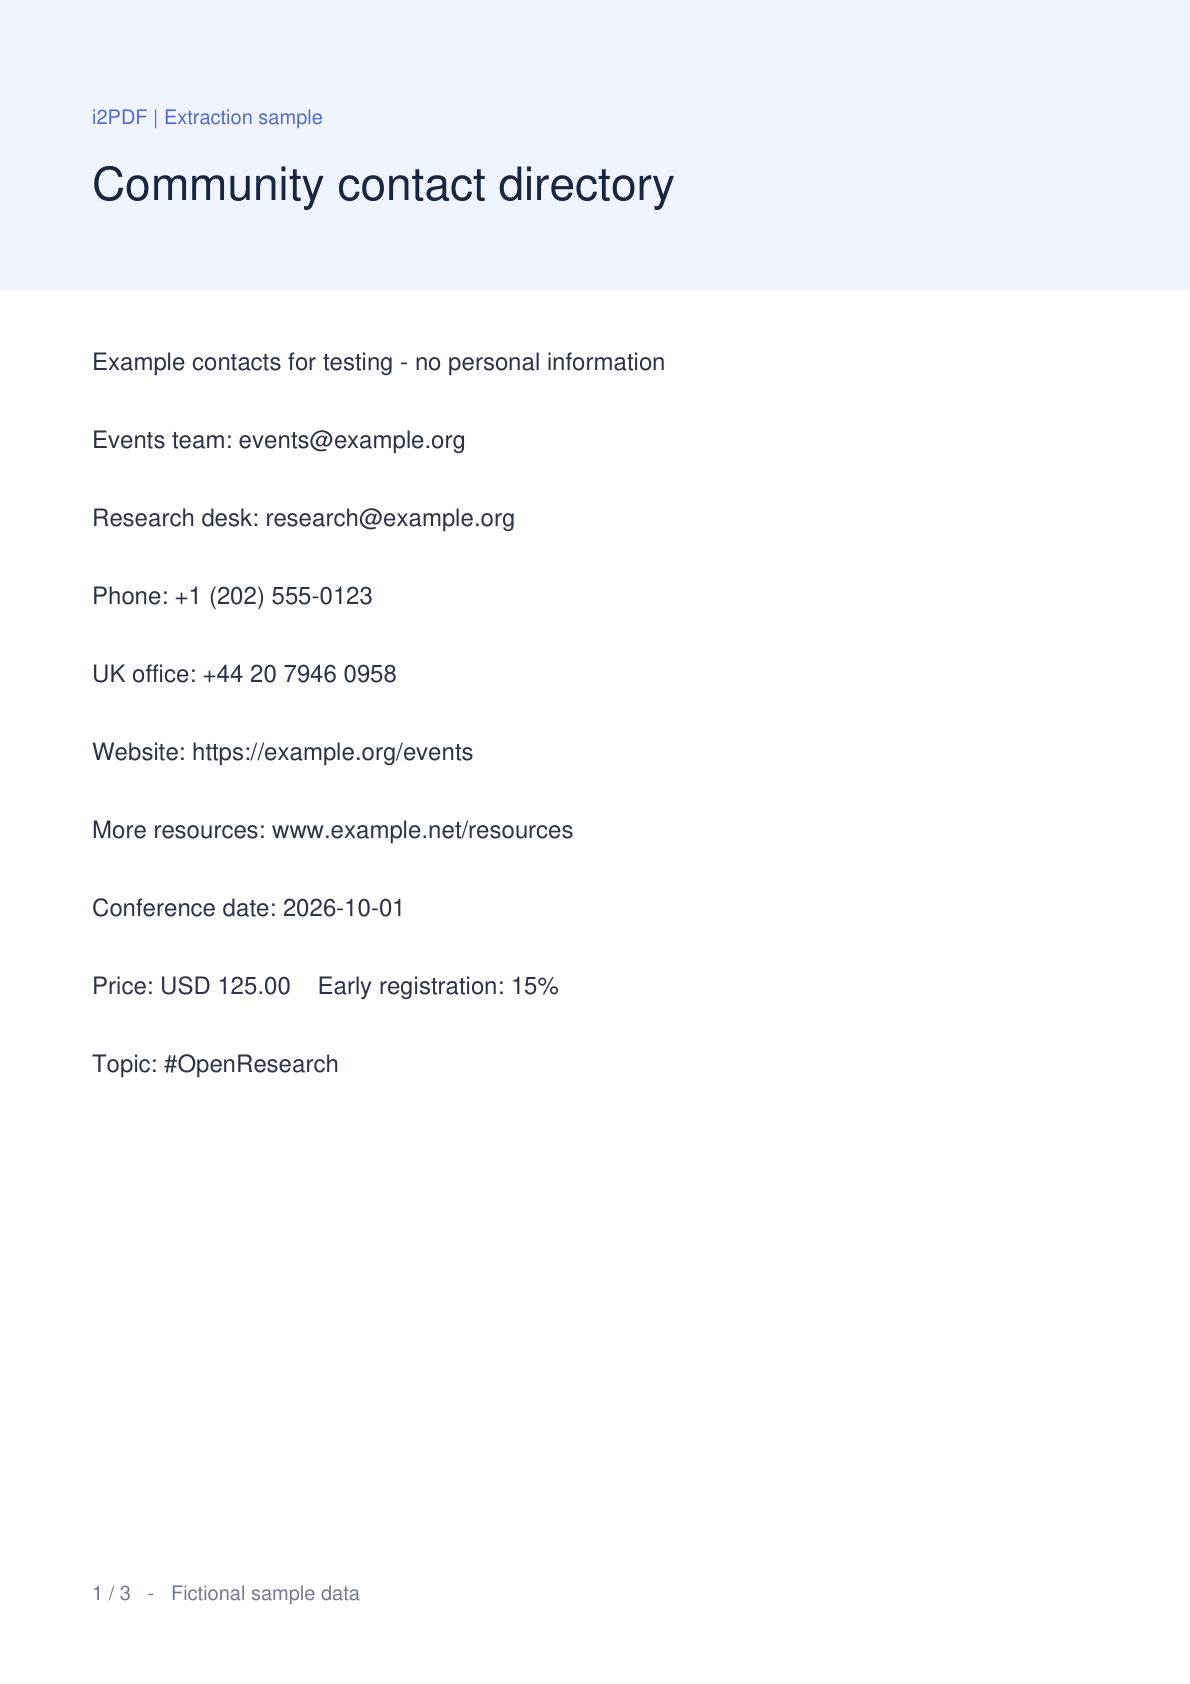
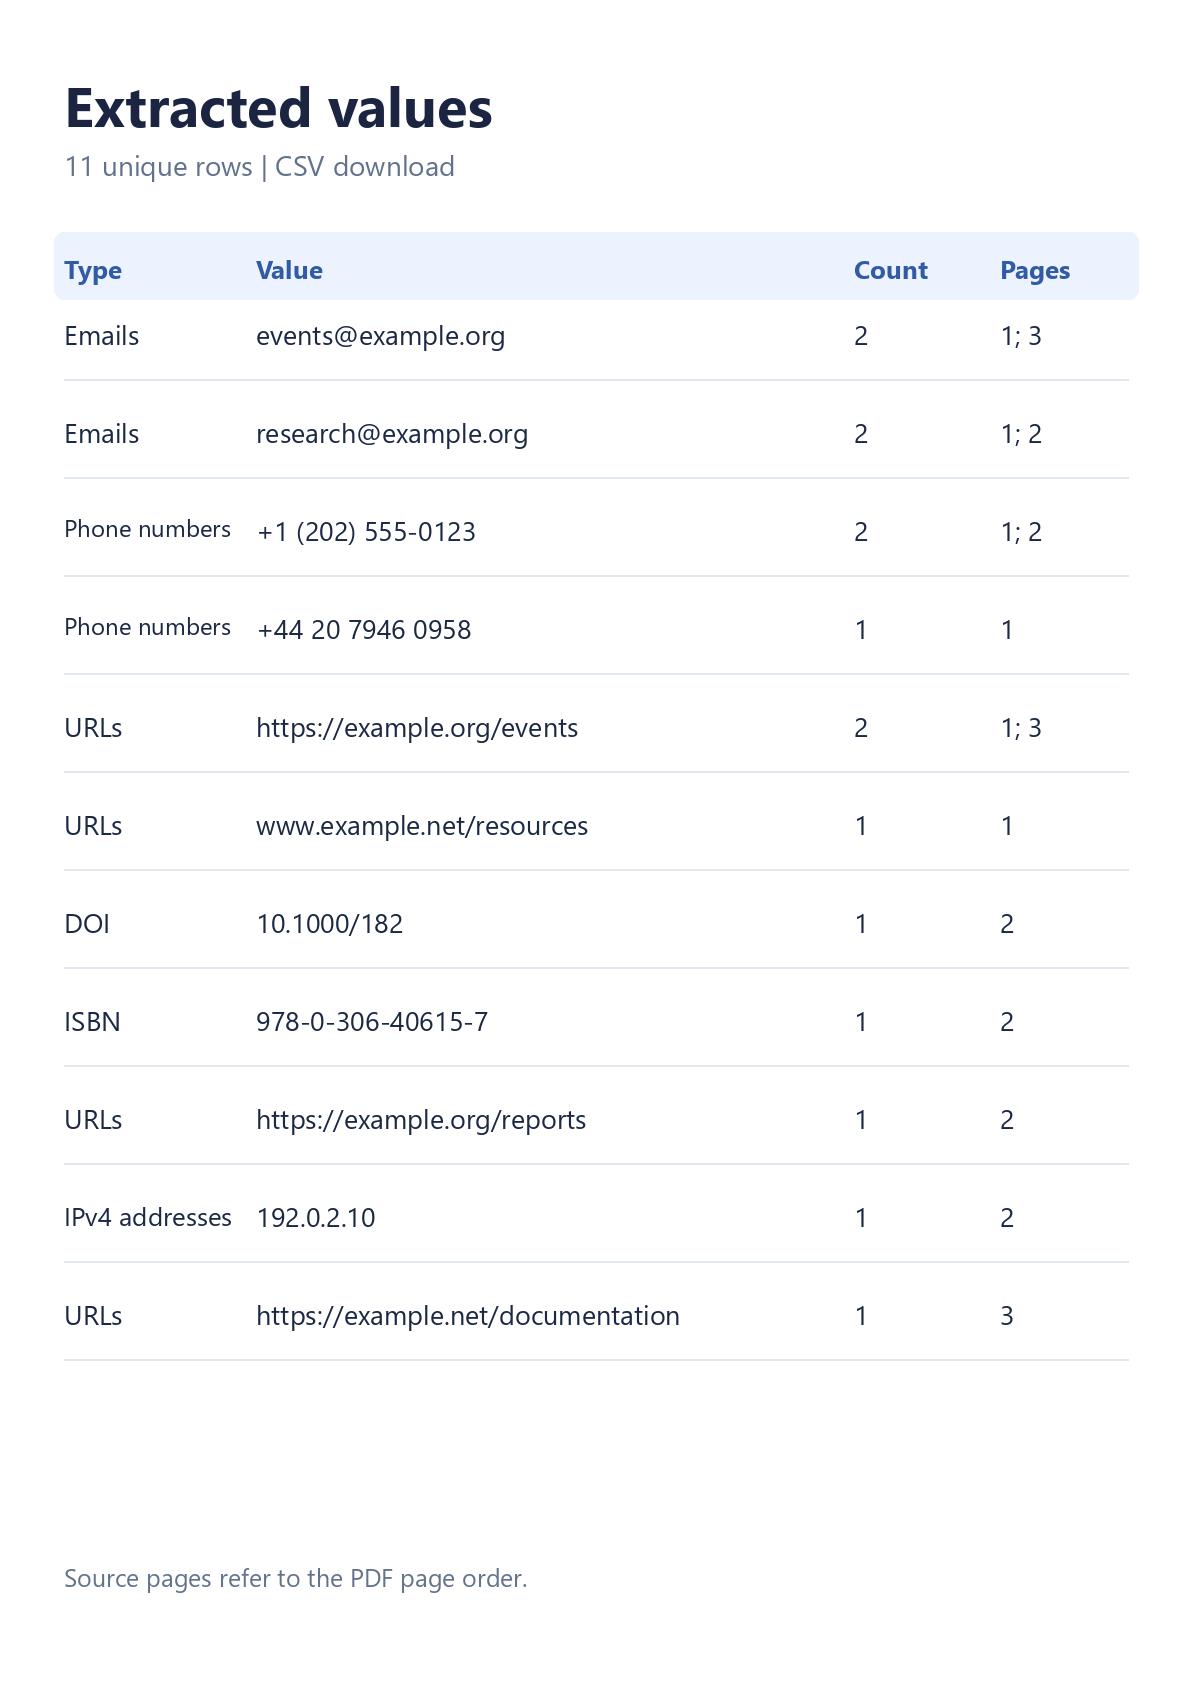

Deschide Extrage date dintr-un PDF pentru a colecta valori dintr-un PDF fără a le copia linie cu linie. Comparația folosește documentul eșantion real și un CSV descărcat din instrument. Cu emailuri, telefoane, URL-uri, DOI, ISBN și IPv4 selectate, eșantionul de trei pagini produce 11 rânduri unice din 15 apariții.
Deschide PDF-ul tău
Încarcă un PDF sau selectează Încearcă eșantionul pentru a urmări acest exemplu. Previzualizarea PDF și miniaturile paginilor apar. Fișierul tău original rămâne neschimbat, iar extragerea rulează în browserul tău.
Un director bazat pe text, un raport, o lucrare de cercetare sau o broșură reprezintă un punct de plecare util. Scanările care conțin doar imagini necesită OCR înainte ca textul lor tipărit să poată fi recunoscut.
Alege opțiunile utile
Pe telefon, deschide Setări. Pe desktop, folosește panoul de setări de lângă previzualizare.
Sub Ce să extragi, emailurile, numerele de telefon și URL-urile sunt selectate implicit. Deschide Mai multe tipuri de date și selectează de asemenea DOI, ISBN și adrese IPv4. Lasă activată eliminarea duplicatelor și alege CSV.
Extrage și verifică potrivirile
Selectează Extrage. Când procesarea se termină, fila Rezultate arată valorile, numărul de apariții și paginile sursă. Selectează un număr de pagină circular pentru a inspecta locația sa în previzualizarea PDF, apoi revino la Rezultate.
Rezultatul combină lista de contacte cu DOI 10.1000/182, ISBN 978-0-306-40615-7 și adresa IPv4 192.0.2.10 de la pagina 2. Coloana Tip identifică fiecare valoare. Filtrează după un cuvânt sau identificator relevant înainte de a copia sau descărca un subset mai mic.
Folosește Filtrează rezultatele pentru a restrânge lista. Copierea și descărcarea includ toate rândurile potrivite, chiar și atunci când tabelul de rezultate se întinde pe mai multe ecrane de rânduri.
Descarcă CSV sau TXT
Selectează Descarcă CSV, apoi folosește butonul principal Descarcă de pe ecranul gata. CSV conține coloanele Tip, Valoare, Număr și Pagini. TXT și Copiază tot conțin o valoare pe linie.
Valorile CSV care ar putea fi interpretate ca formule de calcul tabelar sunt protejate cu un apostrof la început. De exemplu, un număr de telefon internațional începe cu un semn plus. Folosește TXT dacă ai nevoie de o listă simplă fără protecție pentru calcul tabelar.
Întrebări frecvente
Acesta extrage orice număr sau fiecare identificator?
Nu. Fiecare categorie selectată are propriile reguli de recunoaștere. IPv6, procentele, prețurile și numerele cardurilor de plată nu sunt extrase. Verifică potrivirile față de sursă; formatarea validă nu poate confirma că un contact sau un identificator există.
Ce ar trebui să fac cu un PDF scanat?
Rulează PDF OCR mai întâi, apoi încarcă copia recunoscută în acest instrument. Verifică cu atenție rezultatul OCR: un caracter greșit poate schimba o adresă sau un identificator.
Care sunt limitele de extragere?
Folosește un PDF de până la 50 MiB și 750 pagini. Extragerea este limitată la 20,000 potriviri în total și 2,000 pe pagină, cu un buget de procesare de 90 secunde. Se aplică și limite de text și adnotări. Dacă o limită sau o pagină ilizibilă întrerupe scanarea, instrumentul afișează o notificare de rezultate parțiale și marchează numele fișierului de export ca parțial.
Linkurile mele din PDF sunt deschise automat?
Nu. Extragerea citește fișierul în browser și nu vizitează destinațiile extrase. Butoanele de pagină navighează în cadrul previzualizării PDF.
Păstrează valorile și contextul lor
Extrage o listă concentrată, verifică paginile sursă și descarcă formatul care se potrivește următorului tău pas.


