

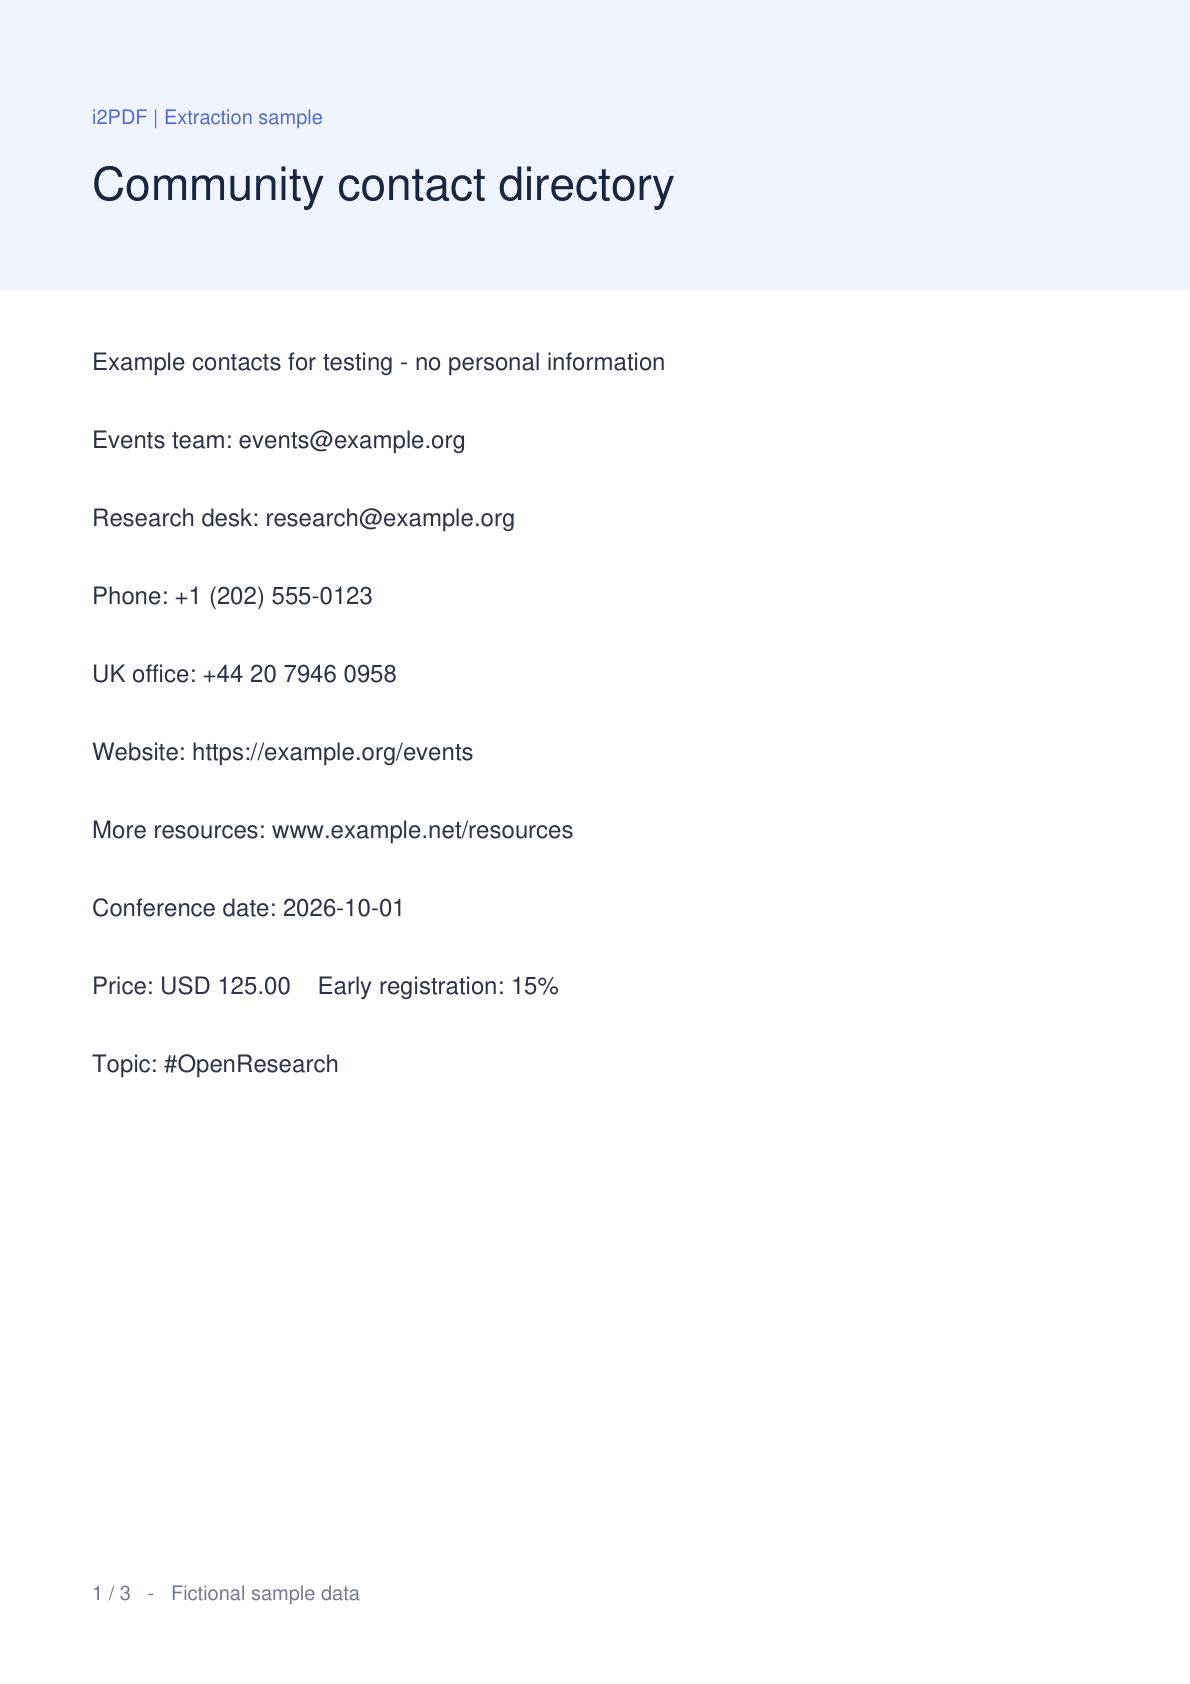
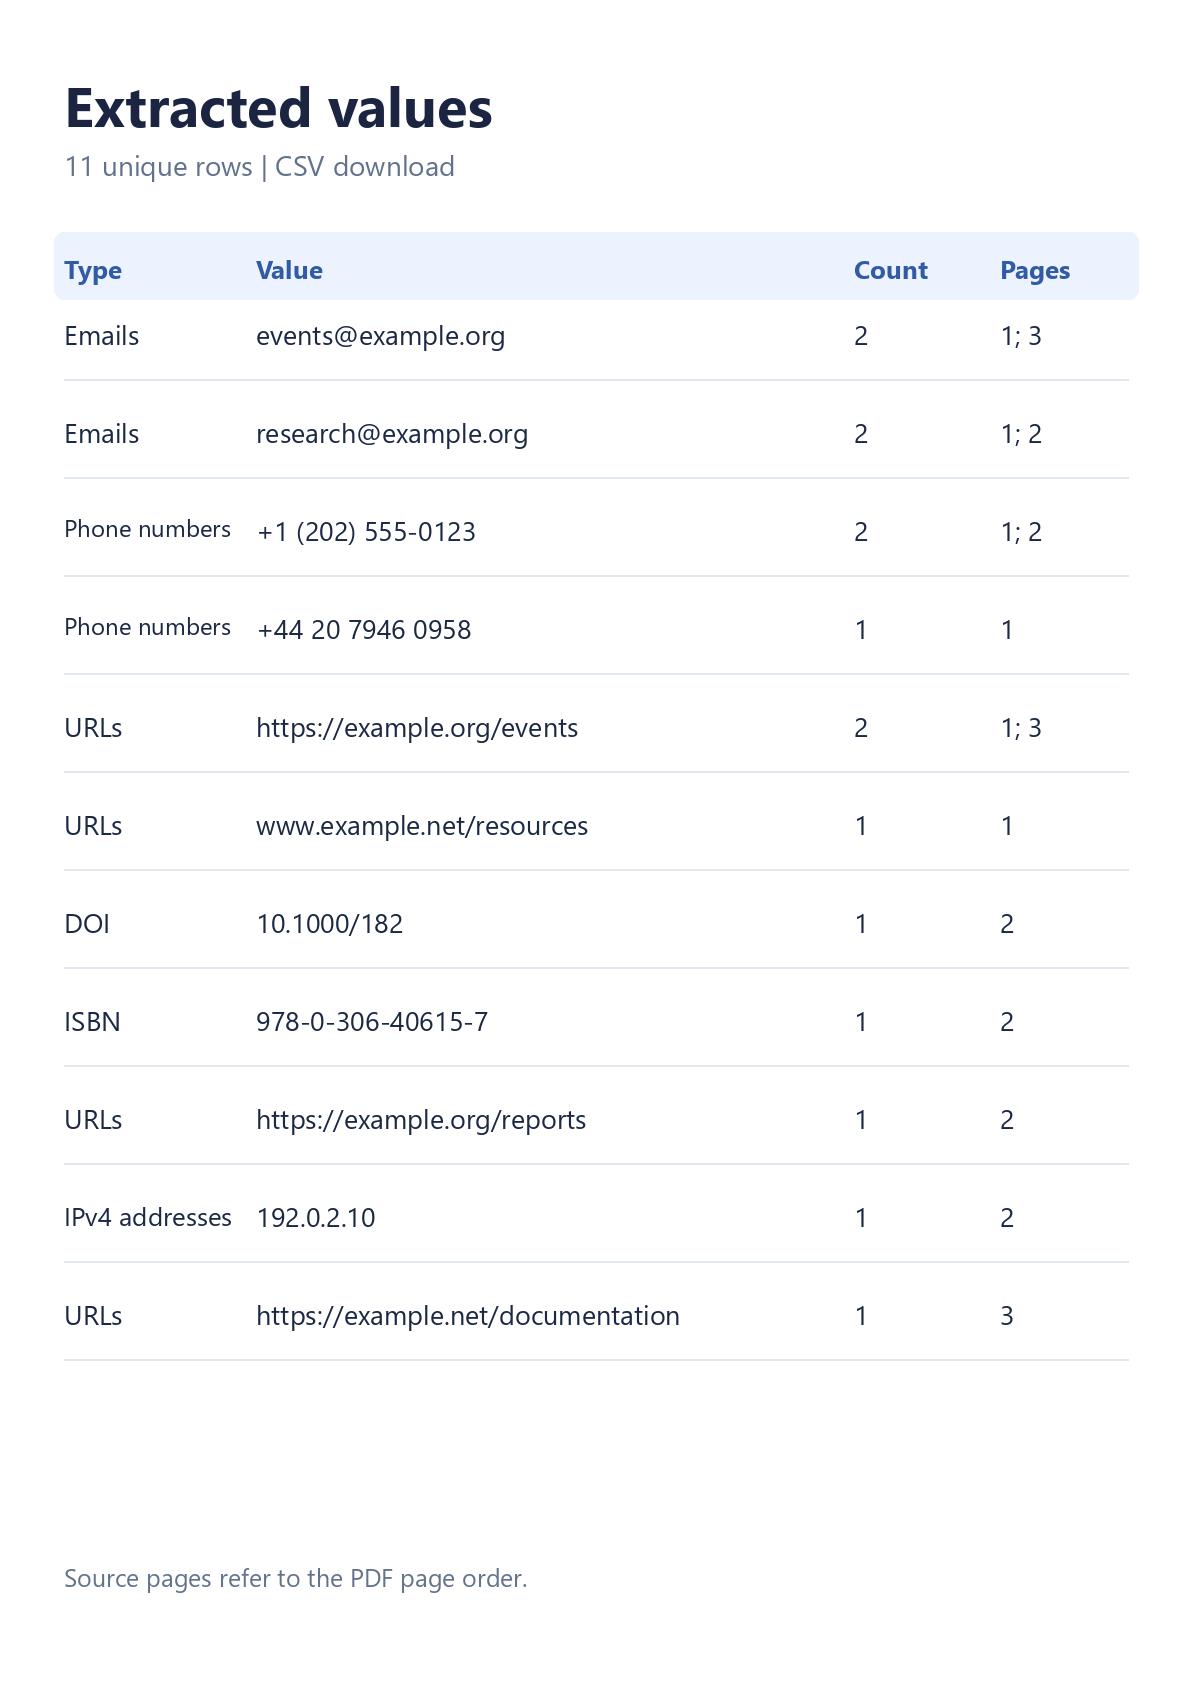

PDF থেকে ডেটা এক্সট্র্যাক্ট করুন ওপেন করুন যাতে একটি PDF থেকে লাইন বাই লাইন কপি না করেই মানগুলো সংগ্রহ করা যায়। এই তুলনাটি একটি আসল স্যাম্পল ডকুমেন্ট এবং টুল থেকে ডাউনলোড করা একটি CSV ব্যবহার করে। ইমেইল, ফোন, URL, DOI, ISBN এবং IPv4 সিলেক্ট করা থাকলে, তিন পৃষ্ঠার স্যাম্পলটি ১৫টি অকারেন্স থেকে ১১টি ইউনিক সারি তৈরি করে।
আপনার PDF ওপেন করুন
একটি PDF আপলোড করুন, অথবা এই উদাহরণটি অনুসরণ করতে স্যাম্পল ব্যবহার করে দেখুন সিলেক্ট করুন। PDF প্রিভিউ এবং পৃষ্ঠার থাম্বনেইলগুলো দেখা যাবে। আপনার অরিজিনাল ফাইলটি অপরিবর্তিত থাকবে এবং এক্সট্র্যাকশন আপনার ব্রাউজারে চলবে।
একটি টেক্সট-ভিত্তিক ডিরেক্টরি, রিপোর্ট, রিসার্চ পেপার বা ব্রোশিওর হলো একটি দরকারি শুরুর পয়েন্ট। শুধুমাত্র ইমেজ স্ক্যানগুলোর প্রিন্ট করা টেক্সট শনাক্ত করার আগে OCR-এর প্রয়োজন হয়।
দরকারি অপশনগুলো বেছে নিন
ফোনে, সেটিংস ওপেন করুন। ডেস্কটপে, প্রিভিউয়ের পাশে থাকা সেটিংস প্যানেল ব্যবহার করুন।
কী এক্সট্র্যাক্ট করবেন-এর অধীনে, ইমেইল, ফোন নম্বর এবং URL সিলেক্ট করা থাকে। আরও ডেটা টাইপ ওপেন করুন এবং DOI, ISBN এবং IPv4 ঠিকানা সিলেক্ট করুন। ডুপ্লিকেট সরানোর অপশনটি চালু রাখুন এবং CSV বেছে নিন।
এক্সট্র্যাক্ট করুন এবং মিলগুলো যাচাই করুন
এক্সট্র্যাক্ট করুন সিলেক্ট করুন। প্রসেসিং শেষ হলে, ফলাফল ট্যাবে মান, অকারেন্সের সংখ্যা এবং সোর্স পৃষ্ঠাগুলো দেখা যাবে। PDF প্রিভিউতে এর অবস্থান পরীক্ষা করতে একটি বৃত্তাকার পৃষ্ঠার নম্বরে ক্লিক করুন, তারপর ফলাফলে ফিরে আসুন।
আউটপুটটি কন্টাক্ট তালিকার সাথে DOI 10.1000/182, ISBN 978-0-306-40615-7 এবং পৃষ্ঠা ২ থেকে IPv4 ঠিকানা 192.0.2.10 একত্রিত করে। ধরন কলামটি প্রতিটি মান শনাক্ত করে। একটি ছোট সাবসেট কপি বা ডাউনলোড করার আগে প্রাসঙ্গিক শব্দ বা আইডেন্টিফায়ার দিয়ে ফিল্টার করুন।
তালিকাটি ছোট করতে ফলাফল ফিল্টার করুন ব্যবহার করুন। কপি এবং ডাউনলোড করার সময় সব ম্যাচিং সারি অন্তর্ভুক্ত থাকে, এমনকি যখন ফলাফলের টেবিলটি কয়েক স্ক্রিন জুড়ে থাকে তখনও।
CSV বা TXT ডাউনলোড করুন
CSV ডাউনলোড করুন সিলেক্ট করুন, তারপর রেডি স্ক্রিনে মূল ডাউনলোড বাটনটি ব্যবহার করুন। CSV-তে ধরন, মান, সংখ্যা এবং পৃষ্ঠা কলাম থাকে। TXT এবং সব কপি করুন-এ প্রতি লাইনে একটি করে মান থাকে।
যেসব CSV মান স্প্রেডশিট ফর্মুলা হিসেবে গণ্য হতে পারে, সেগুলোকে একটি অ্যাপোস্ট্রফি দিয়ে সুরক্ষিত করা হয়। উদাহরণস্বরূপ, একটি আন্তর্জাতিক ফোন নম্বর একটি প্লাস চিহ্ন দিয়ে শুরু হয়। স্প্রেডশিট সুরক্ষা ছাড়া সাধারণ তালিকার প্রয়োজন হলে TXT ব্যবহার করুন।
সাধারণ প্রশ্নাবলী
এটি কি যেকোনো নম্বর নাকি প্রতিটি আইডেন্টিফায়ার এক্সট্র্যাক্ট করে?
না। প্রতিটি সিলেক্ট করা ক্যাটাগরির নিজস্ব শনাক্তকরণ নিয়ম আছে। IPv6, শতাংশ, দাম এবং পেমেন্ট-কার্ড নম্বর এক্সট্র্যাক্ট করা হয় না। সোর্সের সাথে মিলগুলো যাচাই করুন; সঠিক ফরম্যাটিং মানেই এই নয় যে কোনো কন্টাক্ট বা আইডেন্টিফায়ার বাস্তবে বিদ্যমান।
স্ক্যান করা PDF-এর ক্ষেত্রে আমার কী করা উচিত?
প্রথমে PDF OCR চালান, তারপর স্বীকৃত কপিটি এই টুলে লোড করুন। OCR আউটপুট সাবধানে চেক করুন: একটি ভুল অক্ষর ঠিকানা বা আইডেন্টিফায়ার বদলে দিতে পারে।
এক্সট্র্যাকশনের সীমা কত?
৫০ MiB এবং 750 পৃষ্ঠা পর্যন্ত একটি PDF ব্যবহার করুন। এক্সট্র্যাকশন মোট ২০,০০০ ম্যাচ এবং প্রতি পৃষ্ঠায় ২,০০০ ম্যাচের মধ্যে সীমাবদ্ধ, যার প্রসেসিং বাজেট ৯০ সেকেন্ড। টেক্সট এবং অ্যানোটেশন লিমিটও প্রযোজ্য। যদি কোনো লিমিট বা অস্পষ্ট পৃষ্ঠা স্ক্যান বাধাগ্রস্ত করে, তবে টুলটি আংশিক ফলাফলের নোটিশ দেখাবে এবং এক্সপোর্ট ফাইলনামটিকে আংশিক হিসেবে চিহ্নিত করবে।
আমার PDF লিঙ্কগুলো কি স্বয়ংক্রিয়ভাবে ওপেন হয়?
না। এক্সট্র্যাকশন ব্রাউজারে ফাইলটি পড়ে এবং এক্সট্র্যাক্ট করা গন্তব্যে ভিজিট করে না। পৃষ্ঠার বাটনগুলো PDF প্রিভিউয়ের ভেতরে নেভিগেট করে।
মান এবং সেগুলোর প্রেক্ষাপট বজায় রাখুন
একটি ফোকাসড তালিকা এক্সট্র্যাক্ট করুন, সোর্স পৃষ্ঠাগুলো চেক করুন এবং আপনার পরবর্তী ধাপের জন্য উপযুক্ত ফরম্যাটটি ডাউনলোড করুন।


