

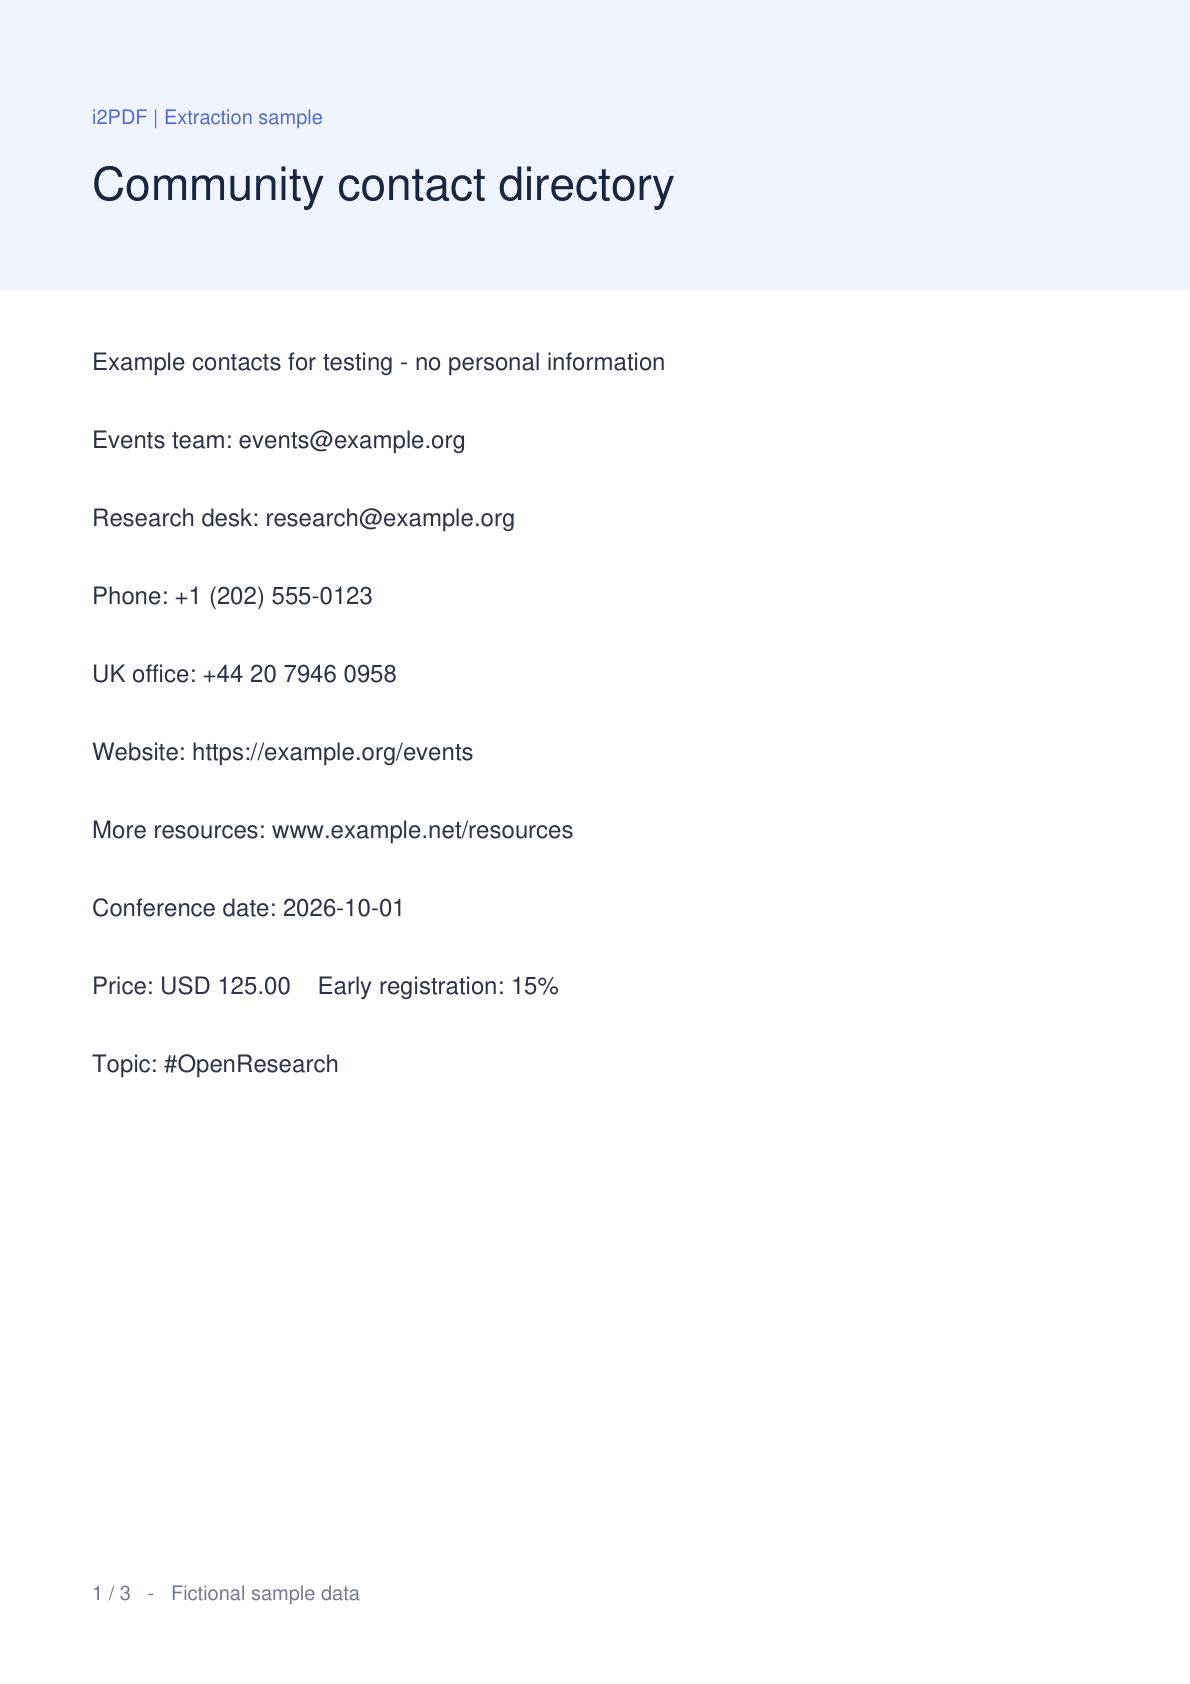
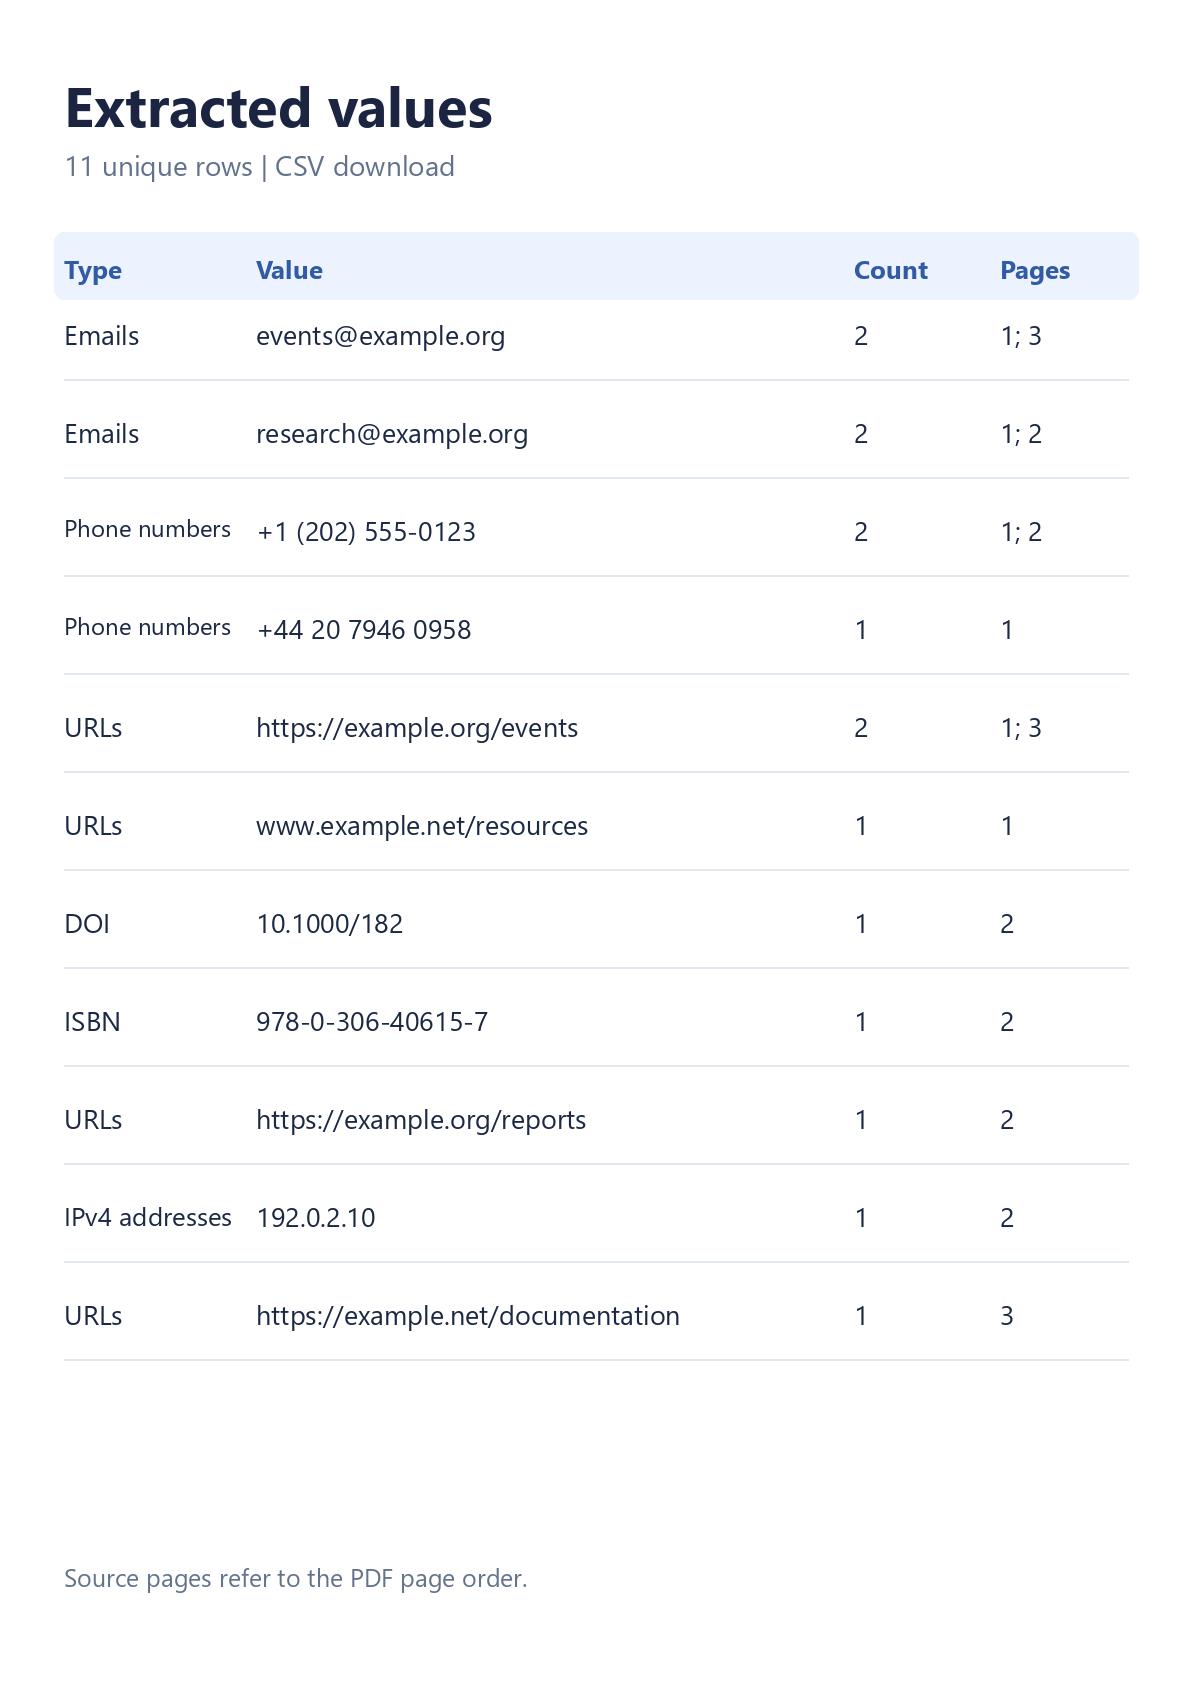

Buksan ang Kumuha ng Data mula sa PDF upang mangolekta ng mga value mula sa isang PDF nang hindi kinokopya ang mga ito nang paisa-isang linya. Ang paghahambing ay gumagamit ng totoong sample na dokumento at isang CSV na na-download mula sa tool. Sa napiling mga email, telepono, URL, DOI, ISBN at IPv4, ang tatlong-pahinang sample ay gumagawa ng 11 natatanging row mula sa 15 na paglitaw.
Buksan ang iyong PDF
Mag-upload ng isang PDF, o piliin ang Subukan ang sample upang sundin ang halimbawang ito. Lalabas ang preview ng PDF at mga thumbnail ng pahina. Ang iyong orihinal na file ay mananatiling hindi nababago, at ang pagkuha ay tatakbo sa iyong browser.
Ang isang directory na nakabase sa text, report, research paper o brochure ay isang kapaki-pakinabang na panimulang punto. Ang mga scan na puro imahe lamang ay nangangailangan ng OCR bago makilala ang kanilang naka-print na text.
Piliin ang mga kapaki-pakinabang na opsyon
Sa telepono, buksan ang Mga setting. Sa desktop, gamitin ang settings panel sa tabi ng preview.
Sa ilalim ng Ano ang kukunin, ang mga email, numero ng telepono at URL ay nakapili na. Buksan ang Higit pang mga uri ng data at piliin din ang DOI, ISBN at IPv4 address. Iwanang naka-enable ang pag-alis ng duplicate at piliin ang CSV.
Kunin at suriin ang mga tugma
Piliin ang Kunin. Kapag natapos na ang pagproseso, ipapakita ng tab na Mga resulta ang mga value, bilang ng paglitaw at mga source na pahina. Piliin ang isang pabilog na numero ng pahina upang suriin ang lokasyon nito sa preview ng PDF, pagkatapos ay bumalik sa Mga resulta.
Pinagsasama ng output ang listahan ng contact sa DOI 10.1000/182, ISBN 978-0-306-40615-7 at IPv4 address 192.0.2.10 mula sa pahina 2. Tinutukoy ng column na Uri ang bawat value. Mag-filter sa isang nauugnay na salita o identifier bago kopyahin o i-download ang isang mas maliit na subset.
Gamitin ang I-filter ang mga resulta upang paliitin ang listahan. Ang pagkopya at pag-download ay kasama ang lahat ng tumutugmang row, kahit na ang result table ay sumasaklaw sa ilang screen ng mga row.
I-download ang CSV o TXT
Piliin ang I-download ang CSV, pagkatapos ay gamitin ang pangunahing button na I-download sa ready screen. Ang CSV ay naglalaman ng mga column na Uri, Value, Bilang at Mga pahina. Ang TXT at Kopyahin lahat ay naglalaman ng isang value bawat linya.
Ang mga CSV value na maaaring bigyang-kahulugan bilang mga spreadsheet formula ay pinoprotektahan ng isang nangungunang apostrophe. Halimbawa, ang isang internasyonal na numero ng telepono ay nagsisimula sa isang plus sign. Gamitin ang TXT kung kailangan mo ng simpleng listahan na walang proteksyon sa spreadsheet.
Mga karaniwang tanong
Kinukuha ba nito ang anumang numero o bawat identifier?
Hindi. Ang bawat napiling kategorya ay may sariling mga panuntunan sa pagkilala. Ang IPv6, mga porsyento, presyo at numero ng payment-card ay hindi kinukuha. Suriin ang mga tugma laban sa source; ang wastong pag-format ay hindi makakapagkumpirma na ang isang contact o identifier ay umiiral.
Ano ang dapat kong gawin sa isang na-scan na PDF?
Patakbuhin muna ang PDF OCR, pagkatapos ay i-load ang kinikilalang kopya sa tool na ito. Suriin nang mabuti ang output ng OCR: ang isang maling character ay maaaring magbago ng isang address o identifier.
Ano ang mga limitasyon sa pagkuha?
Gumamit ng isang PDF na hanggang 50 MiB at 750 na pahina. Ang pagkuha ay limitado sa 20,000 na tugma sa kabuuan at 2,000 bawat pahina, na may 90-segundong badyet sa pagproseso. Nalalapat din ang mga limitasyon sa text at annotation. Kung ang isang limitasyon o hindi nababasang pahina ay nakagambala sa scan, ipapakita ng tool ang isang paunawa ng partial-results at mamarkahan ang export filename bilang partial.
Awtomatiko bang nabubuksan ang aking mga PDF link?
Hindi. Binabasa ng pagkuha ang file sa browser at hindi binibisita ang mga na-extract na destinasyon. Ang mga button ng pahina ay nagna-navigate sa loob ng preview ng PDF.
Panatilihin ang mga value at ang kanilang konteksto
Kumuha ng nakatuong listahan, suriin ang mga source na pahina, at i-download ang format na angkop sa iyong susunod na hakbang.


