

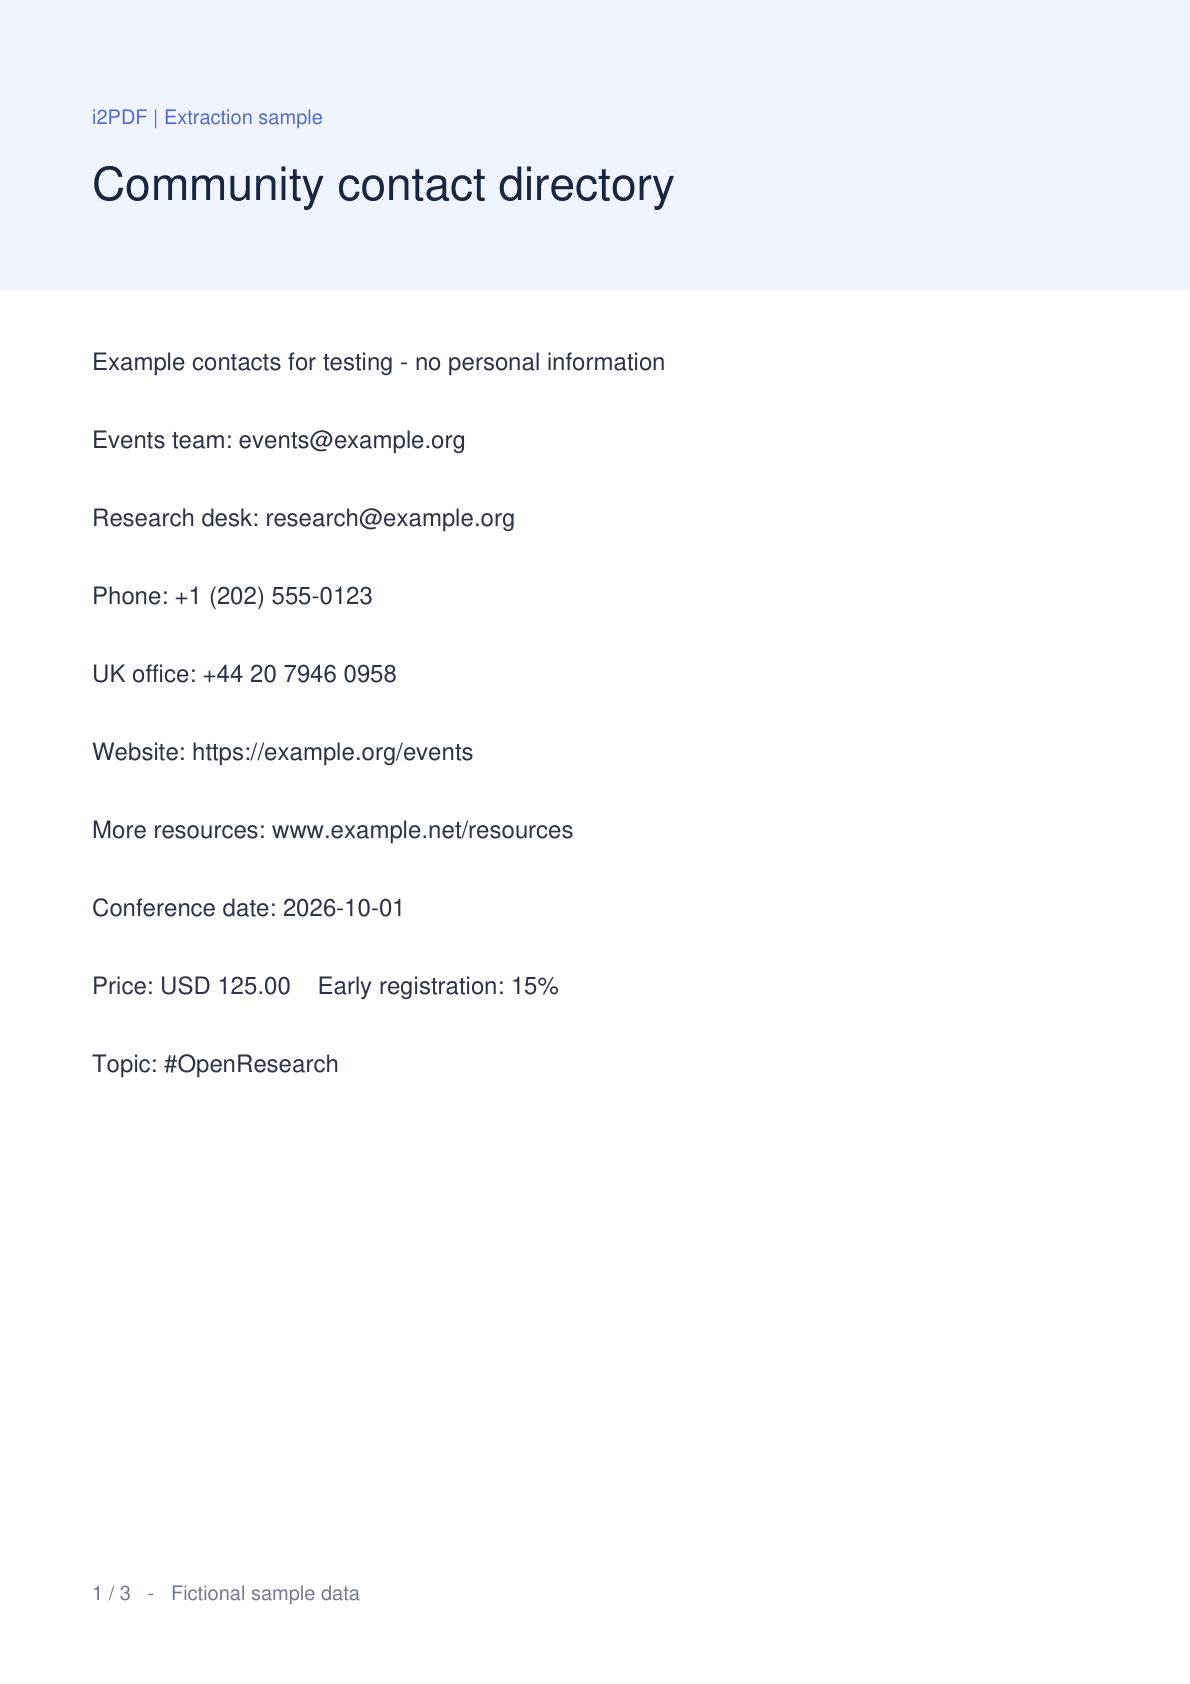
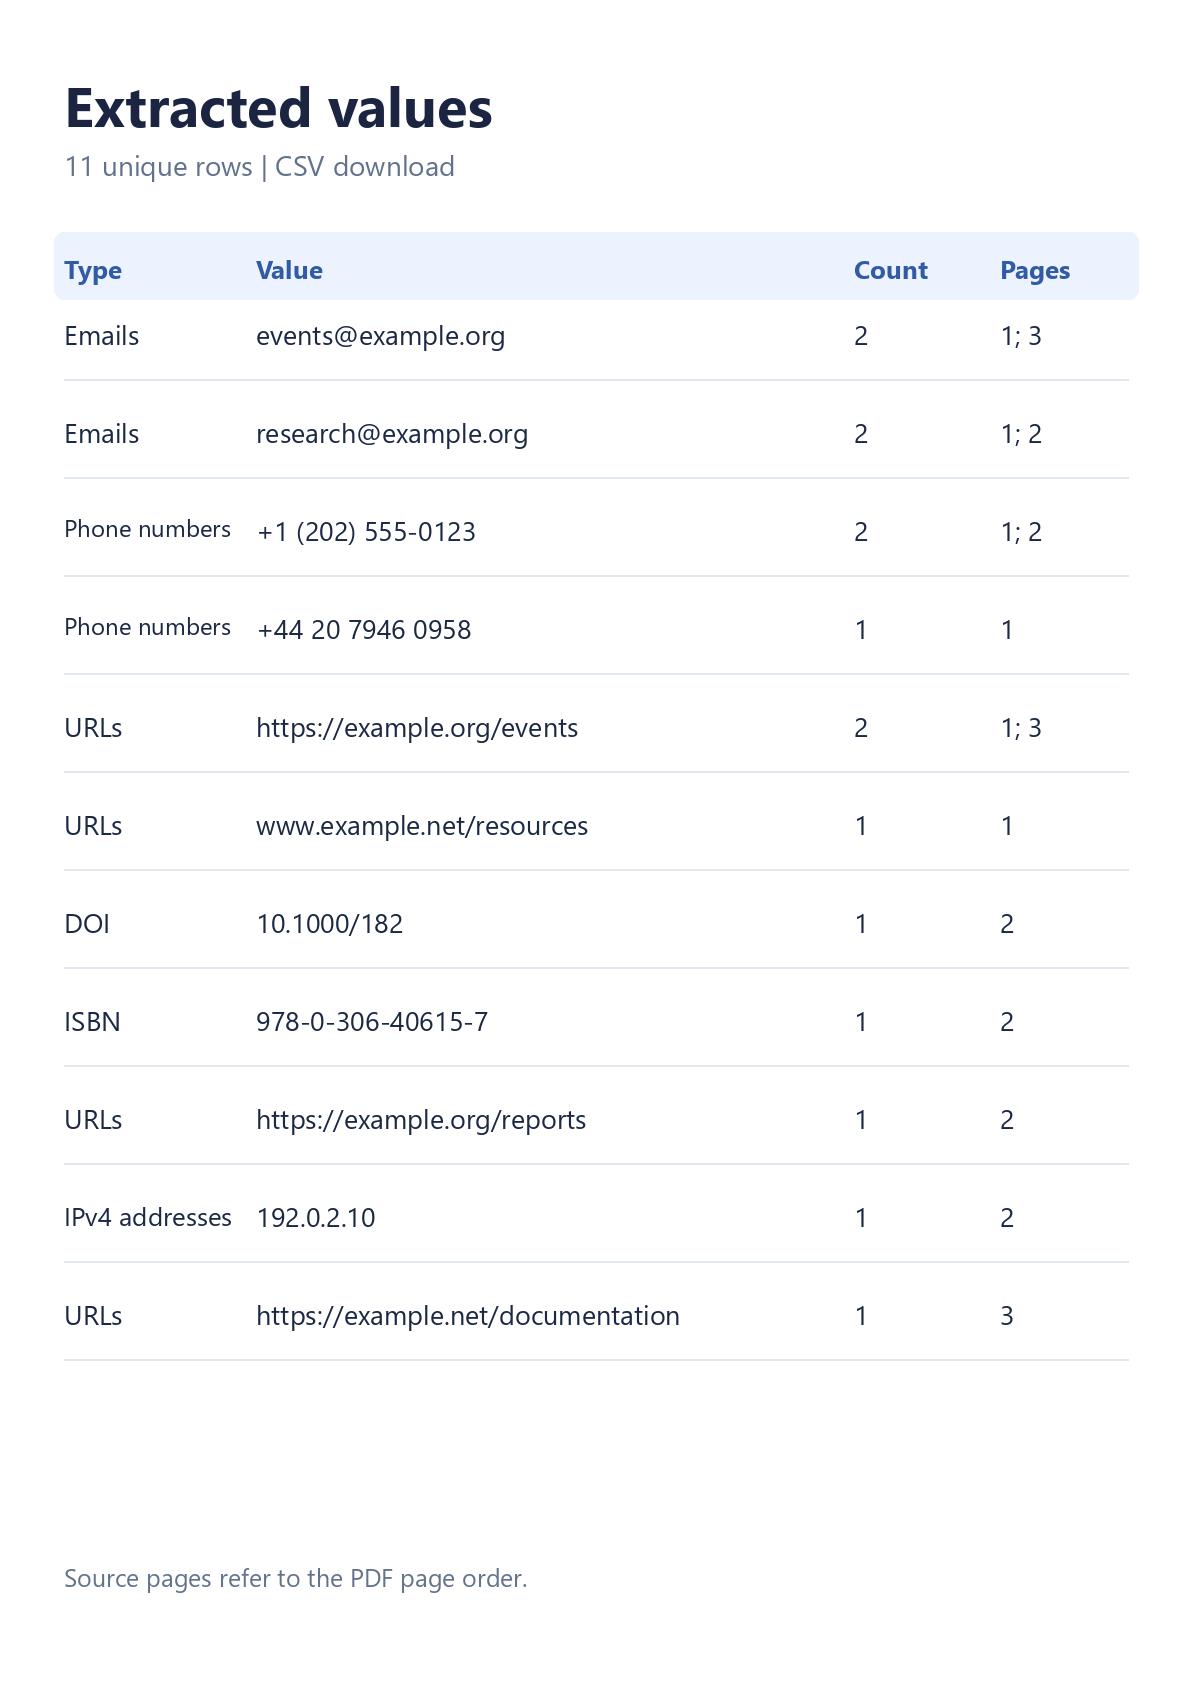

Apri Estrarre dati da PDF per raccogliere valori da un PDF senza copiarli riga per riga. Il confronto utilizza il documento di esempio reale e un CSV scaricato dallo strumento. Con email, telefoni, URL, DOI, ISBN e IPv4 selezionati, il campione di tre pagine produce 11 righe univoche da 15 occorrenze.
Apri il tuo PDF
Carica un PDF, oppure seleziona Prova l'esempio per seguire questo esempio. Appariranno l'anteprima del PDF e le miniature delle pagine. Il tuo file originale rimane invariato e l'estrazione viene eseguita nel tuo browser.
Una directory basata su testo, un rapporto, un documento di ricerca o una brochure sono un utile punto di partenza. Le scansioni composte solo da immagini necessitano di OCR prima che il loro testo stampato possa essere riconosciuto.
Scegli le opzioni utili
Su un telefono, apri Impostazioni. Su desktop, usa il pannello delle impostazioni accanto all'anteprima.
Sotto Cosa estrarre, email, numeri di telefono e URL sono selezionati all'avvio. Apri Altri tipi di dati e seleziona anche DOI, ISBN e Indirizzi IPv4. Lascia attiva la rimozione dei duplicati e scegli CSV.
Estrai e controlla le corrispondenze
Seleziona Estrai. Al termine dell'elaborazione, la scheda Risultati mostra i valori, il conteggio delle occorrenze e le pagine sorgente. Seleziona un numero di pagina circolare per ispezionarne la posizione nell'anteprima del PDF, quindi torna ai Risultati.
L'output combina l'elenco dei contatti con DOI 10.1000/182, ISBN 978-0-306-40615-7 e indirizzo IPv4 192.0.2.10 dalla pagina 2. La colonna Tipo identifica ogni valore. Filtra per una parola o un identificatore pertinente prima di copiare o scaricare un sottoinsieme più piccolo.
Usa Filtra risultati per restringere l'elenco. La copia e il download includono tutte le righe corrispondenti, anche quando la tabella dei risultati si estende su diverse schermate di righe.
Scarica CSV o TXT
Seleziona Scarica CSV, quindi usa il pulsante principale Scarica nella schermata di pronto. Il CSV contiene le colonne Tipo, Valore, Conteggio e Pagine. TXT e Copia tutto contengono un valore per riga.
I valori CSV che potrebbero essere interpretati come formule di fogli di calcolo sono protetti con un apostrofo iniziale. Ad esempio, un numero di telefono internazionale inizia con un segno più. Usa TXT se hai bisogno di un elenco semplice senza protezione per fogli di calcolo.
Domande comuni
Questo strumento estrae qualsiasi numero o ogni identificatore?
No. Ogni categoria selezionata ha le proprie regole di riconoscimento. IPv6, percentuali, prezzi e numeri di carte di pagamento non vengono estratti. Controlla le corrispondenze rispetto alla fonte; una formattazione valida non può confermare che un contatto o un identificatore esista.
Cosa dovrei fare con un PDF scansionato?
Esegui prima PDF OCR, quindi carica la copia riconosciuta in questo strumento. Controlla attentamente l'output OCR: un carattere errato può modificare un indirizzo o un identificatore.
Quali sono i limiti di estrazione?
Usa un PDF fino a 50 MiB e 750 pagine. L'estrazione è limitata a 20,000 corrispondenze totali e 2,000 per pagina, con un budget di elaborazione di 90 secondi. Si applicano anche limiti di testo e annotazioni. Se un limite o una pagina illeggibile interrompe la scansione, lo strumento mostra un avviso di risultati parziali e contrassegna il nome del file di esportazione come parziale.
I miei link PDF vengono aperti automaticamente?
No. L'estrazione legge il file nel browser e non visita le destinazioni estratte. I pulsanti di pagina navigano all'interno dell'anteprima del PDF.
Mantieni i valori e il loro contesto
Estrai un elenco mirato, controlla le pagine sorgente e scarica il formato adatto al tuo prossimo passaggio.


