

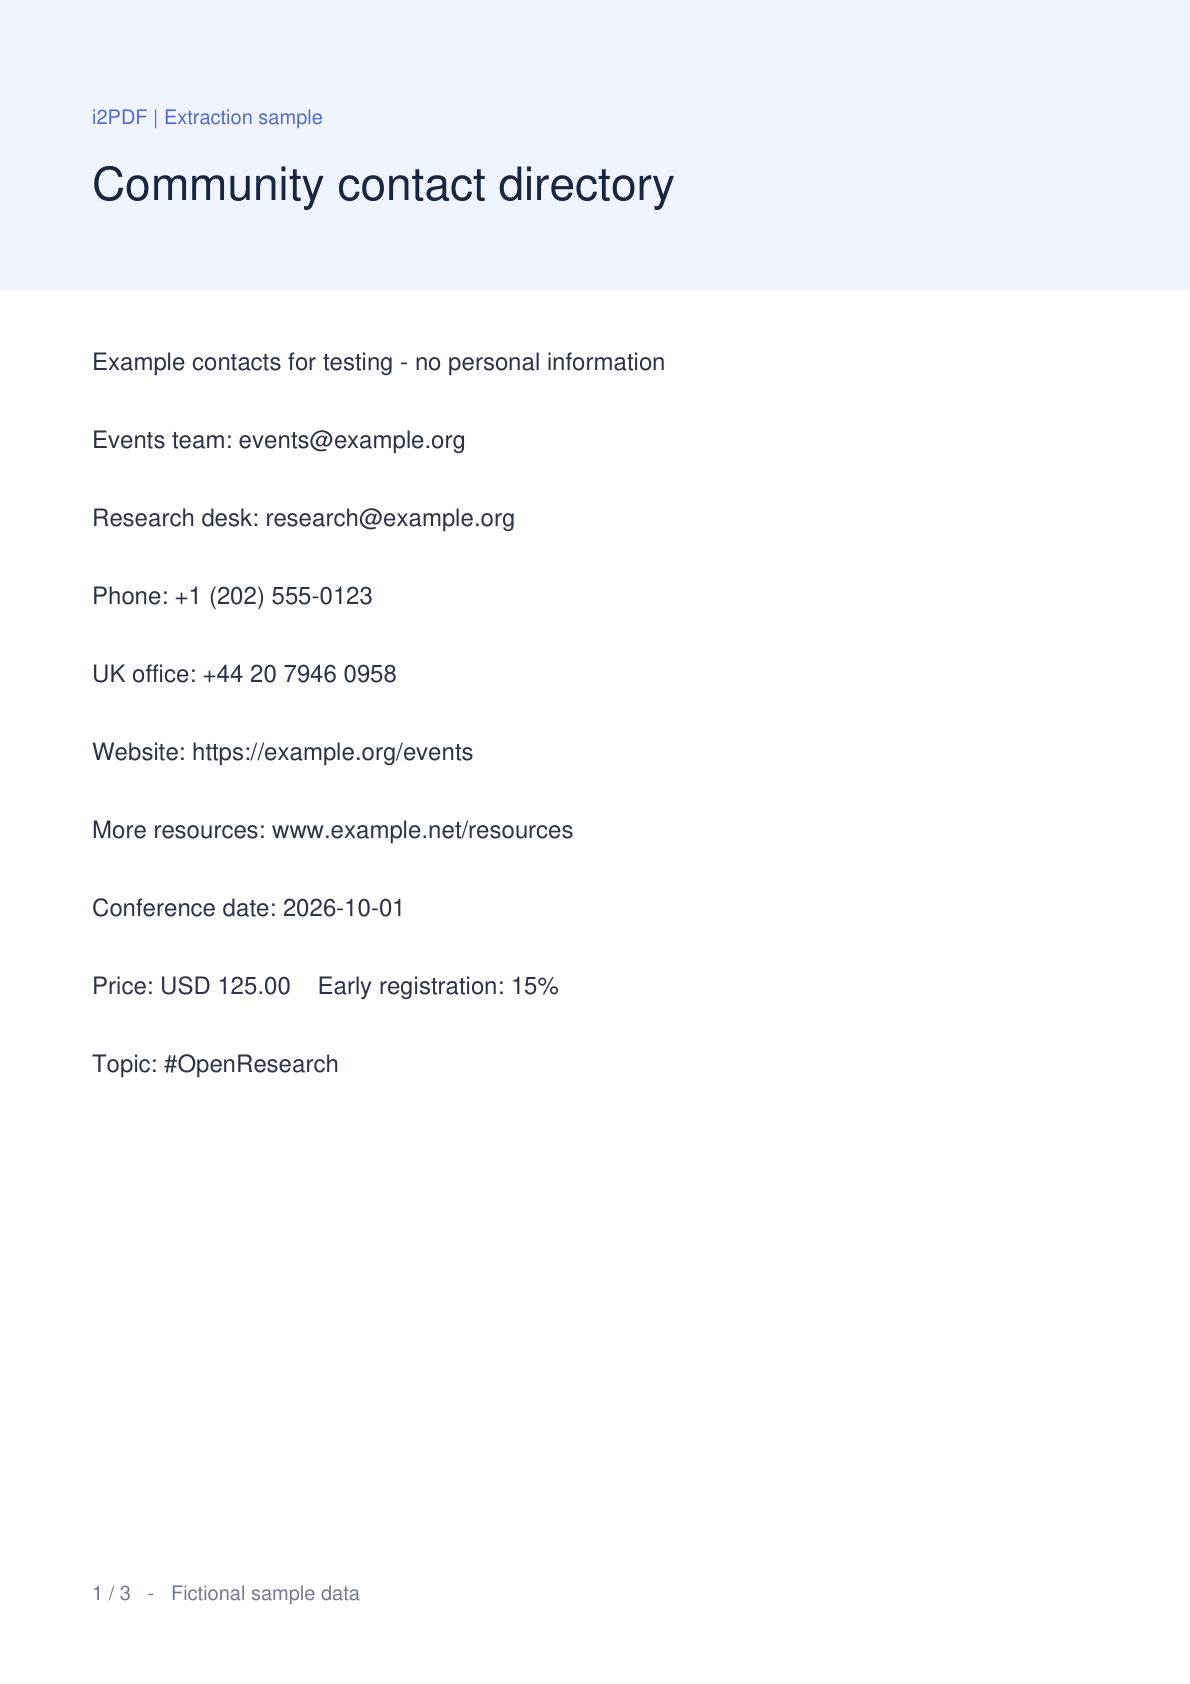
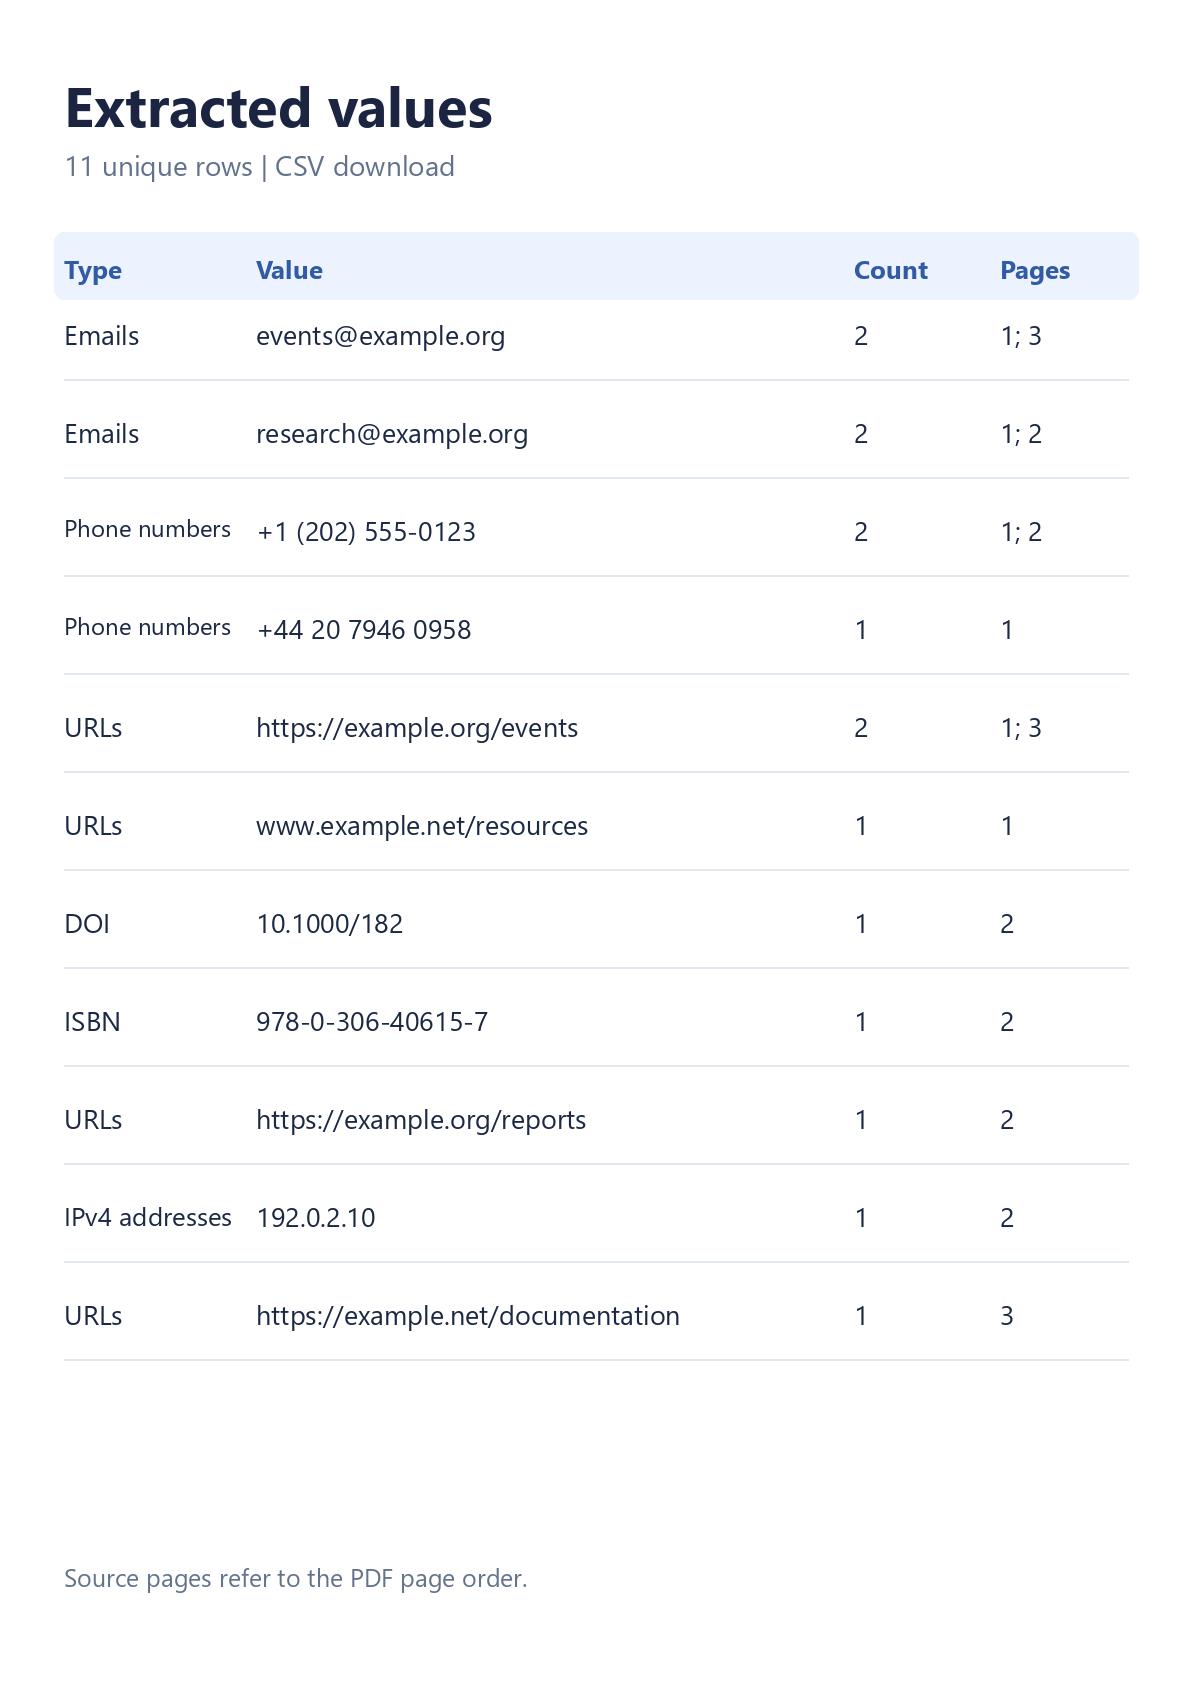

PDFからデータを抽出を開くと、PDFから値を1行ずつコピーすることなく収集できます。比較には実際のサンプルドキュメントと、ツールからダウンロードしたCSVを使用します。メールアドレス、電話番号、URL、DOI、ISBN、IPv4を選択すると、3ページのサンプルから15件の出現箇所に基づき11件のユニークな行が生成されます。
PDFを開く
PDFを1つアップロードするか、サンプルを試すを選択してこの例に従ってください。PDFのプレビューとページのサムネイルが表示されます。元のファイルは変更されず、抽出はブラウザ内で実行されます。
テキストベースのディレクトリ、レポート、研究論文、パンフレットなどが適した出発点です。画像のみのスキャンデータは、印刷されたテキストを認識するためにOCRが必要です。
便利なオプションを選択
スマートフォンの場合は設定を開きます。デスクトップの場合は、プレビューの横にある設定パネルを使用します。
抽出対象では、メールアドレス、電話番号、URLが初期状態で選択されています。その他のデータ型を開き、DOI、ISBN、IPv4アドレスも選択します。重複の削除は有効のままにし、CSVを選択します。
抽出して一致を確認
抽出を選択します。処理が完了すると、結果タブに値、出現回数、ソースページが表示されます。円形のページ番号を選択するとPDFプレビュー内の位置を確認でき、その後結果に戻ることができます。
出力には、連絡先リストに加え、DOI 10.1000/182、ISBN 978-0-306-40615-7、および2ページ目のIPv4アドレス 192.0.2.10が含まれます。「タイプ」列で各値を識別します。コピーやダウンロードを行う前に、関連する単語や識別子でフィルタリングしてサブセットを絞り込むことができます。
結果をフィルタリング…を使用してリストを絞り込みます。コピーやダウンロードには、結果テーブルが複数画面にわたる場合でも、一致するすべての行が含まれます。
CSVまたはTXTをダウンロード
CSVをダウンロードを選択し、準備完了画面のメインのダウンロードボタンを使用します。CSVには「タイプ」、「値」、「件数」、「ページ」の列が含まれます。TXTおよびすべてコピーは、1行に1つの値を含みます。
スプレッドシートの数式として解釈される可能性のあるCSV値は、先頭にアポストロフィを付けて保護されます。例えば、国際電話番号はプラス記号で始まります。スプレッドシート保護なしの単純なリストが必要な場合は、TXTを使用してください。
よくある質問
あらゆる数字や識別子を抽出しますか?
いいえ。選択された各カテゴリには独自の認識ルールがあります。IPv6、パーセンテージ、価格、支払いカード番号は抽出されません。ソースと照らし合わせて一致を確認してください。有効な形式であっても、その連絡先や識別子が存在することを保証するものではありません。
スキャンされたPDFはどうすればよいですか?
まずPDF OCRを実行してから、認識されたコピーをこのツールに読み込んでください。OCRの出力を注意深く確認してください。文字の誤認識により、アドレスや識別子が変更される可能性があります。
抽出の制限は何ですか?
最大50 MiB、750ページまでのPDFを1つ使用してください。抽出は全体で20,000件、1ページあたり2,000件まで、処理時間は90秒以内に制限されています。テキストや注釈の制限も適用されます。制限や読み取り不可能なページによってスキャンが中断された場合、ツールは部分的な結果の通知を表示し、エクスポートファイル名に「partial」とマークします。
PDF内のリンクは自動的に開かれますか?
いいえ。抽出はブラウザ内でファイルを読み取るだけであり、抽出されたリンク先にはアクセスしません。ページボタンはPDFプレビュー内での移動に使用されます。
値とそのコンテキストを保持
目的のリストを抽出し、ソースページを確認し、次のステップに適した形式でダウンロードします。


