

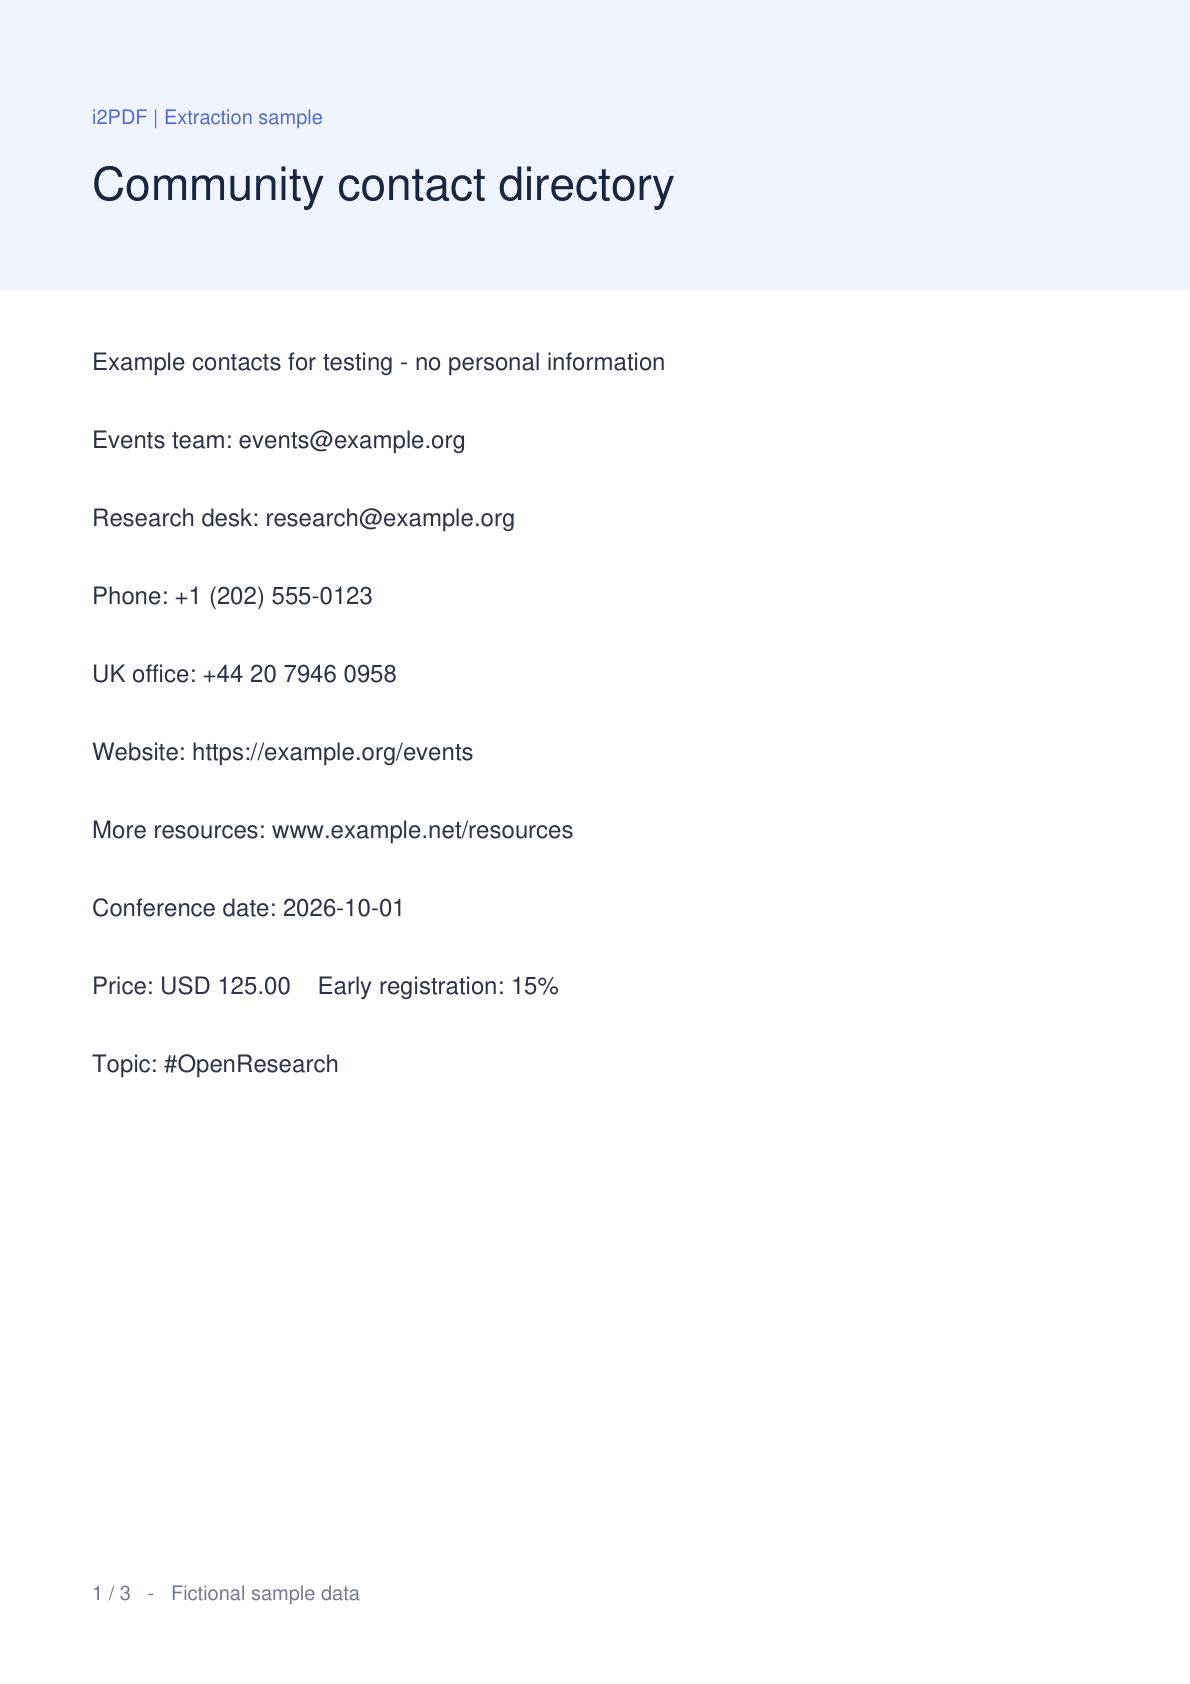
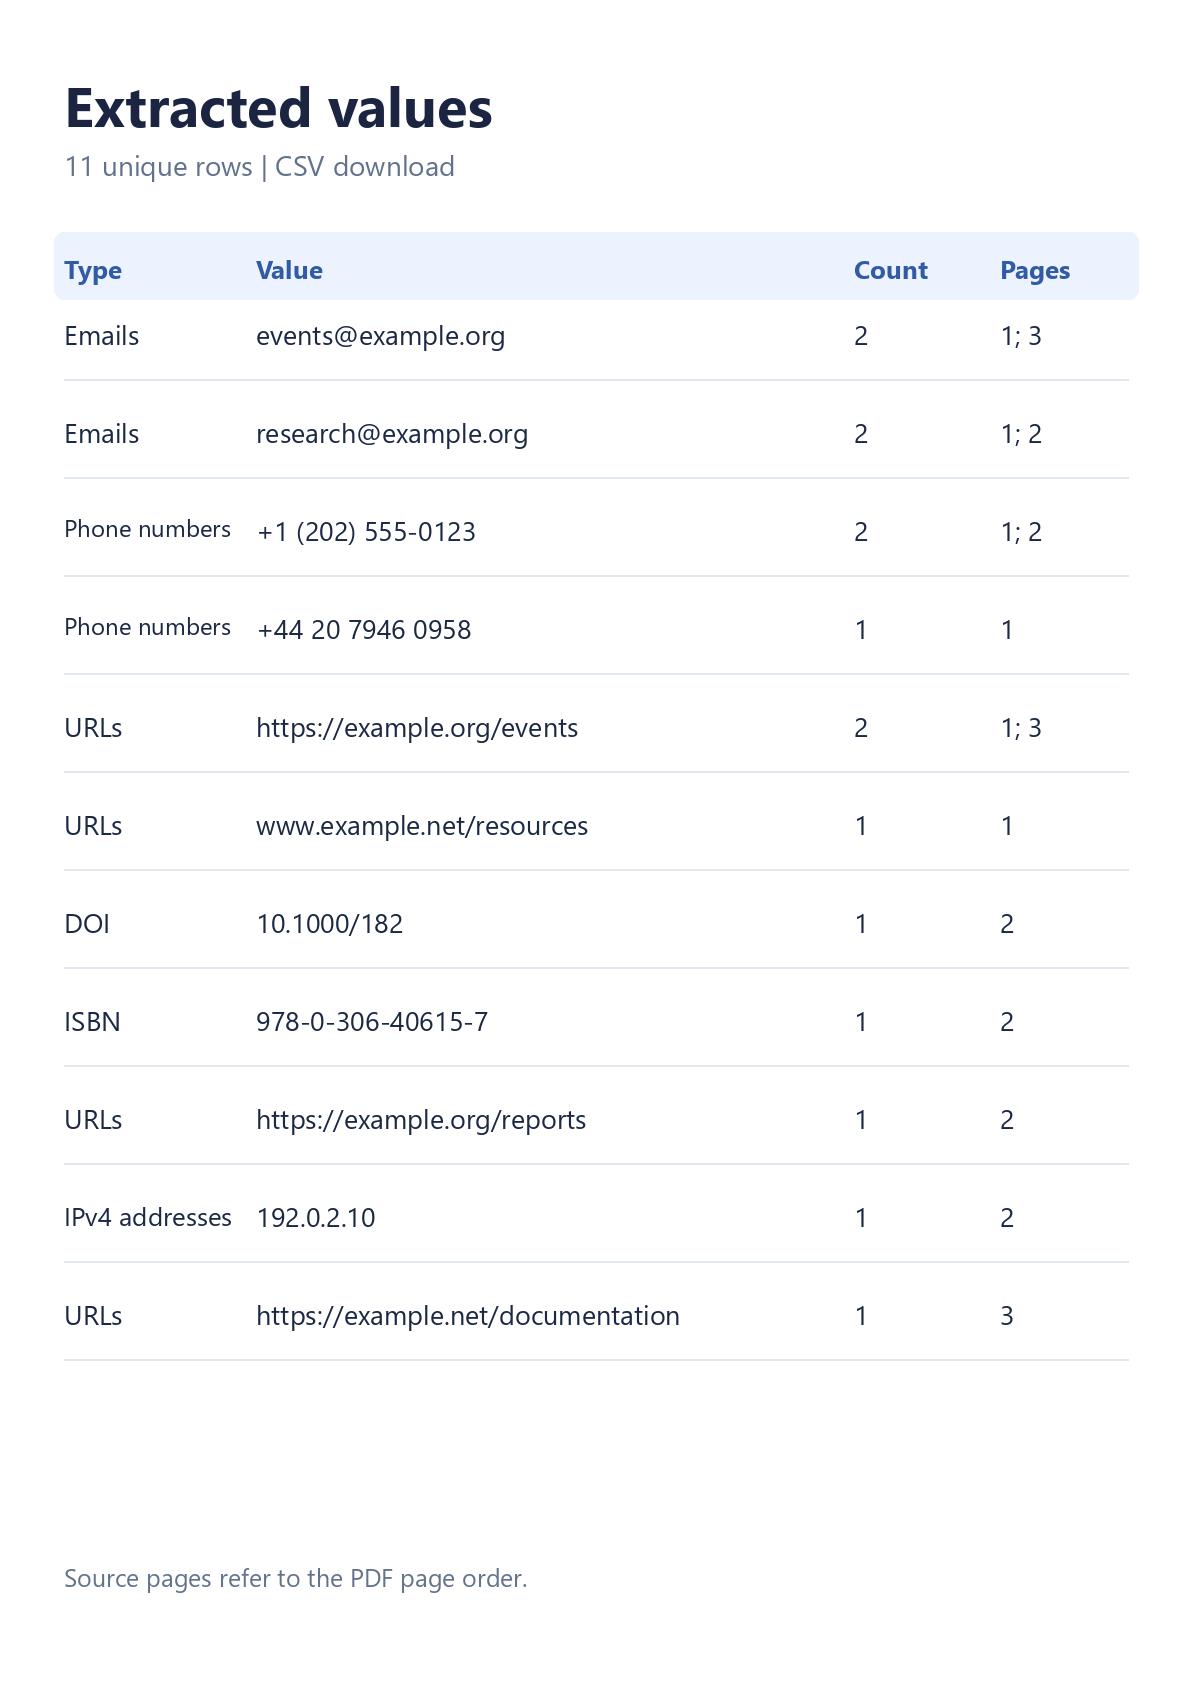

Otwórz Wyodrębnianie danych z pliku PDF, aby zebrać wartości z jednego pliku PDF bez kopiowania ich wiersz po wierszu. Porównanie wykorzystuje rzeczywisty przykładowy dokument oraz plik CSV pobrany z narzędzia. Przy wybranych e-mailach, telefonach, adresach URL, DOI, ISBN i IPv4, trzy-stronicowy przykład generuje 11 unikalnych wierszy z 15 wystąpień.
Otwórz swój plik PDF
Prześlij jeden plik PDF lub wybierz Wypróbuj przykład, aby śledzić ten przykład. Pojawi się podgląd PDF i miniatury stron. Twój oryginalny plik pozostaje niezmieniony, a wyodrębnianie odbywa się w Twojej przeglądarce.
Katalog tekstowy, raport, praca badawcza lub broszura to przydatny punkt wyjścia. Skanowane dokumenty zawierające tylko obrazy wymagają OCR, zanim ich drukowany tekst będzie mógł zostać rozpoznany.
Wybierz przydatne opcje
Na telefonie otwórz Ustawienia. Na komputerze użyj panelu ustawień obok podglądu.
W sekcji Co wyodrębnić e-maile, numery telefonów i adresy URL są domyślnie zaznaczone. Otwórz Więcej typów danych i zaznacz również DOI, ISBN oraz adresy IPv4. Pozostaw włączone usuwanie duplikatów i wybierz CSV.
Wyodrębnij i sprawdź dopasowania
Wybierz Wyodrębnij. Po zakończeniu przetwarzania karta Wyniki pokaże wartości, liczbę wystąpień i strony źródłowe. Wybierz numer strony w kółku, aby sprawdzić jej lokalizację w podglądzie PDF, a następnie wróć do Wyników.
Dane wyjściowe łączą listę kontaktów z DOI 10.1000/182, ISBN 978-0-306-40615-7 oraz adresem IPv4 192.0.2.10 ze strony 2. Kolumna Typ identyfikuje każdą wartość. Przefiltruj do odpowiedniego słowa lub identyfikatora przed skopiowaniem lub pobraniem mniejszego podzbioru.
Użyj Filtruj wyniki, aby zawęzić listę. Kopiowanie i pobieranie obejmuje wszystkie pasujące wiersze, nawet jeśli tabela wyników rozciąga się na kilka ekranów.
Pobierz CSV lub TXT
Wybierz Pobierz CSV, a następnie użyj głównego przycisku Pobierz na ekranie gotowości. CSV zawiera kolumny Typ, Wartość, Liczba i Strony. TXT oraz Kopiuj wszystko zawierają jedną wartość w wierszu.
Wartości CSV, które mogą być interpretowane jako formuły arkusza kalkulacyjnego, są chronione wiodącym apostrofem. Na przykład międzynarodowy numer telefonu zaczyna się od znaku plusa. Użyj TXT, jeśli potrzebujesz zwykłej listy bez ochrony arkusza kalkulacyjnego.
Częste pytania
Czy to wyodrębnia dowolną liczbę lub każdy identyfikator?
Nie. Każda wybrana kategoria ma własne zasady rozpoznawania. IPv6, wartości procentowe, ceny i numery kart płatniczych nie są wyodrębniane. Sprawdź dopasowania względem źródła; poprawne formatowanie nie potwierdza, że kontakt lub identyfikator istnieje.
Co powinienem zrobić ze skanowanym plikiem PDF?
Uruchom najpierw PDF OCR, a następnie załaduj rozpoznaną kopię do tego narzędzia. Sprawdź dokładnie wynik OCR: błędny znak może zmienić adres lub identyfikator.
Jakie są limity wyodrębniania?
Użyj jednego pliku PDF o rozmiarze do 50 MiB i 750 stron. Wyodrębnianie jest ograniczone do 20,000 dopasowań ogółem i 2,000 na stronę, z budżetem przetwarzania wynoszącym 90 sekund. Obowiązują również limity tekstu i adnotacji. Jeśli limit lub nieczytelna strona przerwie skanowanie, narzędzie wyświetli powiadomienie o częściowych wynikach i oznaczy nazwę pliku eksportu jako częściową.
Czy moje linki PDF są otwierane automatycznie?
Nie. Wyodrębnianie odczytuje plik w przeglądarce i nie odwiedza wyodrębnionych miejsc docelowych. Przyciski stron służą do nawigacji wewnątrz podglądu PDF.
Zachowaj wartości i ich kontekst
Wyodrębnij skoncentrowaną listę, sprawdź strony źródłowe i pobierz format, który pasuje do Twojego kolejnego kroku.


