

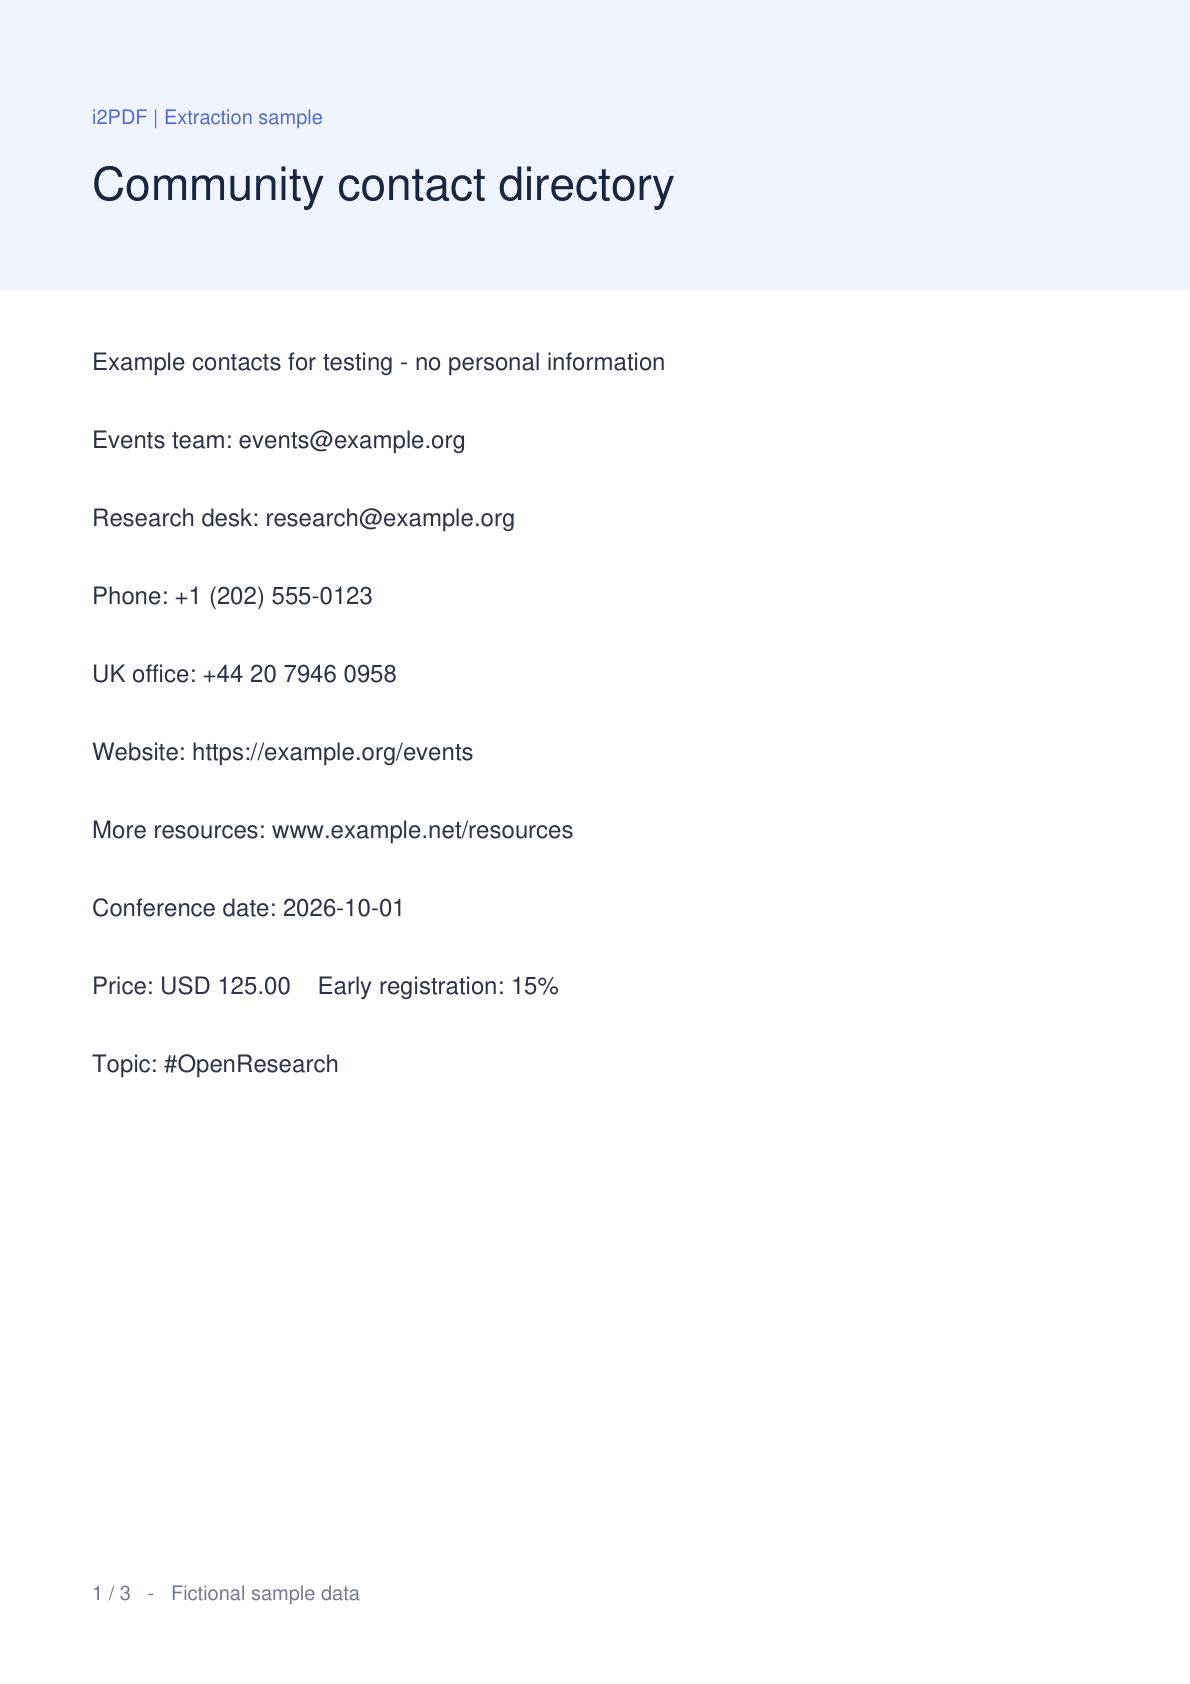
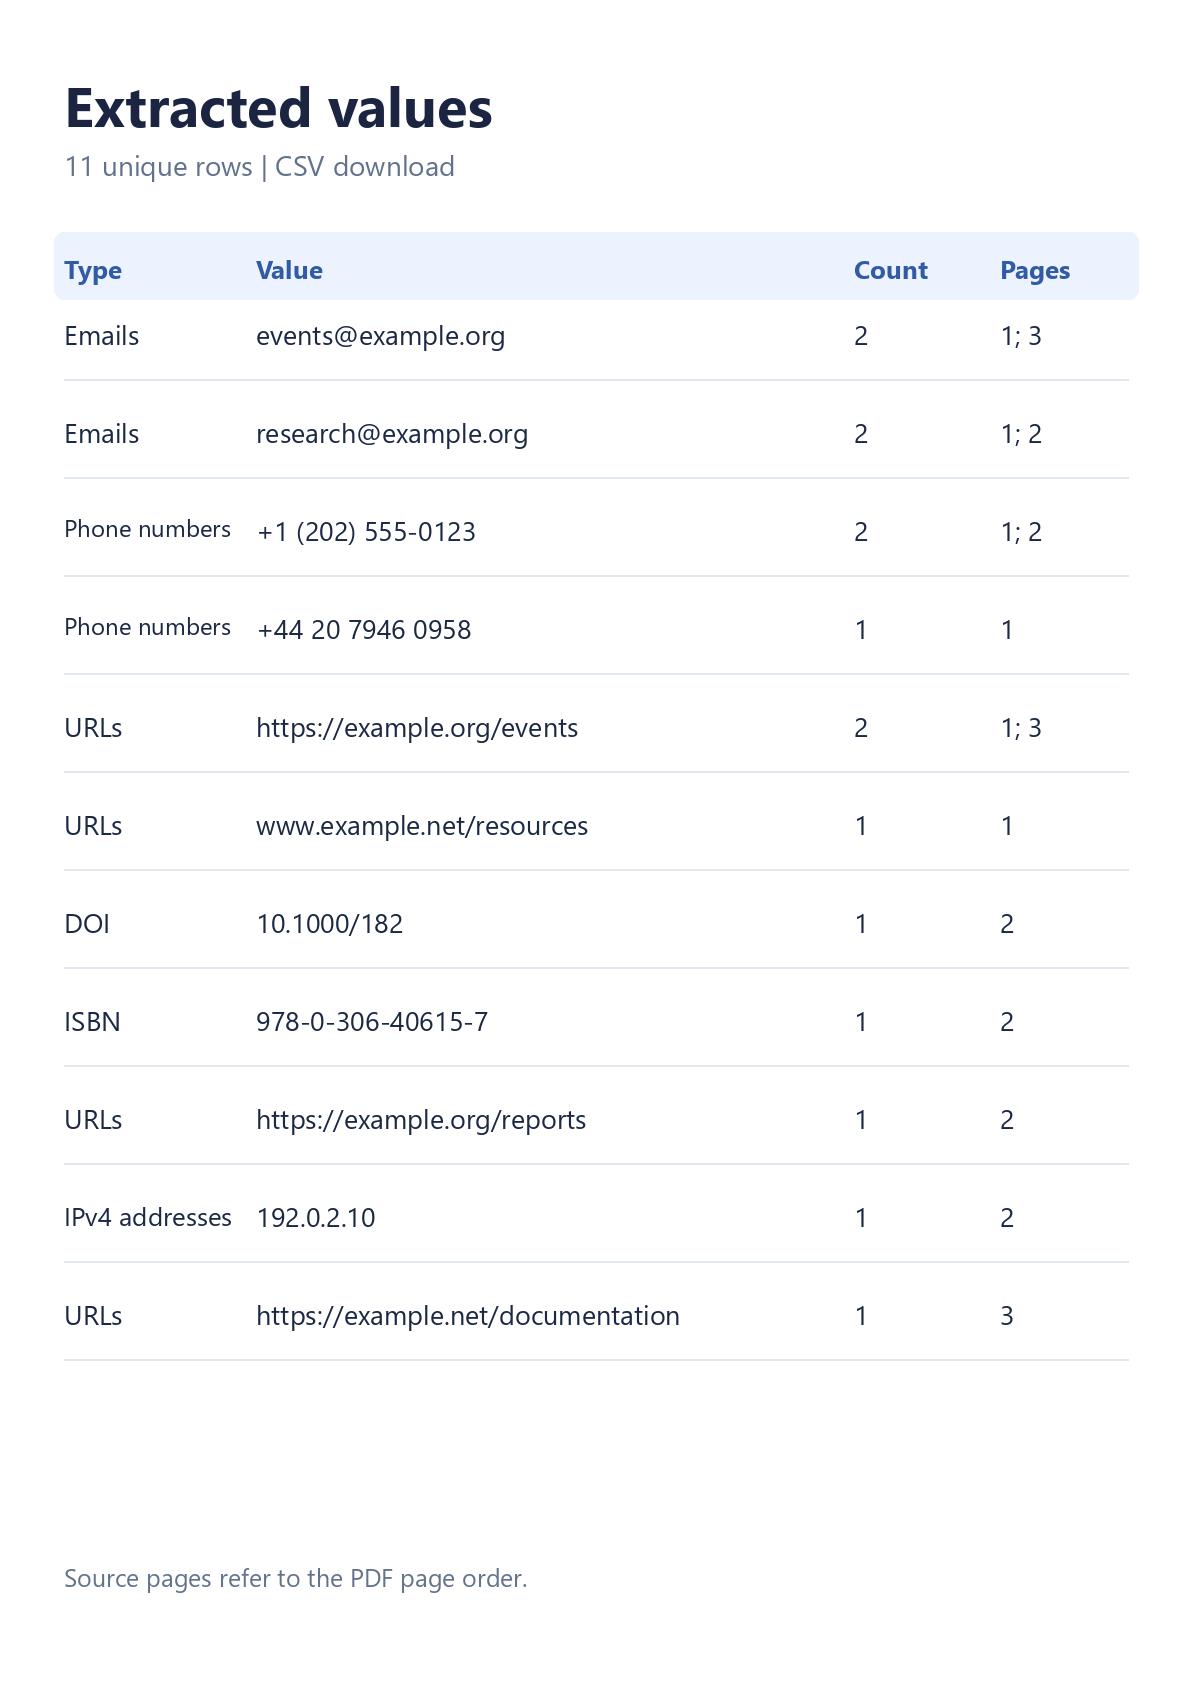

PDF에서 데이터 추출을 열어 한 줄씩 복사할 필요 없이 PDF에서 값을 수집하세요. 비교는 실제 샘플 문서와 도구에서 다운로드한 CSV를 사용합니다. 이메일, 전화번호, URL, DOI, ISBN 및 IPv4을 선택하면 15개의 발생 항목에서 11개의 고유 행이 생성됩니다.
PDF 열기
PDF 하나를 업로드하거나 샘플 시도를 선택하여 이 예제를 따라 해 보세요. PDF 미리보기와 페이지 썸네일이 나타납니다. 원본 파일은 변경되지 않으며 추출은 브라우저에서 실행됩니다.
텍스트 기반 디렉터리, 보고서, 연구 논문 또는 브로슈어는 유용한 시작점입니다. 이미지 전용 스캔 파일은 인쇄된 텍스트를 인식하기 전에 OCR이 필요합니다.
유용한 옵션 선택
휴대폰에서는 설정을 여세요. 데스크톱에서는 미리보기 옆의 설정 패널을 사용하세요.
추출할 항목 아래에서 이메일, 전화번호, URL이 기본 선택되어 있습니다. 더 많은 데이터 유형을 열고 DOI, ISBN 및 IPv4 주소도 선택하세요. 중복 제거는 활성화된 상태로 두고 CSV를 선택하세요.
일치 항목 추출 및 확인
추출을 선택하세요. 처리가 완료되면 결과 탭에 값, 발생 횟수 및 원본 페이지가 표시됩니다. 원형 페이지 번호를 선택하여 PDF 미리보기에서 해당 위치를 확인한 다음 결과로 돌아오세요.
출력물은 연락처 목록과 DOI 10.1000/182, ISBN 978-0-306-40615-7, 그리고 2 페이지의 IPv4 주소 192.0.2.10을 결합합니다. 유형 열은 각 값을 식별합니다. 더 작은 하위 집합을 복사하거나 다운로드하기 전에 관련 단어 또는 식별자로 필터링하세요.
결과 필터링을 사용하여 목록을 좁히세요. 복사 및 다운로드에는 결과 테이블이 여러 화면에 걸쳐 있더라도 일치하는 모든 행이 포함됩니다.
CSV 또는 TXT 다운로드
CSV 다운로드를 선택한 다음 준비 화면에서 기본 다운로드 버튼을 사용하세요. CSV에는 유형, 값, 개수 및 페이지 열이 포함됩니다. TXT 및 모두 복사에는 줄당 하나의 값이 포함됩니다.
스프레드시트 수식으로 해석될 수 있는 CSV 값은 앞에 아포스트로피를 붙여 보호됩니다. 예를 들어, 국제 전화번호는 더하기 기호로 시작합니다. 스프레드시트 보호 없이 일반 목록이 필요한 경우 TXT를 사용하세요.
자주 묻는 질문
이 도구는 모든 숫자나 모든 식별자를 추출하나요?
아니요. 각 선택된 카테고리에는 고유한 인식 규칙이 있습니다. IPv6, 백분율, 가격 및 결제 카드 번호는 추출되지 않습니다. 원본과 일치 항목을 검토하세요. 유효한 형식이라고 해서 연락처나 식별자가 실제로 존재하는지 확인할 수는 없습니다.
스캔된 PDF는 어떻게 해야 하나요?
PDF OCR을 먼저 실행한 다음 인식된 사본을 이 도구에 로드하세요. OCR 출력을 주의 깊게 확인하세요. 잘못된 문자 하나가 주소나 식별자를 변경할 수 있습니다.
추출 제한은 어떻게 되나요?
최대 50 MiB 및 750 페이지의 PDF 하나를 사용하세요. 추출은 전체적으로 20,000개, 페이지당 2,000개의 일치 항목으로 제한되며 90초의 처리 예산이 적용됩니다. 텍스트 및 주석 제한도 적용됩니다. 제한 사항이나 읽을 수 없는 페이지로 인해 스캔이 중단되면 도구는 부분 결과 알림을 표시하고 내보내기 파일 이름을 부분으로 표시합니다.
PDF 링크가 자동으로 열리나요?
아니요. 추출은 브라우저에서 파일을 읽으며 추출된 대상 사이트를 방문하지 않습니다. 페이지 버튼은 PDF 미리보기 내에서 탐색합니다.
값과 그 맥락 유지
집중된 목록을 추출하고 원본 페이지를 확인한 다음 다음 단계에 적합한 형식을 다운로드하세요.


