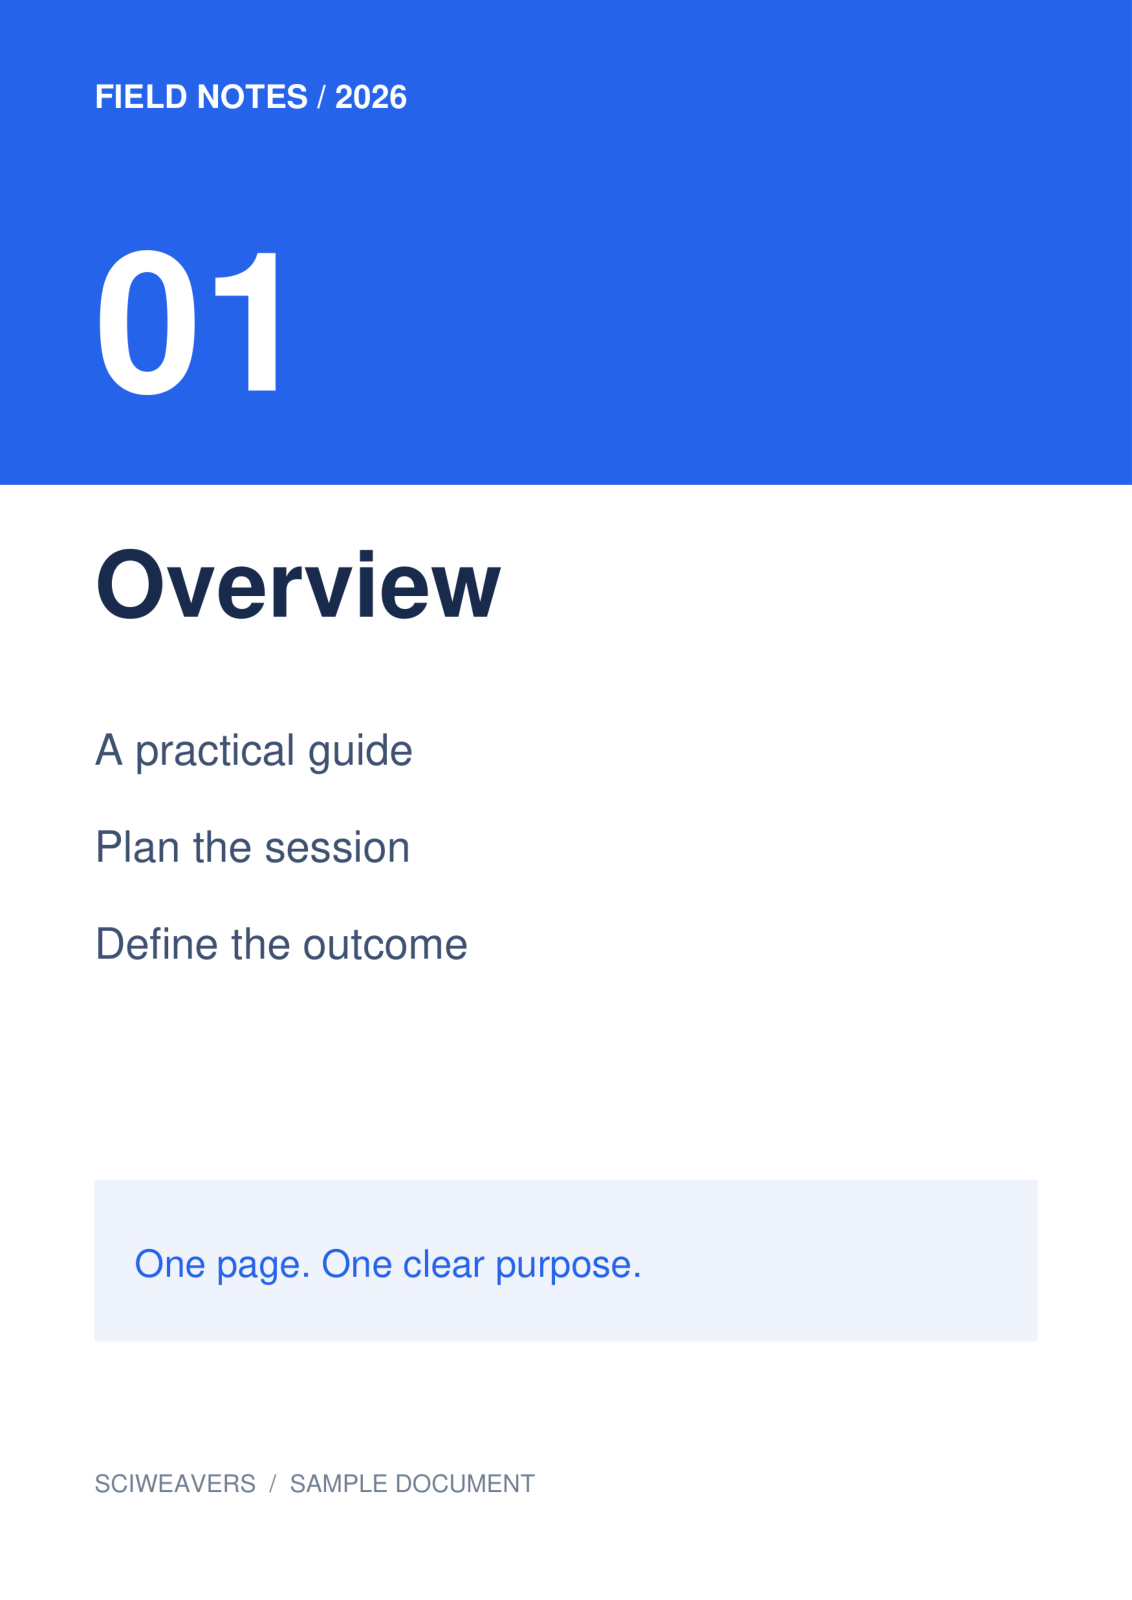
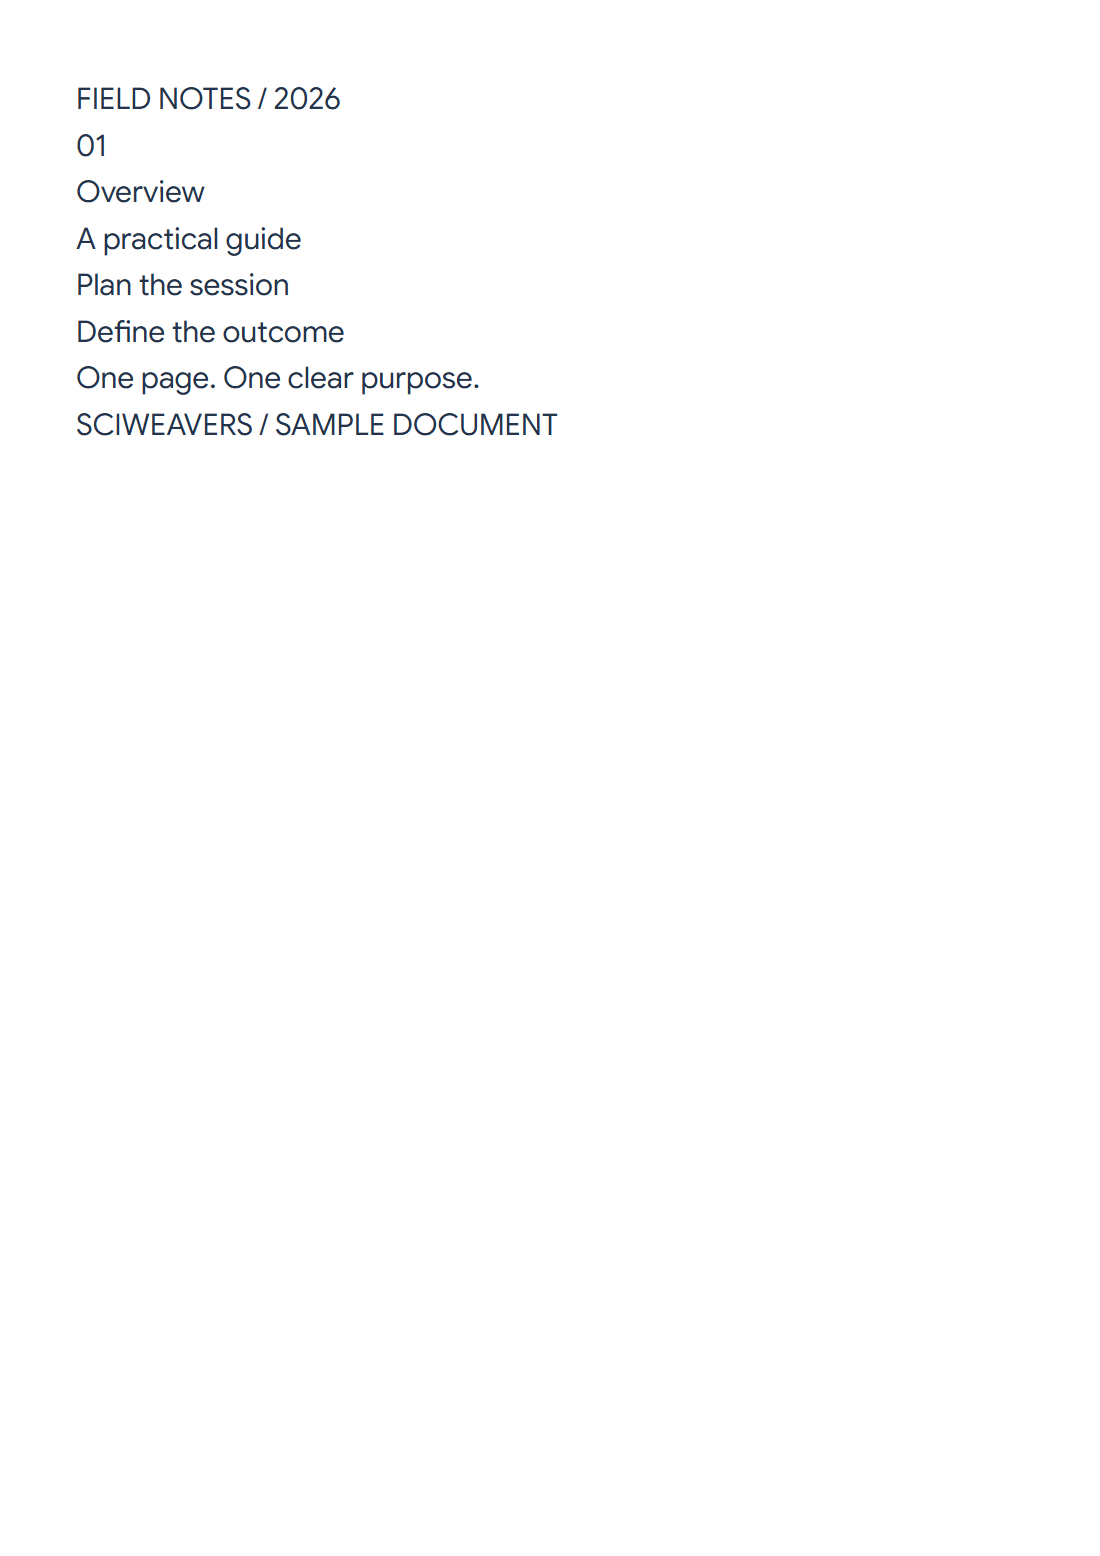

PDF OCR을 사용하여 페이지 이미지에서 단어를 인식하세요. 저희 예제는 4페이지 분량의 이미지 전용 스캔본으로 시작하여 첫 페이지인 '개요(Overview)'를 편집 가능한 텍스트로 인식합니다.
페이지 또는 영역 선택
PDF를 불러와 필요한 페이지로 이동하세요. 전체 페이지를 사용하거나 필요한 텍스트 주위로 선택 사각형을 조정하세요. 이 예제에서는 1 페이지 전체를 사용합니다.
다른 페이지나 영역을 처리하려면 별도의 인식 작업이 필요합니다. 이 도구는 업로드된 PDF의 모든 페이지를 자동으로 처리하지 않습니다.
언어, 엔진 및 형식 선택
페이지에 인쇄된 언어를 선택하세요. 영어 샘플의 경우 Future을 OCR 엔진으로 유지하고 편집 가능한 텍스트(.txt)를 선택하세요.
검색 가능한 PDF가 필요할 때는 Classic을 선택하세요. 이는 원본 이미지를 유지하면서 보이지 않는 인식 텍스트 레이어를 포함합니다. Future는 편집 가능한 텍스트, Word 및 리플로우된 텍스트 전용 PDF를 제공합니다.
인식, 수정 및 다운로드
시작을 선택하고 표시된 확인 체크박스를 완료하세요. 인식된 결과를 원본 이미지와 비교하세요. 다운로드 파일에는 '개요(Overview)', '세션 계획(Plan the session)', '결과 정의(Define the outcome)'가 올바르게 포함되어 있습니다.
텍스트를 복사하거나 다운로드하기 전에 이름, 숫자 및 불확실한 단어를 수정하세요. 수정 사항은 편집 가능한 내보내기 파일에 반영됩니다. Classic의 위치 지정형 검색 가능 PDF는 원래의 인식 결과를 유지하므로 해당 파일은 별도로 검토하세요.
스마트 편집으로 인식된 텍스트 다듬기
TXT 또는 Word 결과의 경우 복사 옆의 스마트 편집을 선택하세요. 텍스트를 작업하려면 구절을 선택하거나, 아무것도 선택하지 않으면 전체 초안이 사용됩니다. 텍스트 요약, 텍스트 의역, 문법 수정 또는 제목 제안을 선택한 다음 적응을 선택하세요. 제목 작업은 텍스트 위에 제목을 추가합니다.
AI가 변경한 모든 내용을 스캔본과 대조하여 확인하세요. 특히 이름, 숫자, 누락된 단어를 주의 깊게 살펴보세요. 제안 사항은 변경 사항 적용을 선택할 때까지 스마트 편집에 유지됩니다. TXT 및 Word 다운로드는 수정된 일반 텍스트를 사용합니다. 서식 있는 복사는 편집기 스타일이 적용된 별도의 HTML 파일을 다운로드하며, 원본 스캔본과 Classic 검색 가능 PDF의 텍스트 레이어는 변경되지 않습니다.
자주 묻는 질문
한 단락만 인식할 수 있나요?
네. 시작하기 전에 해당 영역 주위에 사각형을 선택하세요. 주변 텍스트가 포함되지 않고 중요한 단어가 잘리지 않도록 가장자리를 확인하세요.
Future는 PDF에서 원본 페이지 디자인을 유지하나요?
해당 PDF는 리플로우된 텍스트 전용 문서입니다. 텍스트 레이어가 포함된 스캔 페이지 이미지를 유지하는 것이 목적이라면 Classic의 검색 가능 PDF를 선택하세요.
스마트 편집으로 검색 가능한 PDF를 변경할 수 있나요?
아니요. 스마트 편집은 TXT 및 Word 결과에서 사용할 수 있습니다. 변경 사항 적용은 편집 가능한 텍스트를 업데이트하며, 스캔된 페이지나 이전에 생성된 검색 가능 PDF를 다시 작성하지는 않습니다.
문서로 시도해 보세요
결과를 검토한 후 필요한 버전을 저장하세요.