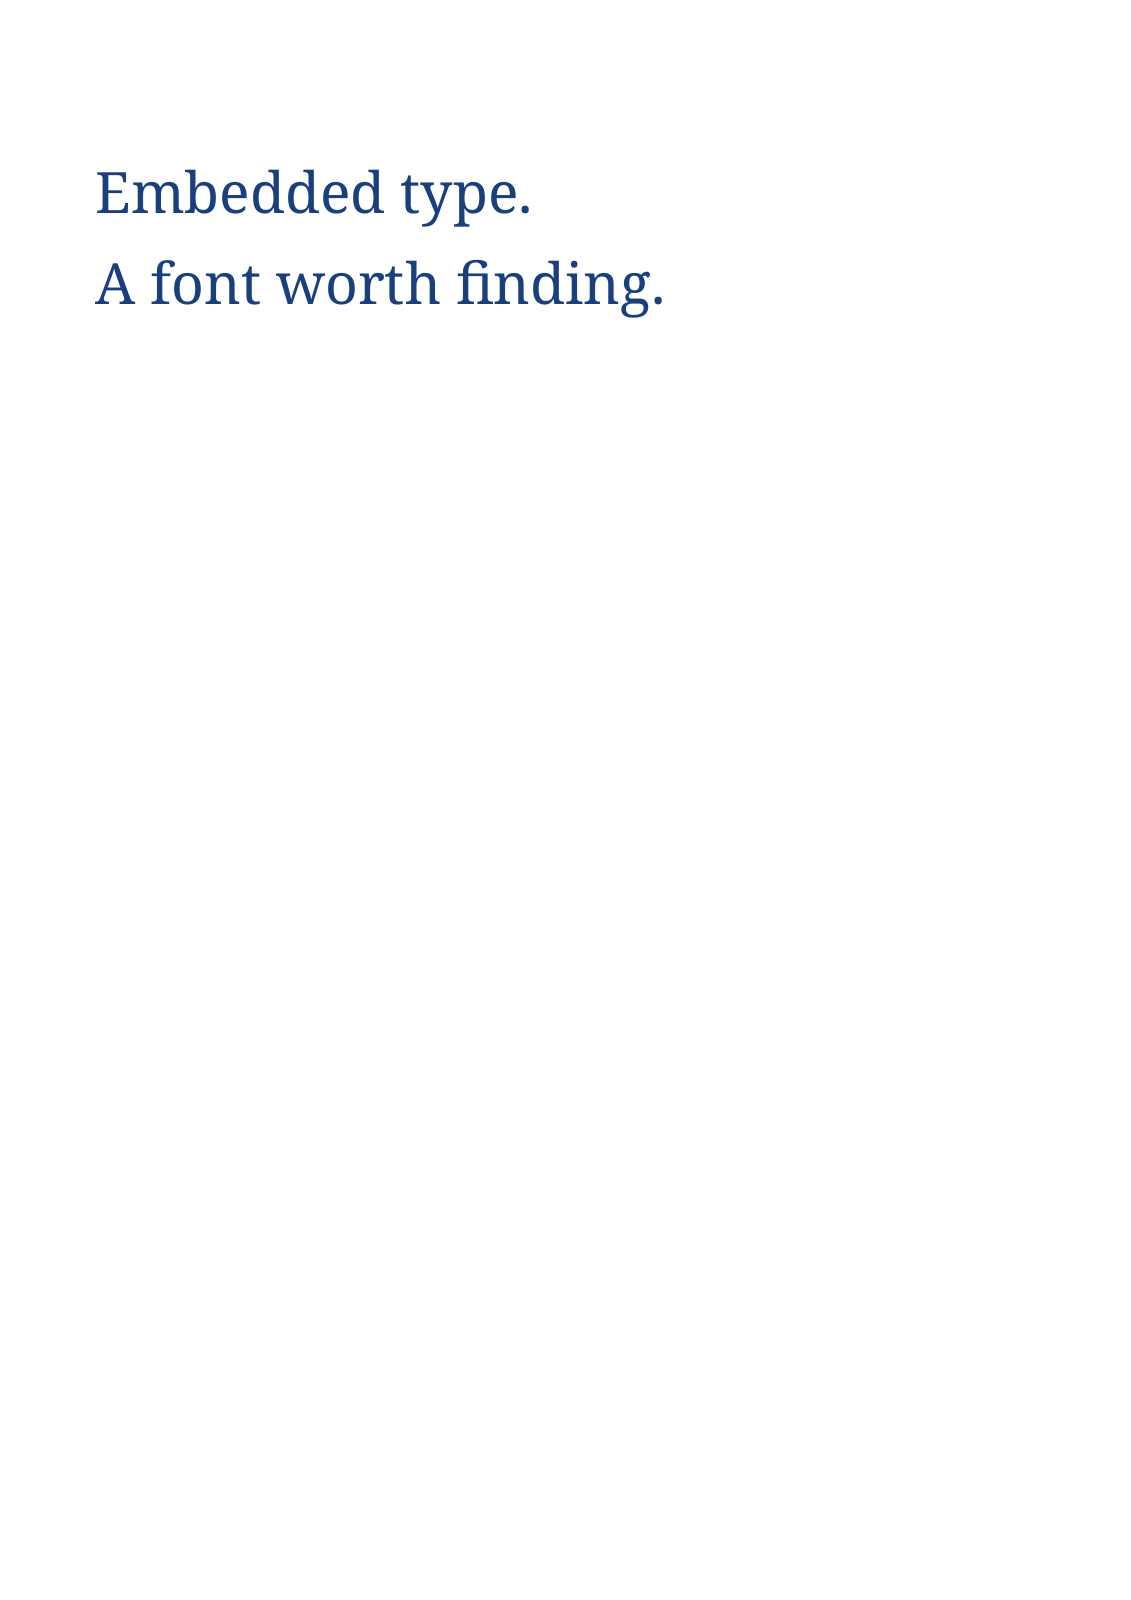
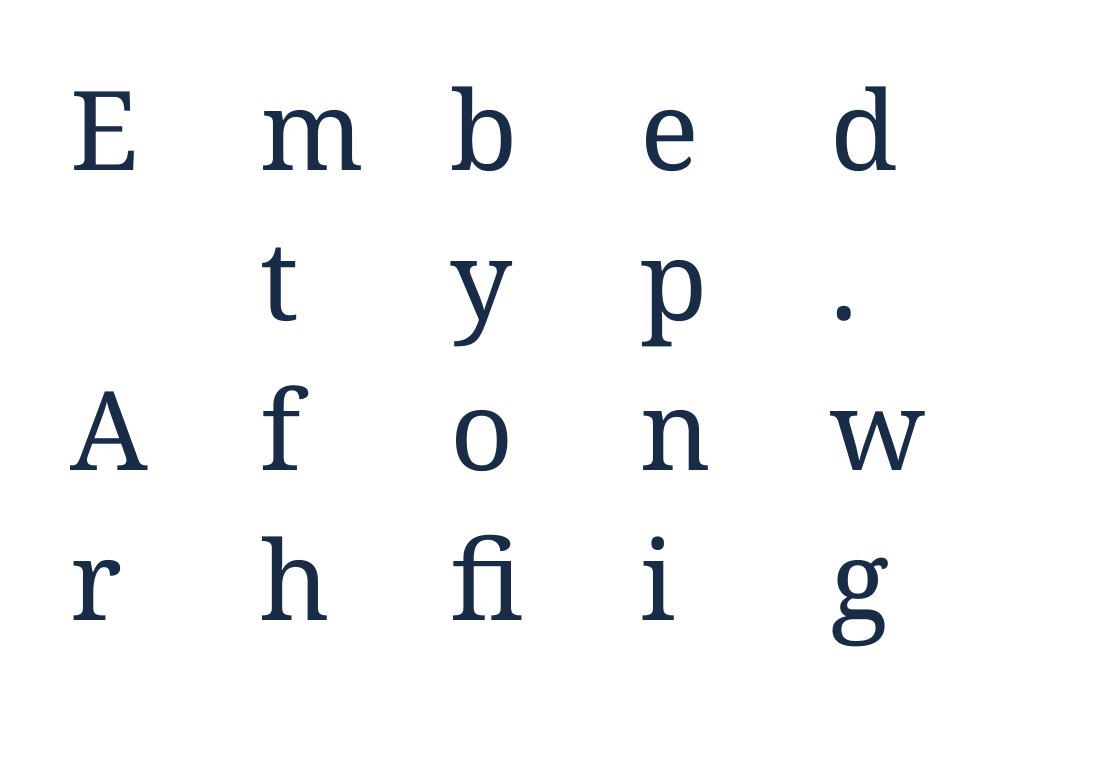

Öppna Extrahera typsnitt från PDF och lägg till ditt dokument för att upptäcka dess inbäddade typsnittsfiler. Vårt exempel ger en Noto Serif-delmängd; exemplet nedan visar de faktiska glyfkonturerna i den extraherade filen.
Lägg till PDF-filen och inspektera typsnittslistan
Ladda upp din PDF och låt verktyget hitta dess inbäddade typsnitt. Granska typsnittsnamnen i resultatlistan. Ett typsnittsnamn kan identifiera en familj även när endast en liten delmängd lagras i PDF-filen.
Vår ensidiga källfil innehåller orden “Embedded type.” och “A font worth finding.”. Dess inbäddade typsnitt har endast de glyfer som behövs för den texten.
Ladda ner ett typsnitt eller hela samlingen
Använd ett typsnitts nedladdningskontroll för att spara den posten, eller välj Start för att ladda ner de tillgängliga typsnitten tillsammans. Exempel-ZIP-filen innehåller 005-NotoSerif-Regular-9742.ttf.
Behåll de extraherade filerna tillsammans med en kopia av käll-PDF-filen så att du kan identifiera var de kom ifrån. Filändelser beror på den inbäddade typsnittsdatan.
Kontrollera vad den extraherade filen innehåller
Inspektera filen i ett typsnittsverktyg innan du förlitar dig på den i ett nytt dokument. Det här exemplet har 21 glyfposter och ingen Unicode-teckenkarta, så en vanlig typsnittsförhandsgranskning kan inte på ett tillförlitligt sätt omvandla skriven text till dessa glyfer.
Jämförelsen visar därför de faktiska konturerna som ett rutnät. Om du behöver ett användbart typsnitt för att skriva ny text, skaffa det kompletta licensierade typsnittet från dess ursprungliga distributör.
Vanliga frågor
Varför visar det nedladdade typsnittet rutor när jag skriver?
Vissa PDF-delmängder saknar normala teckenmappningar eller innehåller bara några få glyfer. Den extraherade datan kan vara giltig för PDF-filen men olämplig som ett installerat skrivbordstypsnitt.
Kan jag få hela typsnittsfamiljen från en PDF?
Endast den typsnittsdata som faktiskt är inbäddad i den PDF-filen kan återställas. Saknade stilar, vikter och tecken tillhandahålls inte genom extrahering.
Prova med ditt dokument
Granska resultatet och spara sedan den version du behöver.