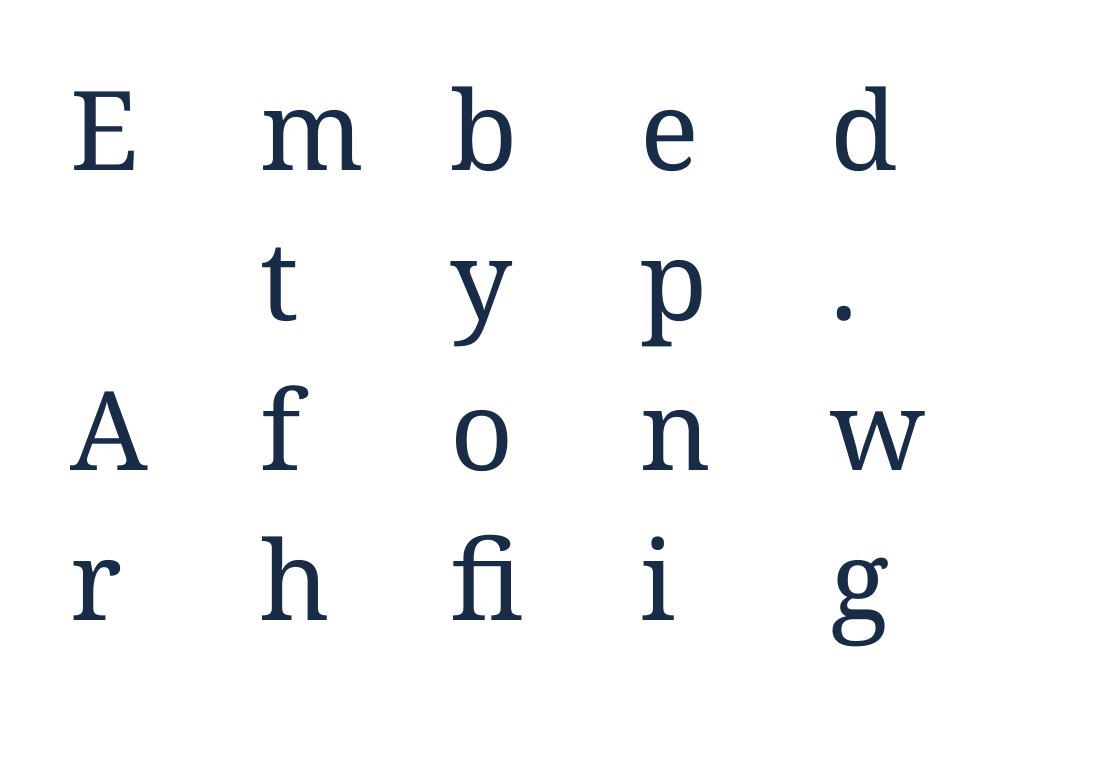

打开 从 PDF 提取字体 并添加您的文档以发现其嵌入的字体文件。我们的示例产生了一个 Noto Serif 子集;下方的示例展示了该提取文件中实际的字形轮廓。
01
添加 PDF 并检查字体列表
上传您的 PDF 并让工具查找其嵌入字体。在结果列表中查看字体名称。即使 PDF 中仅存储了很小的子集,字体名称也可以标识其字体族。
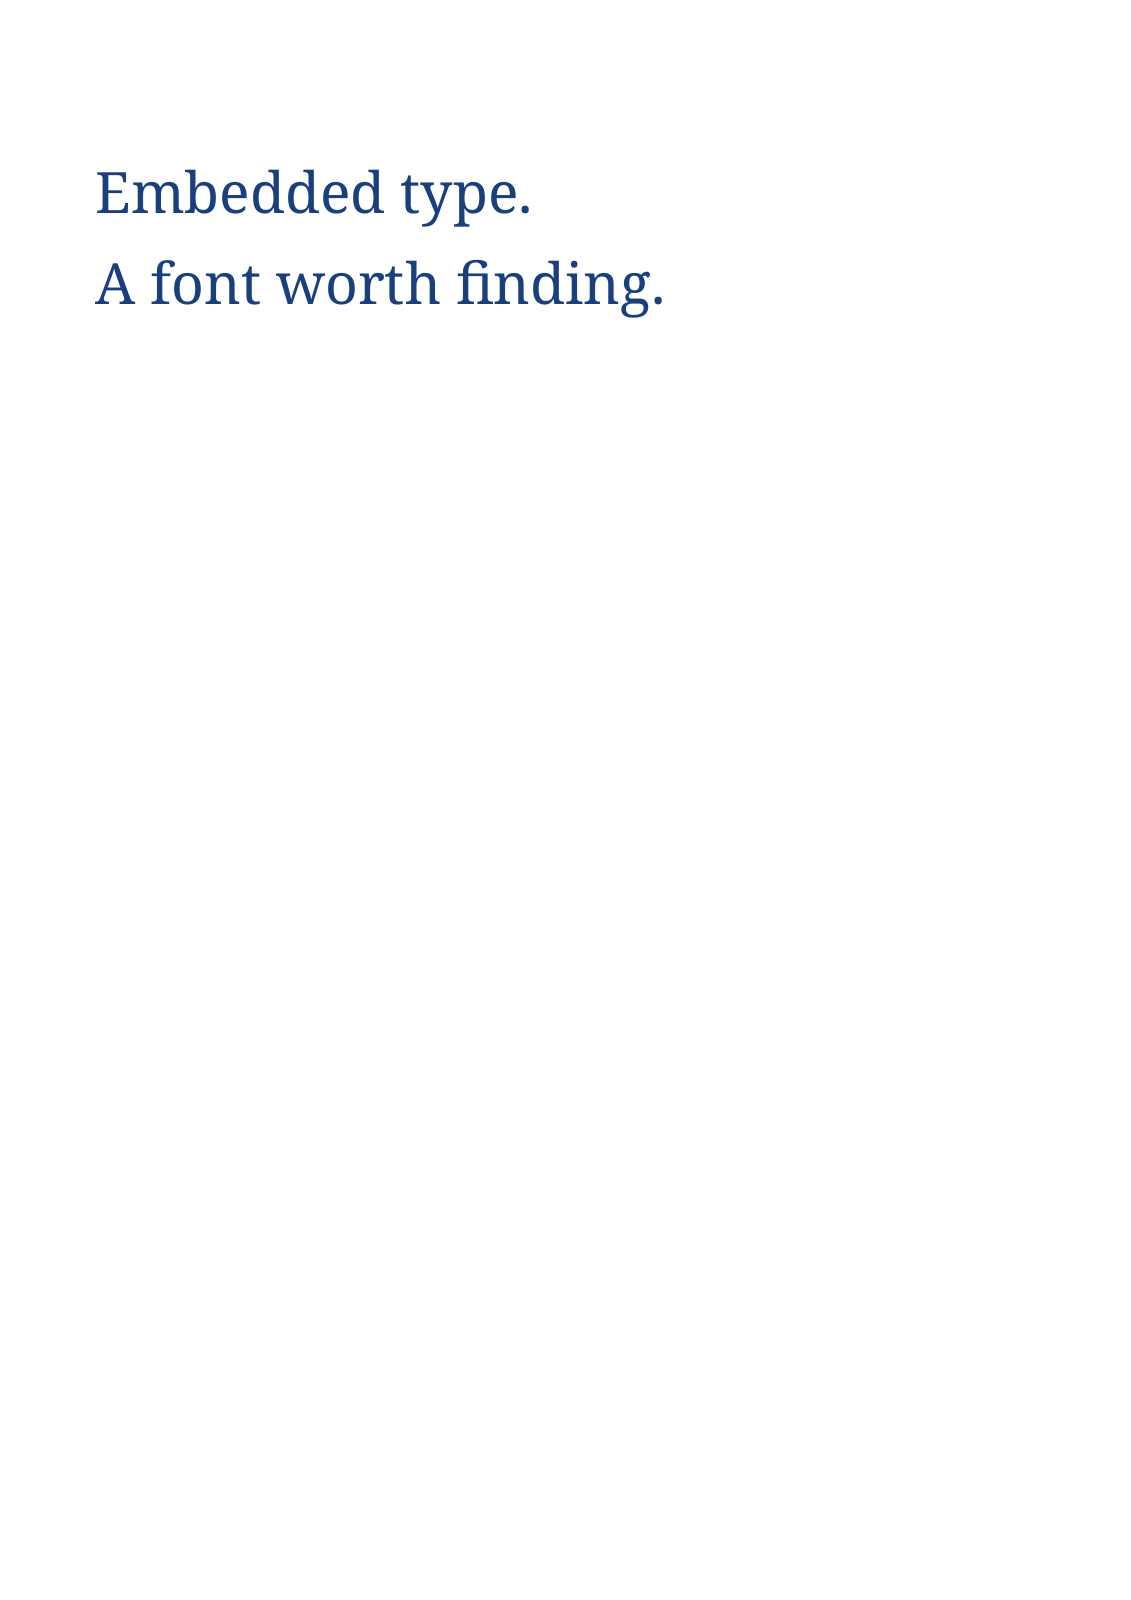
我们的一页源文档包含“Embedded type.”和“A font worth finding.”这些文字。其嵌入字体仅包含该文本所需的字形。
02
下载字体或集合
使用字体的下载控件保存该条目,或选择 开始 以同时下载所有可用字体。示例 ZIP 包含 005-NotoSerif-Regular-9742.ttf。
将提取的文件与源 PDF 的副本保存在一起,以便识别它们的来源。文件扩展名取决于嵌入的字体数据。
03
检查提取文件包含的内容
在依赖新文档使用之前,请先在字体工具中检查该文件。此示例具有 21 个字形条目且没有 Unicode 字符映射,因此普通的字体预览无法可靠地将键入的文本转换为这些字形。
因此,该对比显示了实际的轮廓网格。如果您需要用于编写新文本的可使用字体,请从原始分发商处获取完整的授权字体。
常见问题
为什么下载的字体在输入时显示方框?
一些 PDF 子集缺少正常的字符映射或仅包含少量字形。提取的数据对于 PDF 而言可能是有效的,但不适合作为已安装的桌面字体使用。
我可以从一个 PDF 中获取整个字体族吗?
只能恢复实际嵌入在该 PDF 中的字体数据。提取功能不提供缺失的样式、字重和字符。
轮到你了
打开从 PDF 提取字体 用您的文档试一试
查看结果,然后保存您需要的版本。