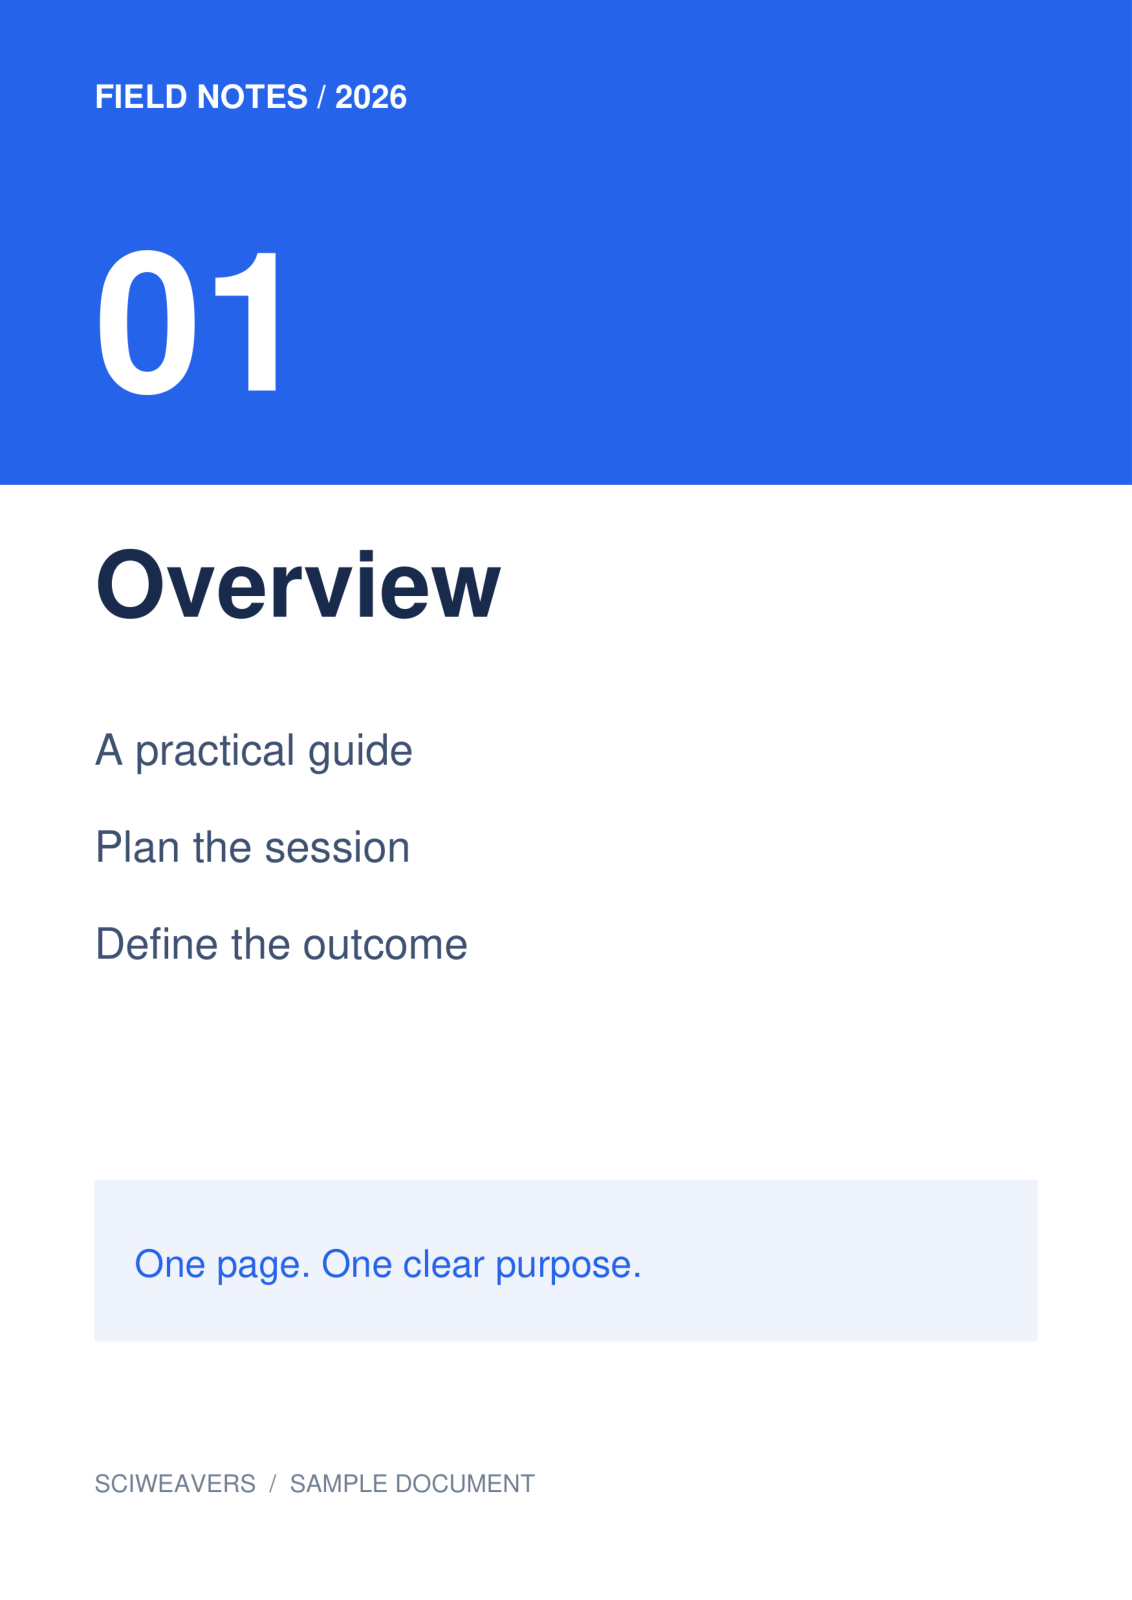
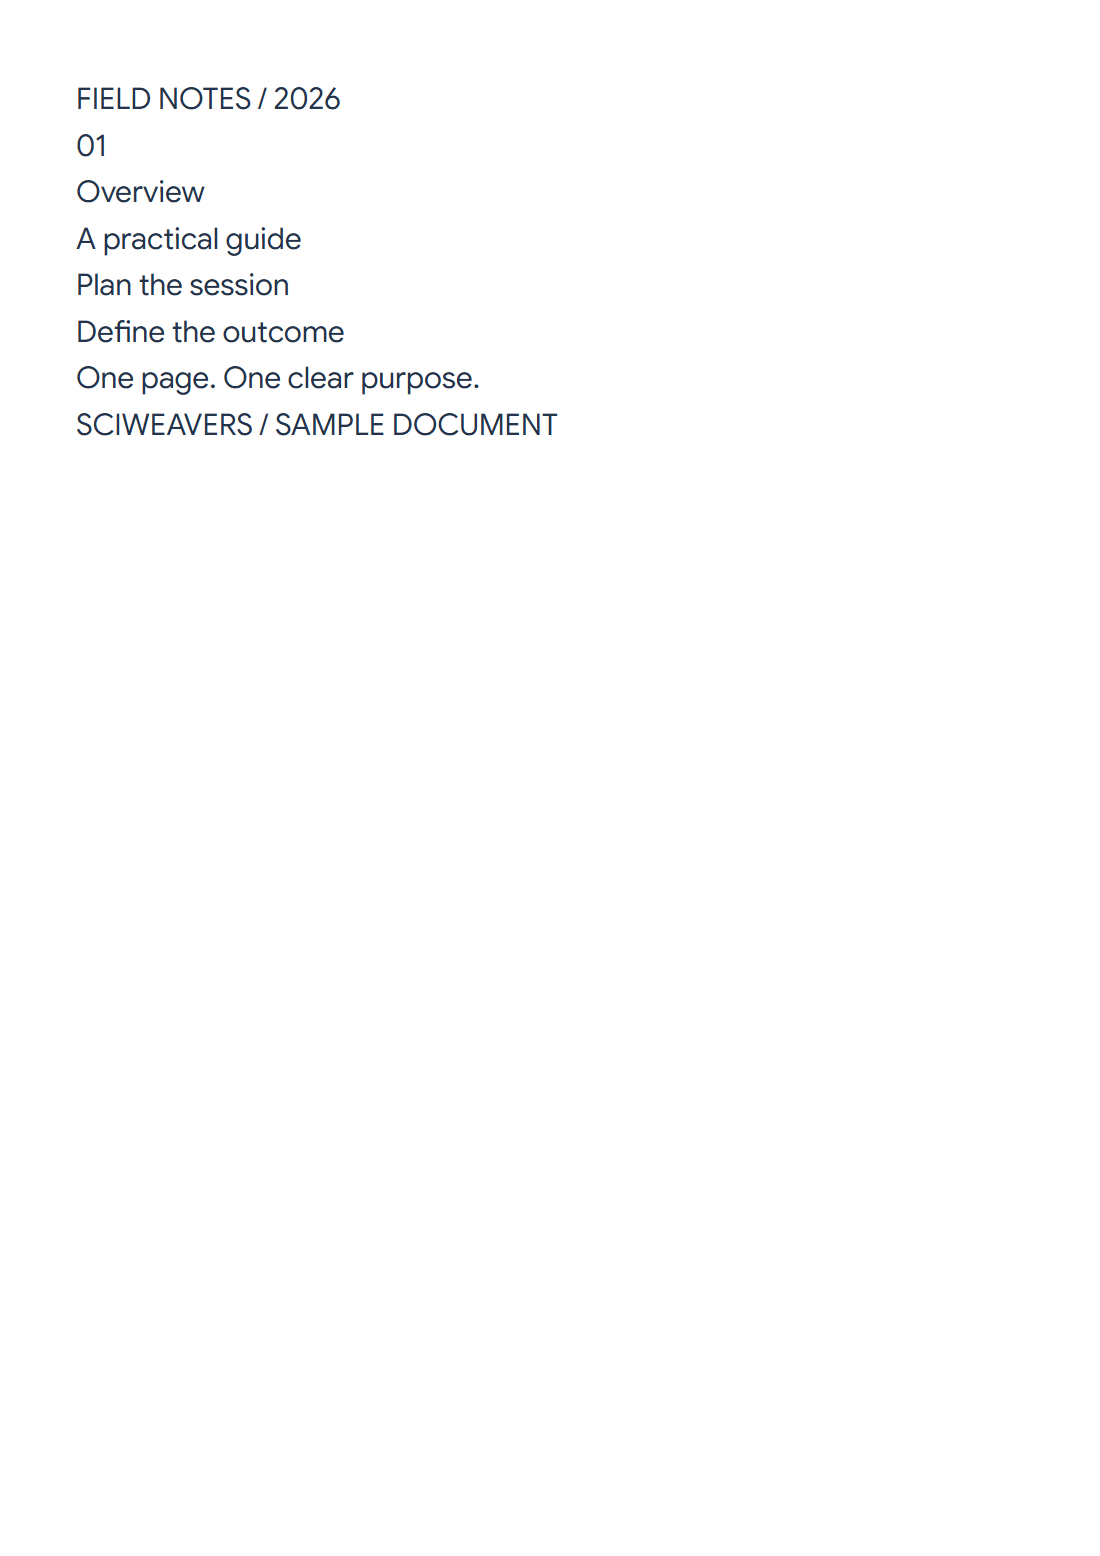

Użyj PDF OCR, aby rozpoznać słowa z obrazów stron. Nasz przykład zaczyna się od czterostronicowego skanu zawierającego tylko obrazy i rozpoznaje jego pierwszą stronę, Overview, na edytowalny tekst.
Wybierz stronę lub obszar
Załaduj plik PDF i przejdź do potrzebnej strony. Użyj całej strony lub dostosuj prostokąt zaznaczenia wokół potrzebnego tekstu. Przykład wykorzystuje całą stronę 1.
Inna strona lub obszar wymaga oddzielnej operacji rozpoznawania. Narzędzie nie przetwarza automatycznie każdej strony przesłanego pliku PDF.
Wybierz język, silnik i format
Wybierz język wydrukowany na stronie. Dla naszej angielskiej próbki zachowaj Future jako silnik OCR i wybierz Editable text (.txt).
Wybierz Classic, gdy potrzebujesz przeszukiwalnego pliku PDF, który zachowuje obraz źródłowy z niewidoczną warstwą rozpoznanego tekstu. Future zapewnia edytowalny tekst, plik Word oraz plik PDF z płynnym tekstem.
Rozpoznaj, popraw i pobierz
Wybierz Start i wypełnij wyświetlone pole wyboru weryfikacji. Porównaj rozpoznany wynik z obrazem źródłowym. Nasze pobieranie poprawnie zawiera Overview, Plan the session oraz Define the outcome.
Popraw nazwiska, liczby i niepewne słowa przed skopiowaniem lub pobraniem tekstu. Korekty aktualizują edytowalne eksporty; pozycjonowany przeszukiwalny plik PDF w trybie Classic zachowuje oryginalne rozpoznanie, więc przejrzyj ten plik osobno.
Dopracuj rozpoznany tekst za pomocą Smart edit
Aby uzyskać wynik w formacie TXT lub Word, wybierz Smart edit obok Copy. Zaznacz fragment, aby pracować nad tym tekstem, lub pozostaw zaznaczenie puste, aby użyć całego szkicu. Wybierz Summarize text, Paraphrase text, Fix grammar lub Suggest a title, a następnie wybierz Apply. Akcja tytułu dodaje nagłówek nad tekstem.
Sprawdź każdą zmianę AI względem skanu, zwłaszcza nazwiska, liczby i brakujące słowa. Sugestia pozostaje w Smart edit, dopóki nie wybierzesz Apply Changes. Pobrane pliki TXT i Word używają wtedy edytowanego zwykłego tekstu. Formatted copy pobiera oddzielny plik HTML ze stylizacją edytora; oryginalny skan i warstwa tekstowa przeszukiwalnego pliku PDF Classic nie ulegają zmianie.
Często zadawane pytania
Czy mogę rozpoznać tylko jeden akapit?
Tak. Zaznacz prostokąt wokół niego przed rozpoczęciem. Sprawdź krawędzie, aby pobliski tekst został wykluczony, a ważne słowa nie zostały ucięte.
Czy Future zachowa oryginalny układ strony w swoim pliku PDF?
Jego plik PDF to dokument z płynnym tekstem. Wybierz przeszukiwalny plik PDF w trybie Classic, gdy celem jest zachowanie obrazu skanowanej strony z warstwą tekstową.
Czy Smart edit może zmienić przeszukiwalny plik PDF?
Nie. Smart edit jest dostępny dla wyników TXT i Word. Apply Changes aktualizuje edytowalny tekst; nie nadpisuje skanowanej strony ani wcześniej wygenerowanego przeszukiwalnego pliku PDF.
Wypróbuj to ze swoim dokumentem
Przejrzyj wynik, a następnie zapisz potrzebną wersję.