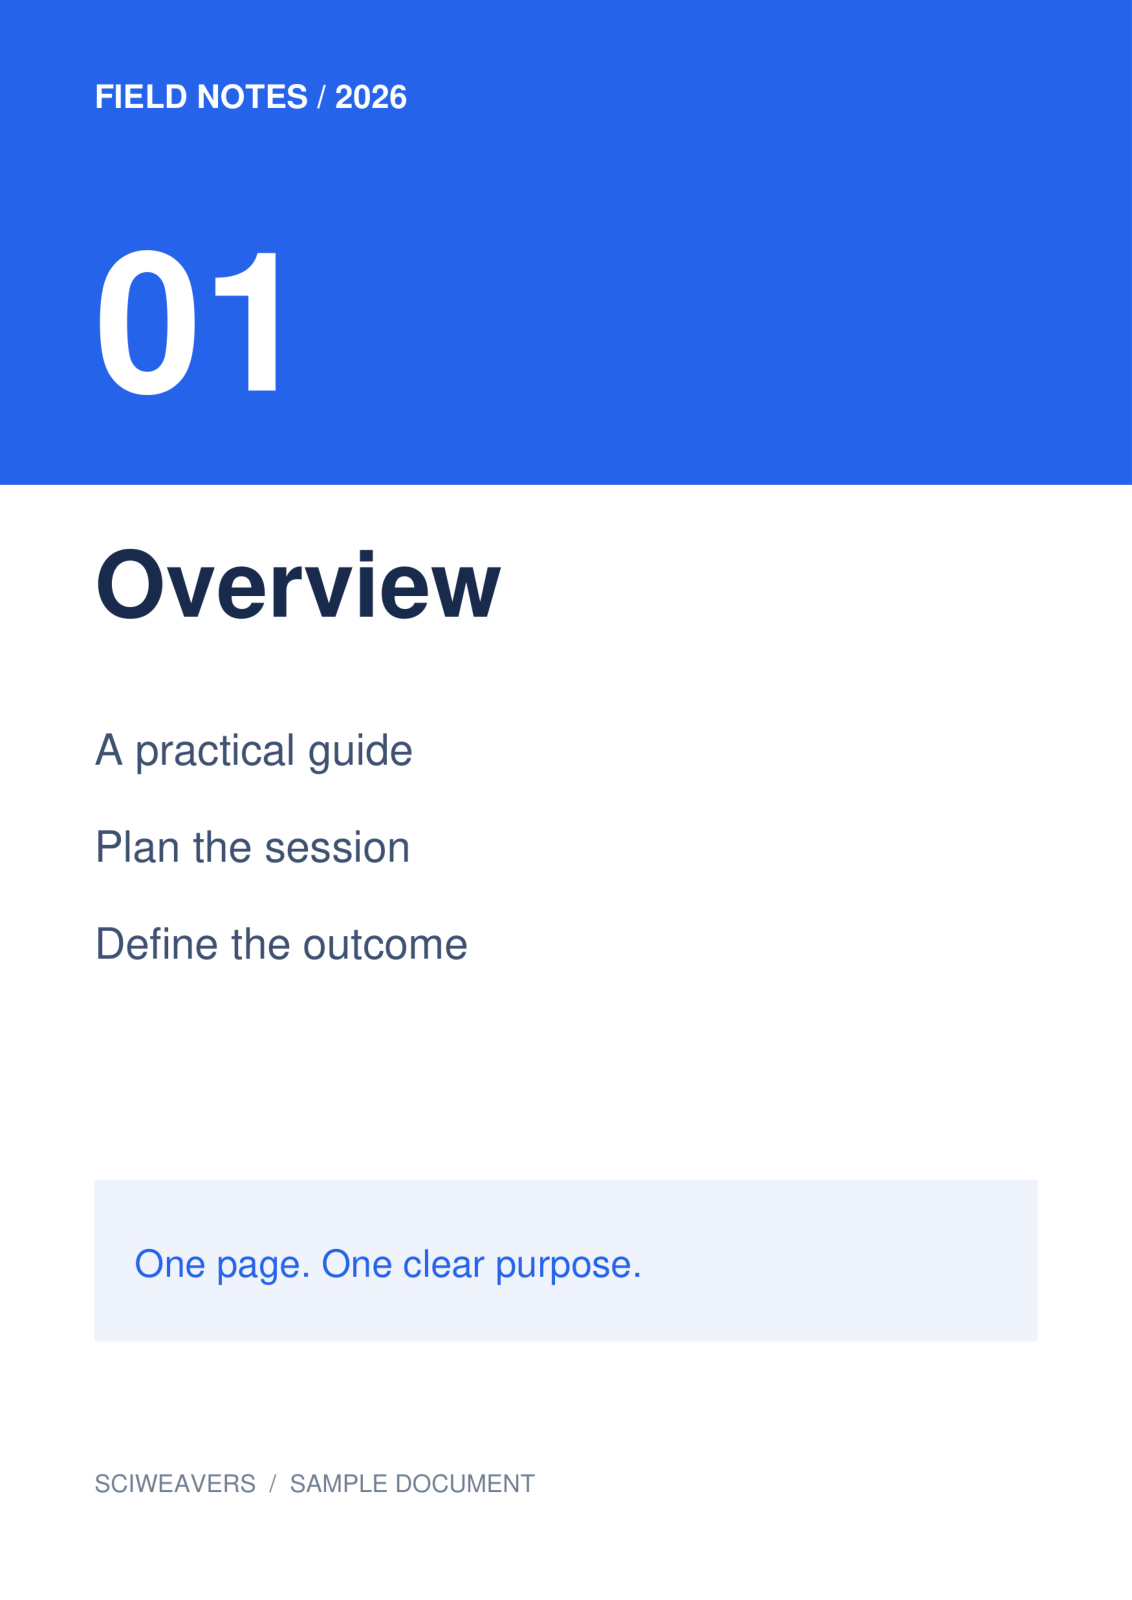
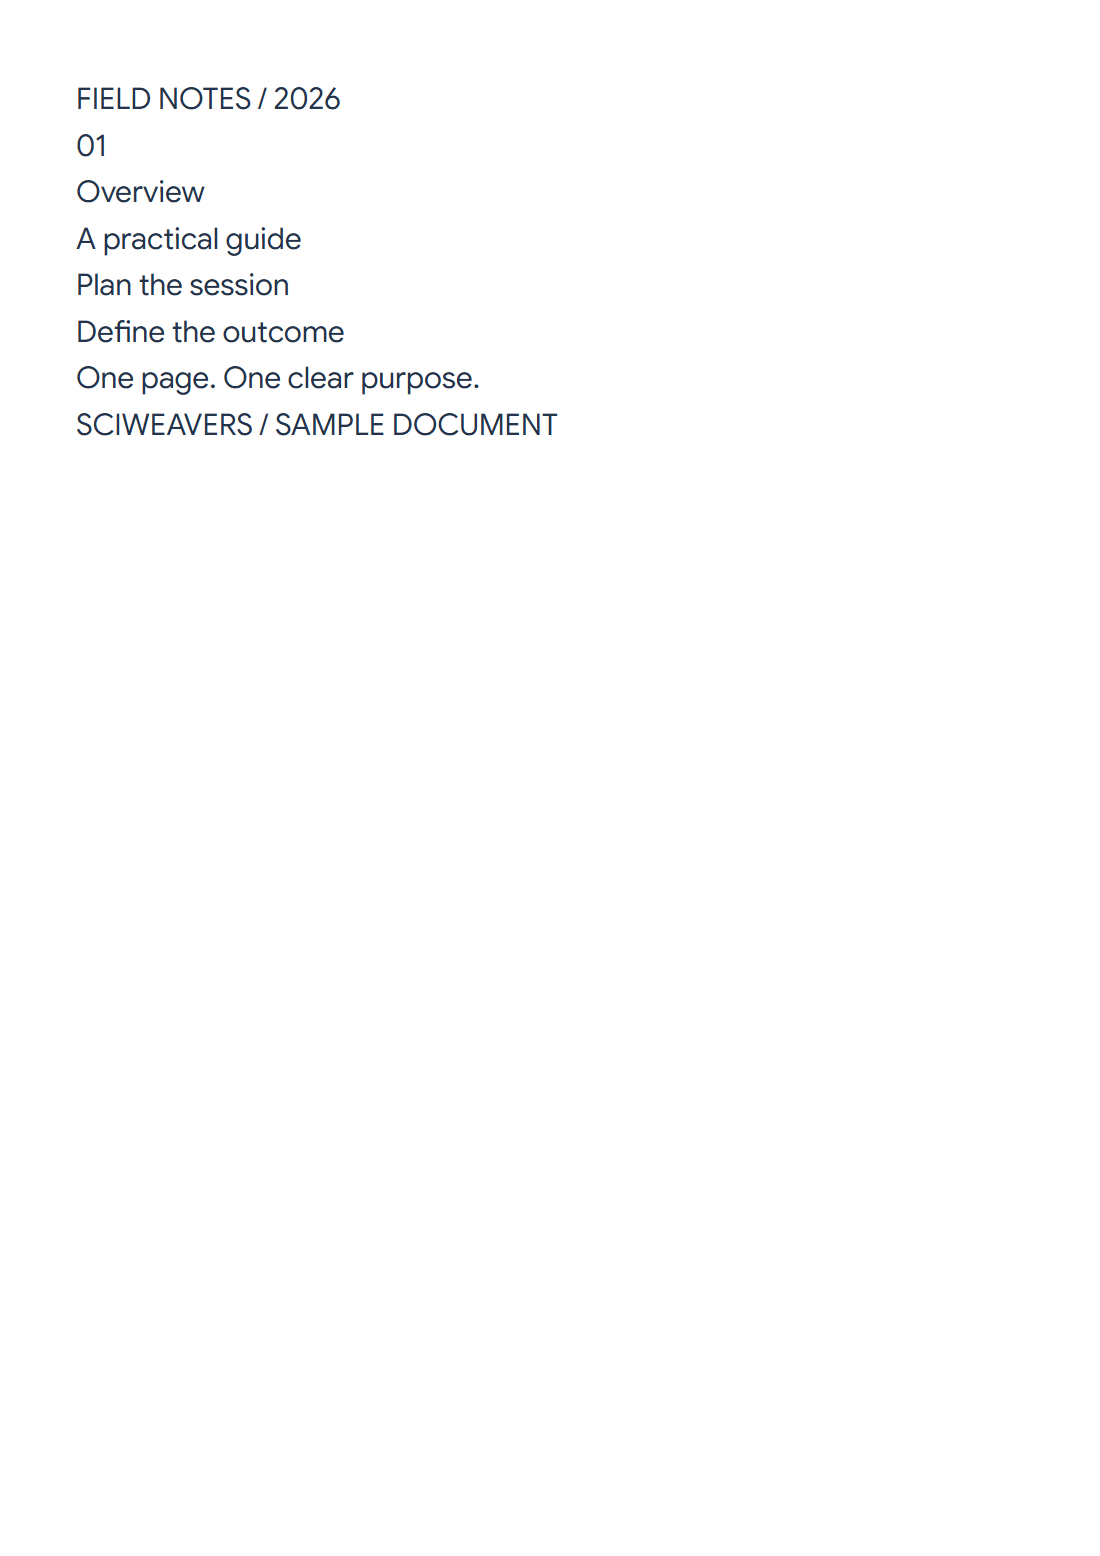

Uporabite PDF OCR za prepoznavanje besed iz slik strani. Naš primer se začne s štiristranskim skeniranim dokumentom, ki vsebuje le slike, in prepozna njegovo prvo stran, Pregled, v besedilo, ki ga je mogoče urejati.
Izberite stran ali območje
Naložite PDF in se pomaknite na stran, ki jo potrebujete. Uporabite celotno stran ali prilagodite izbirni pravokotnik okoli želenega besedila. Primer uporablja celotno stran 1.
Vsaka druga stran ali območje zahteva ločeno dejanje prepoznavanja. Orodje ne obdela samodejno vseh strani naloženega PDF-ja.
Izberite jezik, pogon in format
Izberite jezik, natisnjen na strani. Za naš angleški vzorec ohranite Future kot OCR pogon in izberite Uredljivo besedilo (.txt).
Izberite Classic, ko potrebujete iskalni PDF, ki ohrani izvorno sliko z nevidno plastjo prepoznanega besedila. Future zagotavlja uredljivo besedilo, Word in preoblikovan PDF samo z besedilom.
Prepoznajte, popravite in prenesite
Izberite Start in izpolnite prikazano potrditveno polje. Primerjajte prepoznani rezultat z izvorno sliko. Naš prenos pravilno vključuje Pregled, Načrtovanje seje in Določitev rezultata.
Pred kopiranjem ali prenosom besedila popravite imena, številke in negotove besede. Popravki posodobijo uredljive izvoze; Classicov pozicionirani iskalni PDF ohrani prvotno prepoznavo, zato to datoteko preglejte ločeno.
Izboljšajte prepoznano besedilo s pametnim urejanjem
Za rezultat v formatu TXT ali Word izberite Pametno urejanje poleg Kopiraj. Izberite odlomek za delo z besedilom ali pustite neizbrano, če želite uporabiti celoten osnutek. Izberite Povzemi besedilo, Parafraziraj besedilo, Popravi slovnico ali Predlagaj naslov, nato izberite Uporabi. Dejanje naslova doda naslov nad besedilo.
Preverite vsako spremembo umetne inteligence glede na skenirano sliko, zlasti imena, številke in manjkajoče besede. Predlog ostane v pametnem urejanju, dokler ne izberete Uporabi spremembe. Prenosi TXT in Word nato uporabijo urejeno navadno besedilo. Oblikovana kopija prenese ločeno datoteko HTML z oblikovanjem urejevalnika; prvotna skenirana slika in plast besedila v iskalnem PDF-ju Classic se ne spremenita.
Pogosta vprašanja
Ali lahko prepoznam samo en odstavek?
Da. Pred začetkom izberite pravokotnik okoli njega. Preverite robove, da bo bližnje besedilo izključeno in pomembne besede ne bodo odrezane.
Ali bo Future ohranil prvotno obliko strani v svojem PDF-ju?
Njegov PDF je preoblikovan dokument samo z besedilom. Izberite iskalni PDF Classic, ko je namen ohraniti sliko skenirane strani s plastjo besedila.
Ali lahko pametno urejanje spremeni iskalni PDF?
Ne. Pametno urejanje je na voljo pri rezultatih TXT in Word. Uporaba sprememb posodobi uredljivo besedilo; ne prepiše skenirane strani ali predhodno ustvarjenega iskalnega PDF-ja.
Preizkusite s svojim dokumentom
Preglejte rezultat in nato shranite različico, ki jo potrebujete.