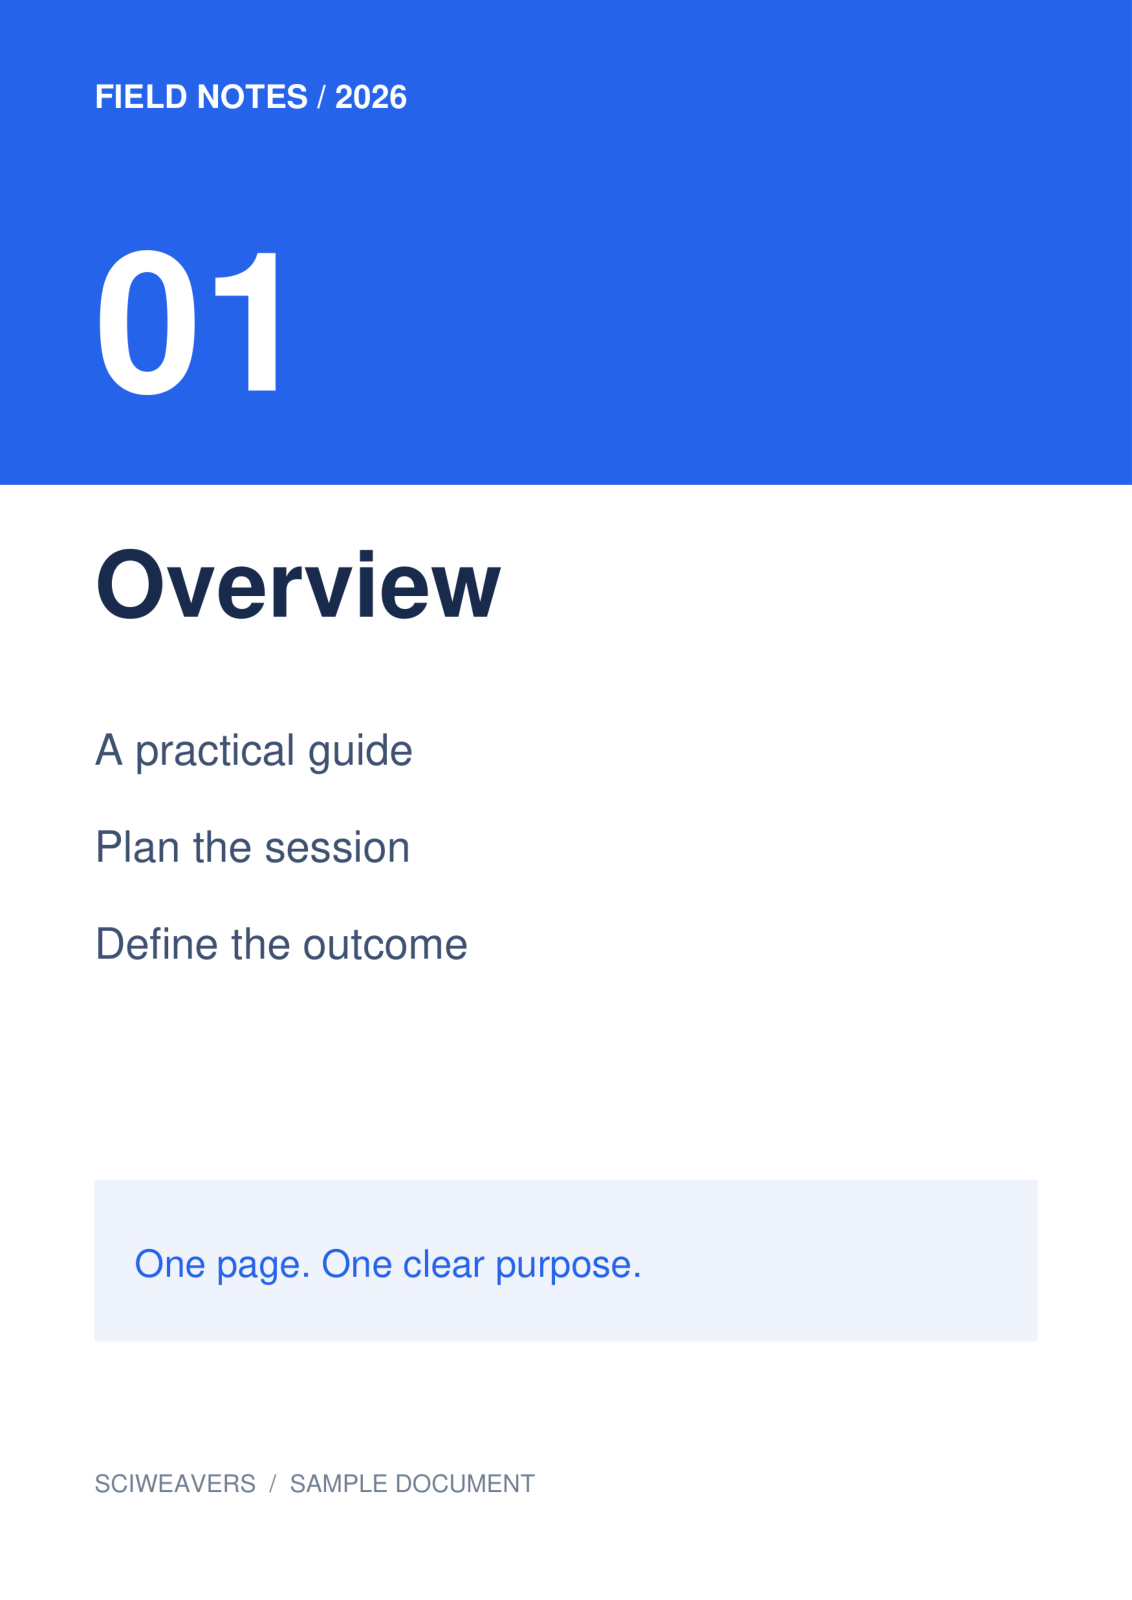
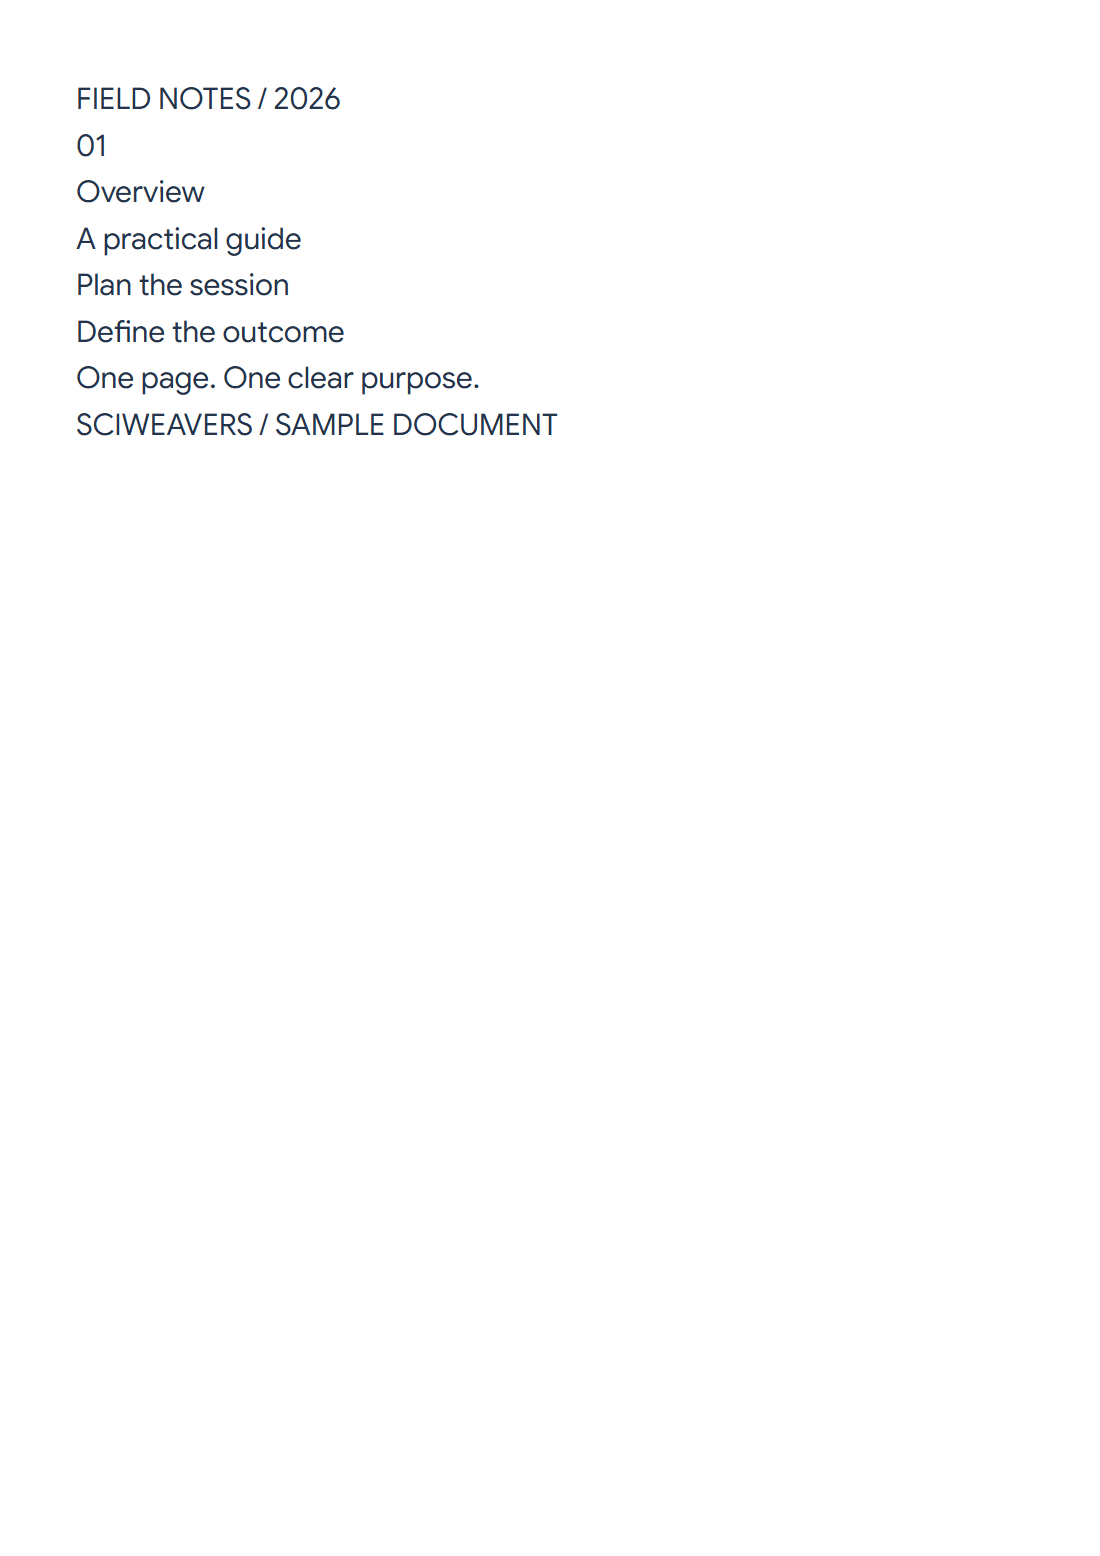

Použite PDF OCR na rozpoznanie slov z obrázkov strán. Náš príklad začína štvorstranovým skenom obsahujúcim iba obrázky a rozpoznáva jeho prvú stranu, Prehľad, do upraviteľného textu.
Vyberte stranu alebo oblasť
Nahrajte PDF a prejdite na stranu, ktorú potrebujete. Použite celú stranu alebo upravte výberový obdĺžnik okolo potrebného textu. Príklad využíva celú stranu 1.
Ďalšia strana alebo oblasť vyžaduje samostatnú akciu rozpoznávania. Nástroj automaticky nespracováva každú stranu nahraného PDF.
Vyberte jazyk, engine a formát
Vyberte jazyk vytlačený na strane. Pre našu anglickú ukážku ponechajte Future ako OCR engine a zvoľte Upraviteľný text (.txt).
Zvoľte Classic, ak potrebujete prehľadávateľné PDF, ktoré zachová zdrojový obrázok s neviditeľnou vrstvou rozpoznaného textu. Future poskytuje upraviteľný text, Word a preformátované PDF obsahujúce iba text.
Rozpoznať, opraviť a stiahnuť
Zvoľte Štart a dokončite zobrazené overovacie zaškrtávacie políčko. Porovnajte rozpoznaný výsledok so zdrojovým obrázkom. Naše stiahnutie správne obsahuje Prehľad, Naplánovanie stretnutia a Definovanie výsledku.
Pred kopírovaním alebo stiahnutím textu opravte mená, čísla a neisté slová. Opravy aktualizujú upraviteľné exporty; prehľadávateľné PDF v režime Classic si zachováva pôvodné rozpoznanie, preto tento súbor skontrolujte samostatne.
Upravte rozpoznaný text pomocou Inteligentných úprav
Pre výsledok vo formáte TXT alebo Word zvoľte Inteligentné úpravy vedľa Kopírovať. Vyberte pasáž, na ktorej chcete pracovať, alebo nechajte výber prázdny, ak chcete použiť celý koncept. Zvoľte Zhrnúť text, Parafrázovať text, Opraviť gramatiku alebo Navrhnúť nadpis, a potom zvoľte Použiť. Akcia nadpisu pridá nadpis nad text.
Skontrolujte každú zmenu AI oproti skenu, najmä mená, čísla a chýbajúce slová. Návrh zostáva v Inteligentných úpravách, kým nezvolíte Použiť zmeny. Stiahnuté súbory TXT a Word potom použijú upravený čistý text. Formátovaná kópia stiahne samostatný súbor HTML so štýlmi editora; pôvodný sken a textová vrstva prehľadávateľného PDF v režime Classic sa nezmenia.
Časté otázky
Môžem rozpoznať iba jeden odsek?
Áno. Pred spustením vyberte obdĺžnik okolo neho. Skontrolujte okraje, aby bol okolitý text vylúčený a dôležité slová neboli odrezané.
Zachová Future pôvodný dizajn strany vo svojom PDF?
Jeho PDF je preformátovaný dokument obsahujúci iba text. Zvoľte prehľadávateľné PDF v režime Classic, ak je účelom zachovanie obrázka skenovanej strany s textovou vrstvou.
Môžu Inteligentné úpravy zmeniť prehľadávateľné PDF?
Nie. Inteligentné úpravy sú dostupné pri výsledkoch TXT a Word. Použitie zmien aktualizuje upraviteľný text; neprepíše skenovanú stranu ani predtým vygenerované prehľadávateľné PDF.
Vyskúšajte to so svojím dokumentom
Skontrolujte výsledok a potom uložte verziu, ktorú potrebujete.