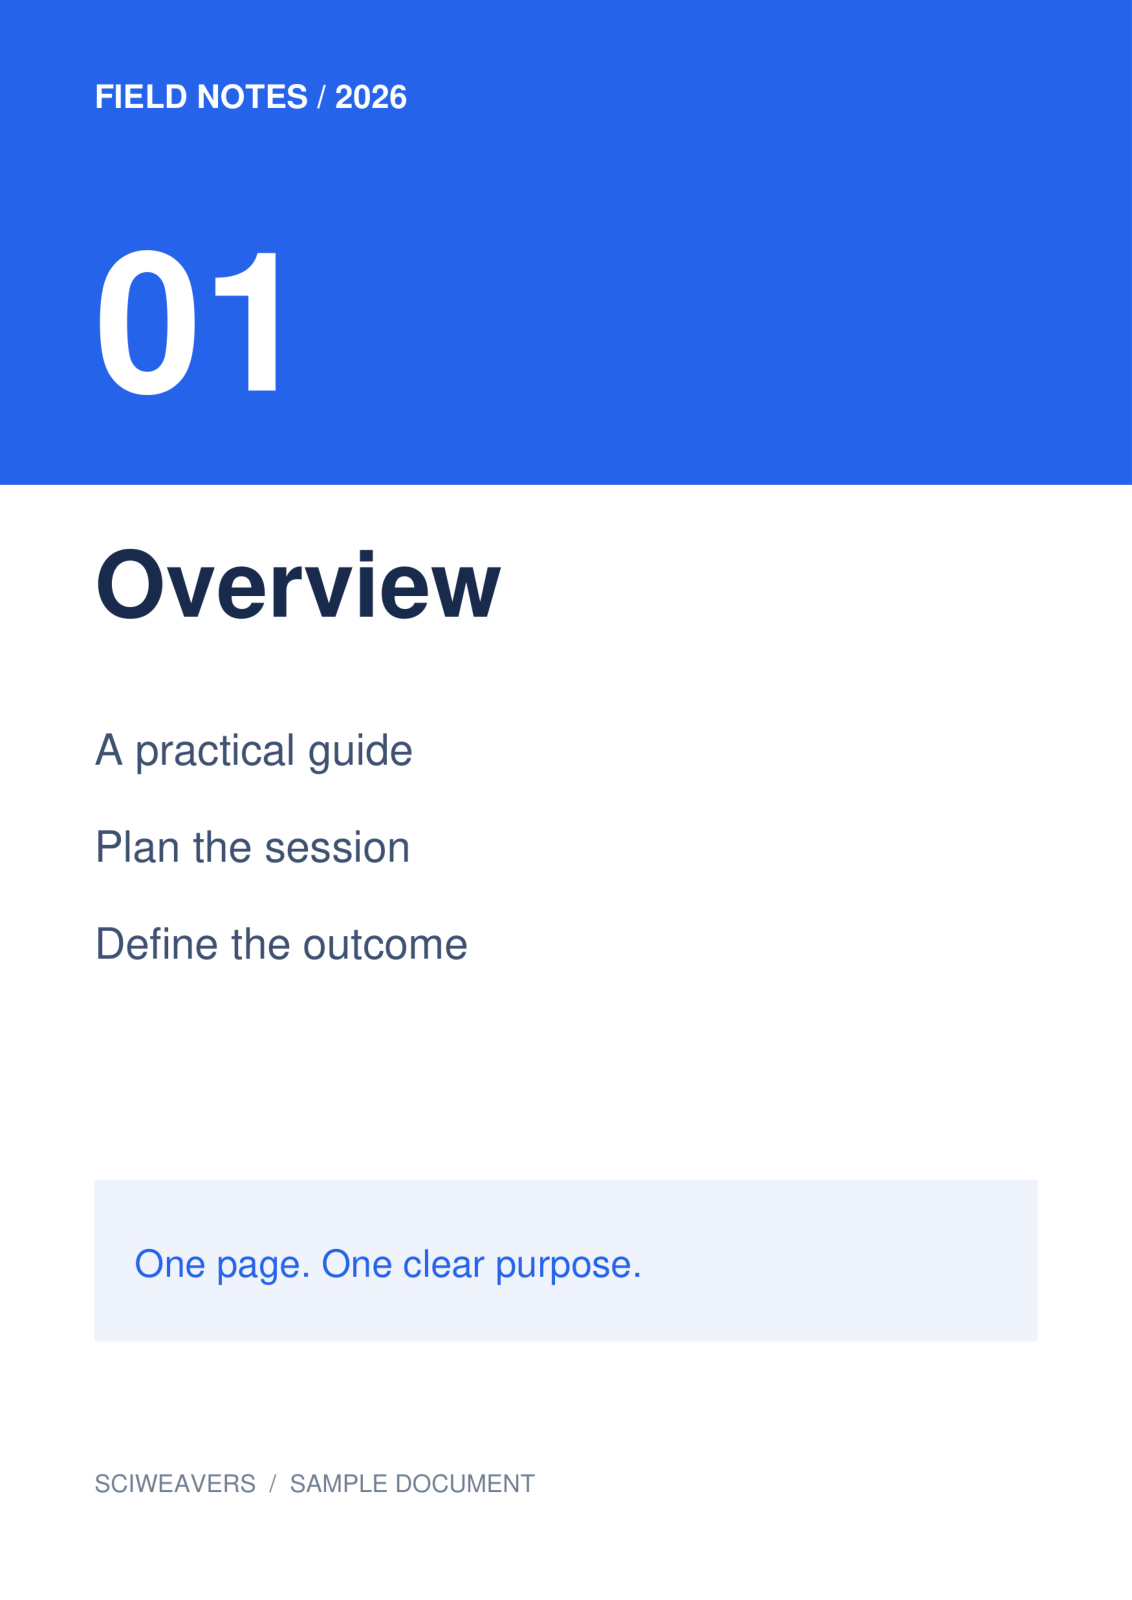
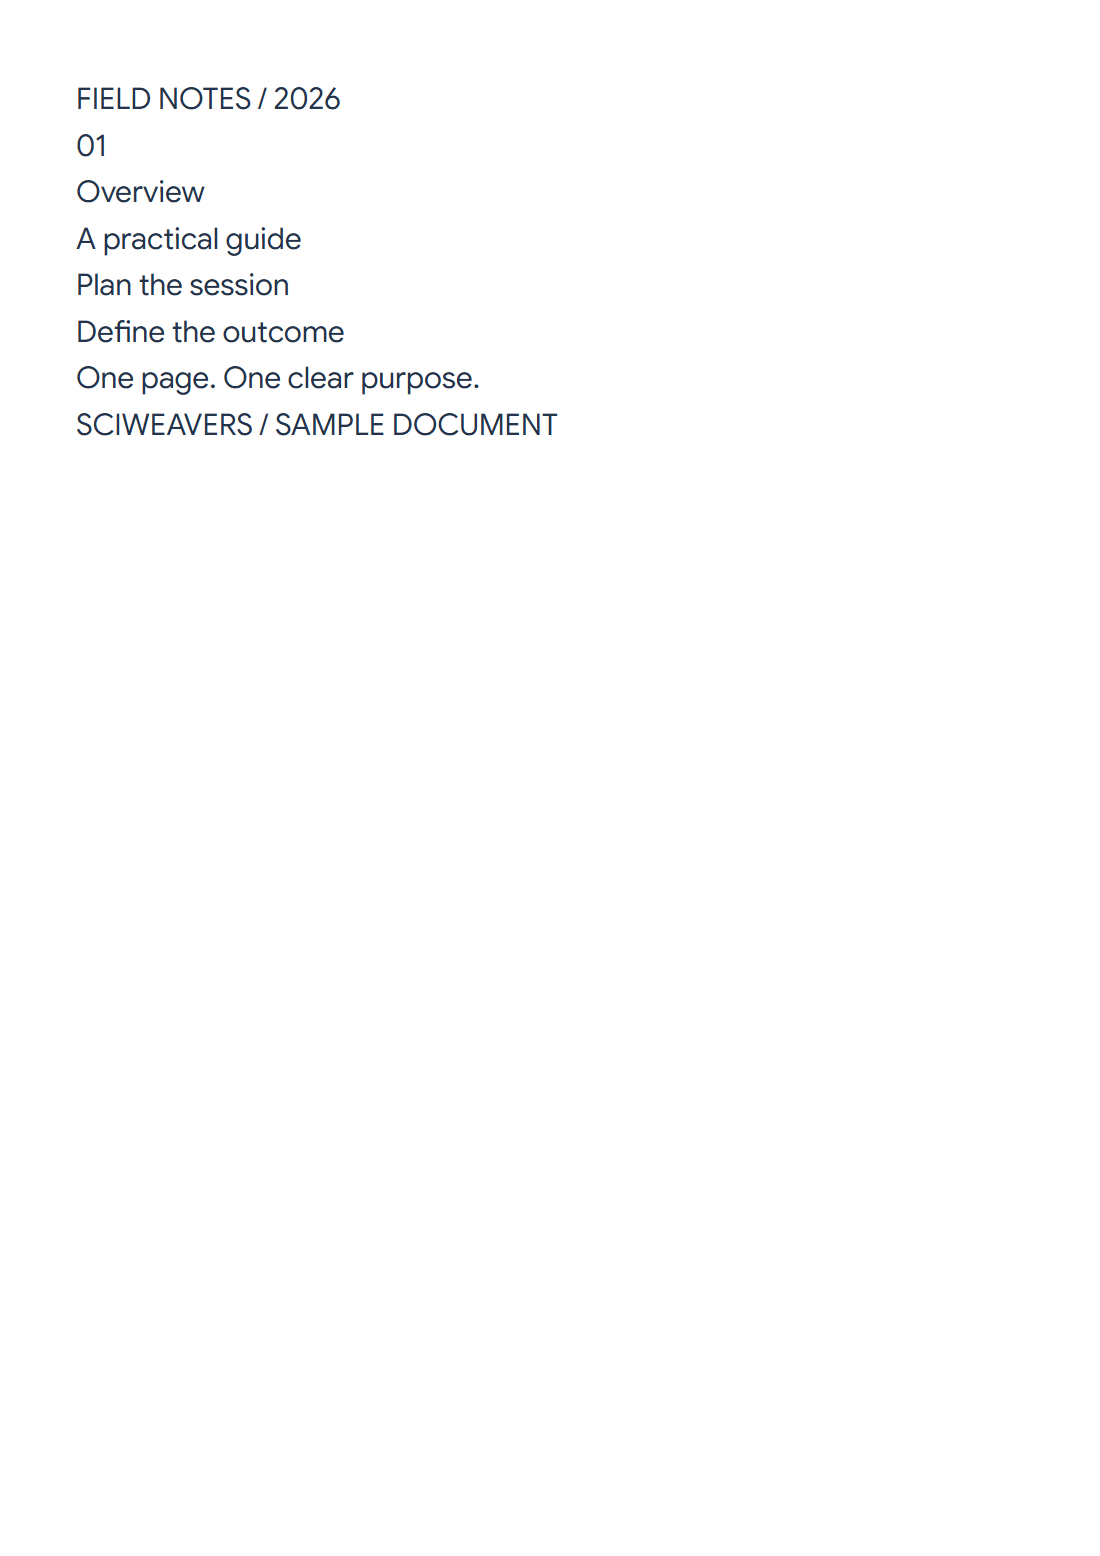

Utilice PDF OCR para reconocer palabras a partir de imágenes de página. Nuestro ejemplo comienza con un escaneo de cuatro páginas que solo contiene imágenes y reconoce su primera página, Overview, convirtiéndola en texto editable.
Elija una página o área
Cargue el PDF y navegue hasta la página que necesita. Utilice la página completa o ajuste un rectángulo de selección alrededor del texto necesario. El ejemplo utiliza toda la página 1.
Otra página o área requiere una acción de reconocimiento por separado. La herramienta no procesa automáticamente todas las páginas del PDF cargado.
Elija idioma, motor y formato
Elija el idioma impreso en la página. Para nuestra muestra en inglés, mantenga Future como motor de OCR y elija Texto editable (.txt).
Elija Classic cuando necesite su PDF con capacidad de búsqueda, el cual conserva la imagen original con una capa de texto reconocido invisible. Future proporciona texto editable, Word y un PDF de solo texto con reflujo.
Reconocer, corregir y descargar
Elija Start y complete la casilla de verificación de validación que aparece. Compare el resultado reconocido con la imagen original. Nuestra descarga incluye correctamente Overview, Plan the session y Define the outcome.
Corrija nombres, números y palabras inciertas antes de copiar o descargar el texto. Las correcciones actualizan las exportaciones editables; el PDF con capacidad de búsqueda posicionado de Classic conserva el reconocimiento original, así que revise ese archivo por separado.
Refine el texto reconocido con Edición inteligente
Para obtener un resultado en TXT o Word, elija Edición inteligente junto a Copiar. Seleccione un pasaje para trabajar en ese texto o no seleccione nada para usar todo el borrador. Elija Resumir texto, Parafrasear texto, Corregir gramática o Sugerir un título, luego elija Aplicar. La acción de título añade un encabezado sobre el texto.
Verifique cada cambio de la IA con el escaneo, especialmente nombres, números y palabras faltantes. La sugerencia permanece en Edición inteligente hasta que elija Aplicar cambios. Las descargas en TXT y Word utilizan entonces el texto plano editado. Copia formateada descarga un archivo HTML separado con el estilo del editor; el escaneo original y la capa de texto del PDF con capacidad de búsqueda de Classic no cambian.
Preguntas comunes
¿Puedo reconocer solo un párrafo?
Sí. Seleccione un rectángulo alrededor de él antes de comenzar. Compruebe los bordes para que el texto cercano quede excluido y no se corten palabras importantes.
¿Future mantendrá el diseño de página original en su PDF?
Su PDF es un documento de solo texto con reflujo. Elija el PDF con capacidad de búsqueda de Classic cuando el objetivo sea conservar la imagen de la página escaneada con una capa de texto.
¿Puede la Edición inteligente cambiar el PDF con capacidad de búsqueda?
No. La Edición inteligente está disponible con resultados en TXT y Word. Aplicar cambios actualiza el texto editable; no reescribe la página escaneada ni un PDF con capacidad de búsqueda generado previamente.
Pruébelo con su documento
Revise el resultado y luego guarde la versión que necesita.