

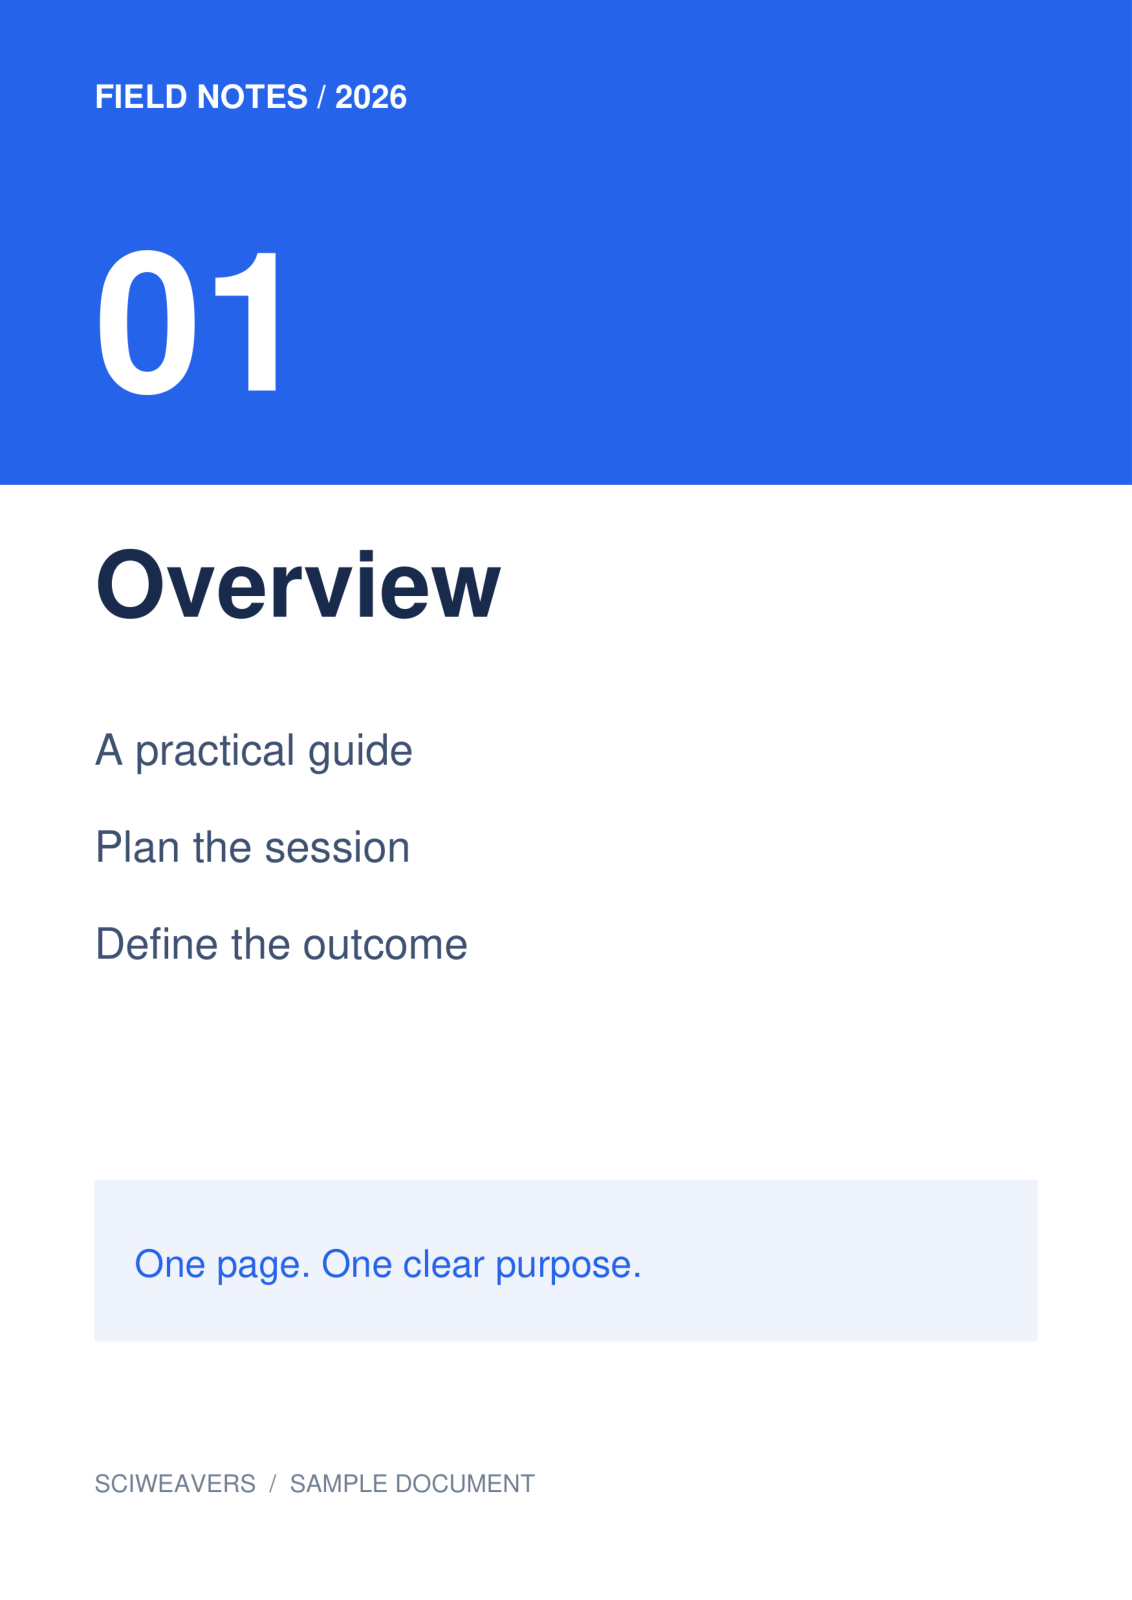
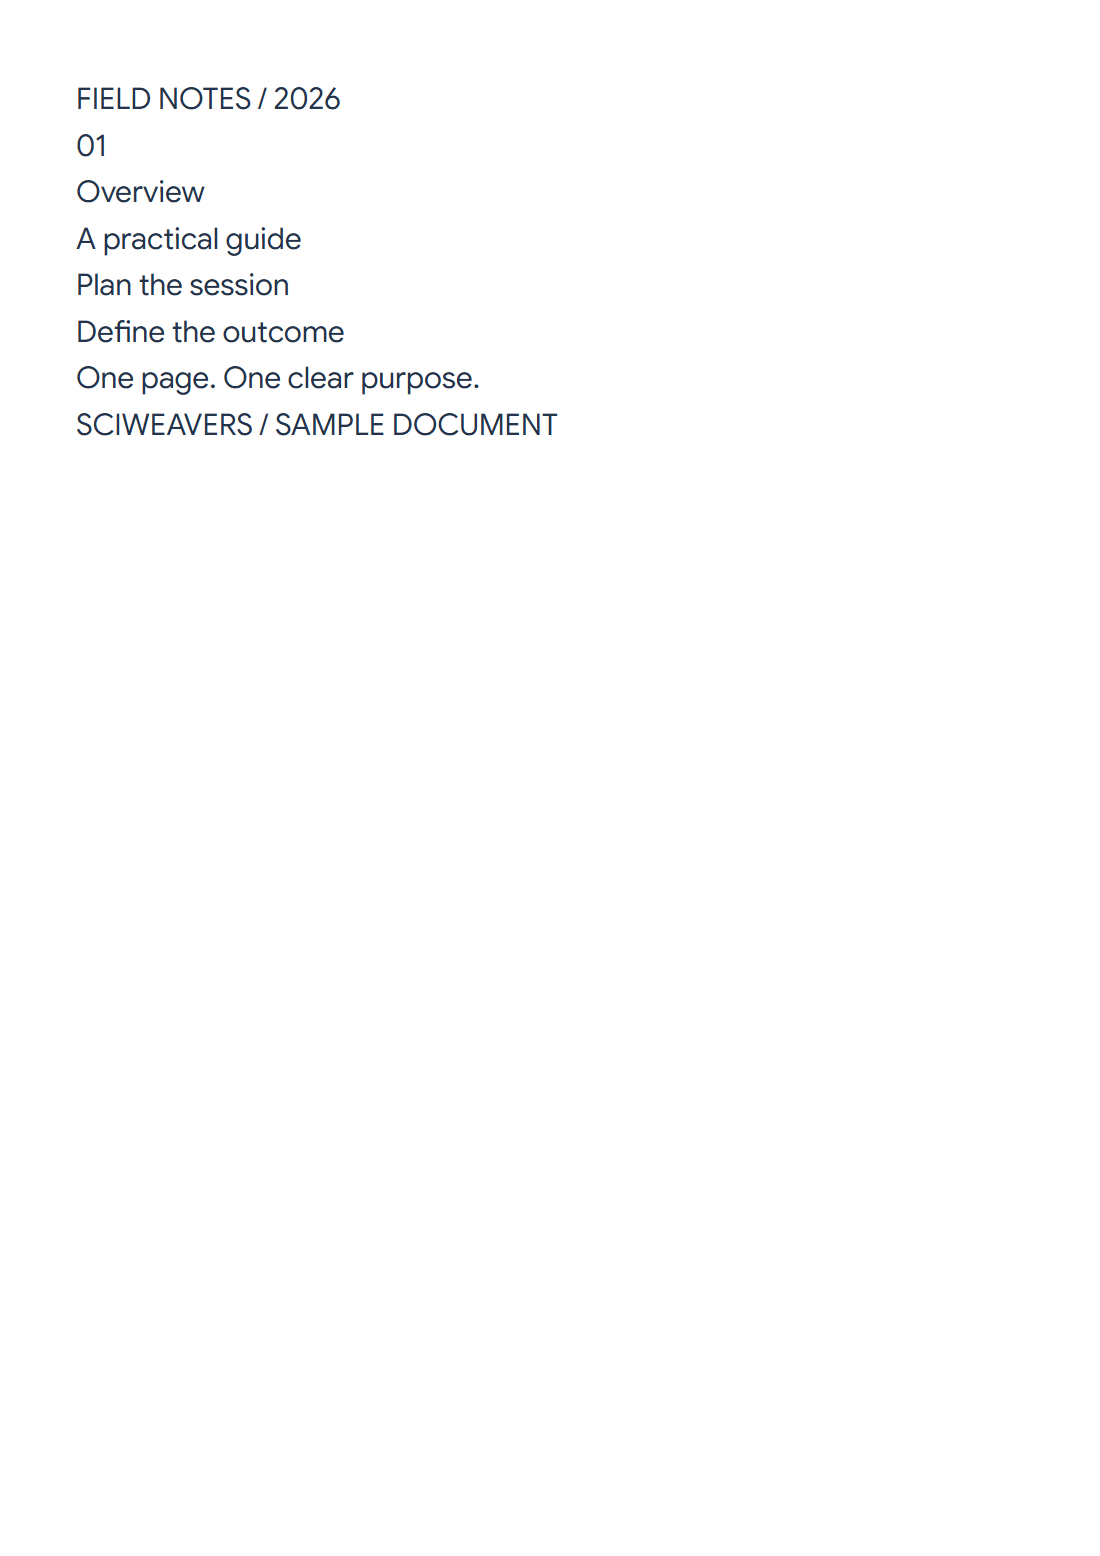

Використовуйте PDF OCR для розпізнавання слів із зображень сторінок. Наш приклад починається з чотиристорінкового скану, що складається лише із зображень, і розпізнає його першу сторінку, Overview, у редагований текст.
Виберіть сторінку або область
Завантажте PDF і перейдіть до потрібної сторінки. Використовуйте всю сторінку або налаштуйте прямокутник виділення навколо потрібного тексту. У прикладі використовується вся сторінка 1.
Для іншої сторінки або області потрібна окрема дія розпізнавання. Інструмент не обробляє автоматично кожну сторінку завантаженого PDF.
Для тьмяного або пошкодженого скану виберіть Покращити зображення над попереднім переглядом сторінки. Налаштуйте яскравість, контрастність або очищення фону; скористайтеся гумкою або намалюйте прямокутник, щоб видалити небажані позначки. Порівняйте Оригінал та Покращено, а потім виберіть Застосувати зміни. Редагування стосується поточної сторінки. Перевірте вибір перед початком OCR.
Виберіть мову, рушій і формат
Виберіть мову, надруковану на сторінці. Для нашого англійського зразка залиште Future як рушій OCR і виберіть Editable text (.txt).
Виберіть Classic, коли вам потрібен PDF із можливістю пошуку, який зберігає вихідне зображення з невидимим шаром розпізнаного тексту. Future надає редагований текст, Word і переформатований PDF лише з текстом.
Розпізнайте, виправте та завантажте
Виберіть Start і завершіть відображену перевірку за допомогою прапорця. Порівняйте розпізнаний результат із вихідним зображенням. Наше завантаження правильно включає Overview, Plan the session і Define the outcome.
Виправте імена, цифри та сумнівні слова перед копіюванням або завантаженням тексту. Виправлення оновлюють редаговані експорти; позиціонований PDF із можливістю пошуку в Classic зберігає початкове розпізнавання, тому перевіряйте цей файл окремо.
Удоскональте розпізнаний текст за допомогою Smart edit
Для результату у форматі TXT або Word виберіть Smart edit поруч із Copy. Виділіть уривок для роботи з цим текстом або залиште все без виділення, щоб використовувати весь чернетковий варіант. Виберіть Summarize text, Paraphrase text, Fix grammar або Suggest a title, а потім виберіть Apply. Дія з заголовком додає заголовок над текстом.
Перевіряйте кожну зміну ШІ порівняно зі сканом, особливо імена, цифри та пропущені слова. Пропозиція залишається в Розумне редагування, доки ви не виберете Застосувати зміни. Завантаження TXT та Word потім використовують відредагований звичайний текст. Розумне редагування за замовчуванням завантажує Word (.docx); виберіть PDF або HTML для іншої відформатованої копії. Оригінальний скан та шар Класичний доступного для пошуку тексту PDF не змінюються.
Поширені запитання
Чи можу я розпізнати лише один абзац?
Так. Виділіть прямокутник навколо нього перед початком. Перевірте краї, щоб сусідній текст був виключений, а важливі слова не були обрізані.
Чи збереже Future оригінальний дизайн сторінки у своєму PDF?
Його PDF — це переформатований документ лише з текстом. Вибирайте PDF із можливістю пошуку в Classic, якщо метою є збереження зображення сканованої сторінки з текстовим шаром.
Чи може Smart edit змінити PDF із можливістю пошуку?
Ні. Smart edit доступний для результатів у форматі TXT і Word. Apply Changes оновлює редагований текст; він не переписує скановану сторінку або раніше створений PDF із можливістю пошуку.
Спробуйте зі своїм документом
Перегляньте результат, а потім збережіть потрібну версію.


