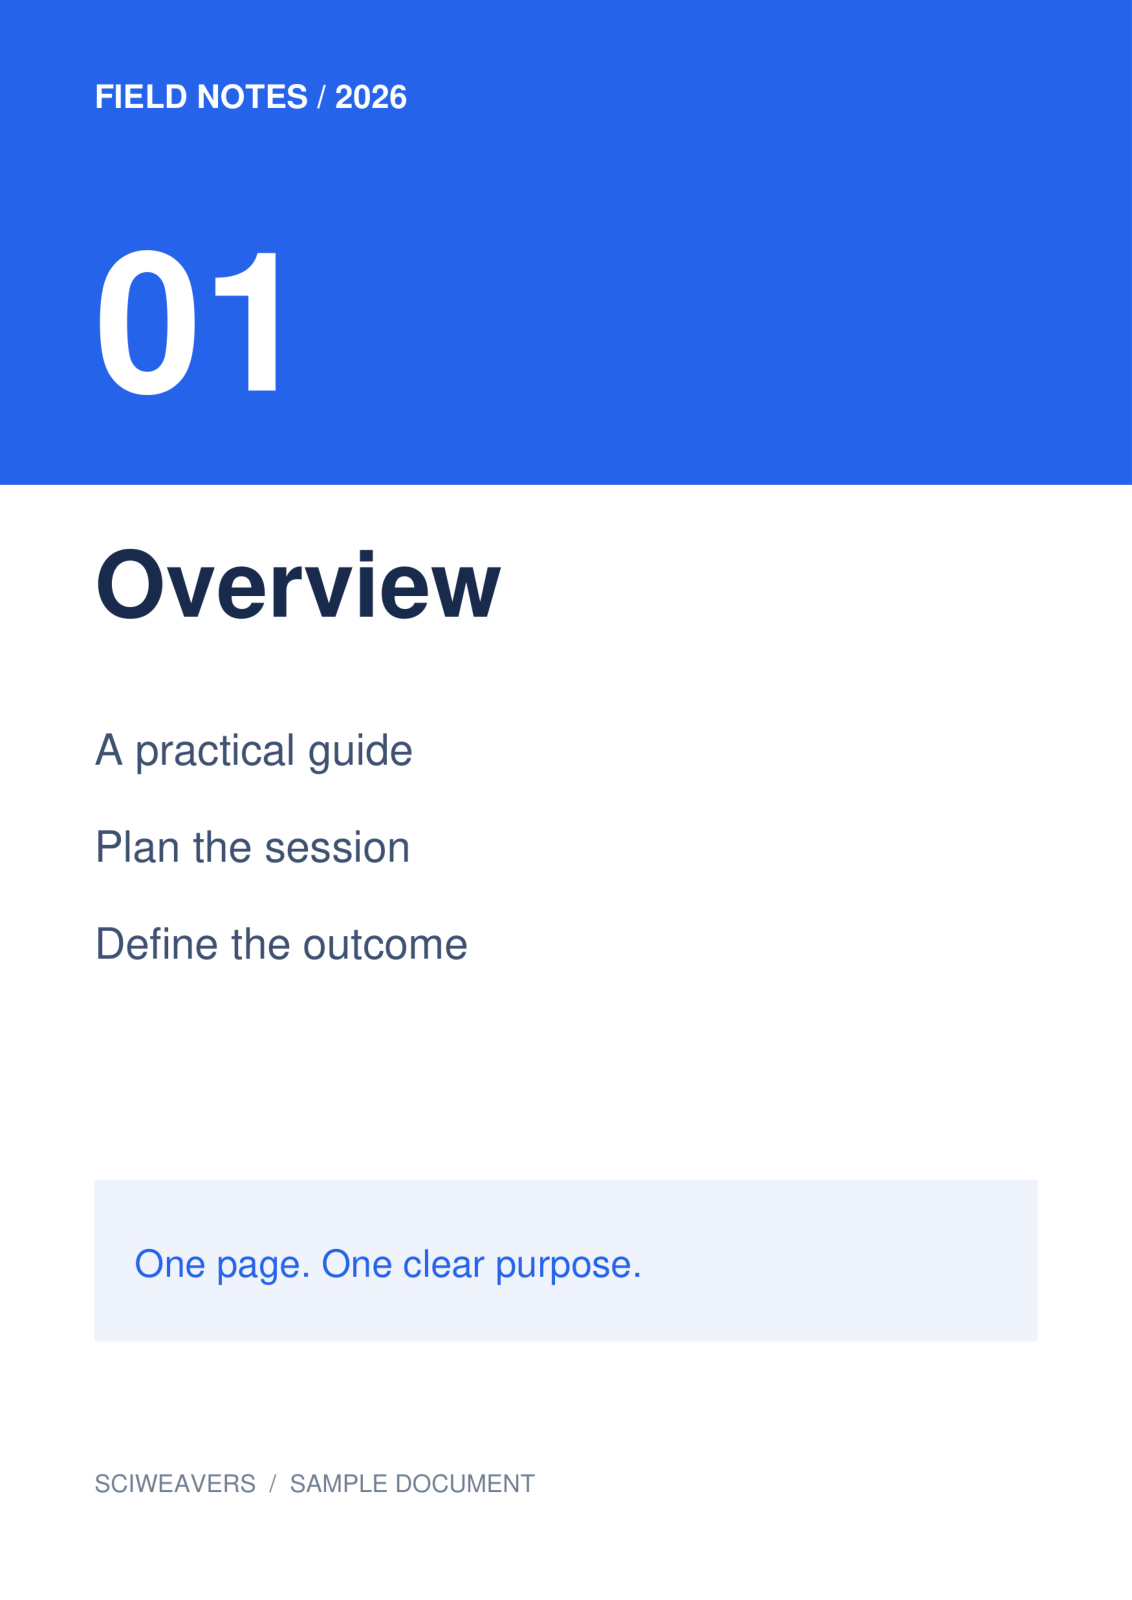
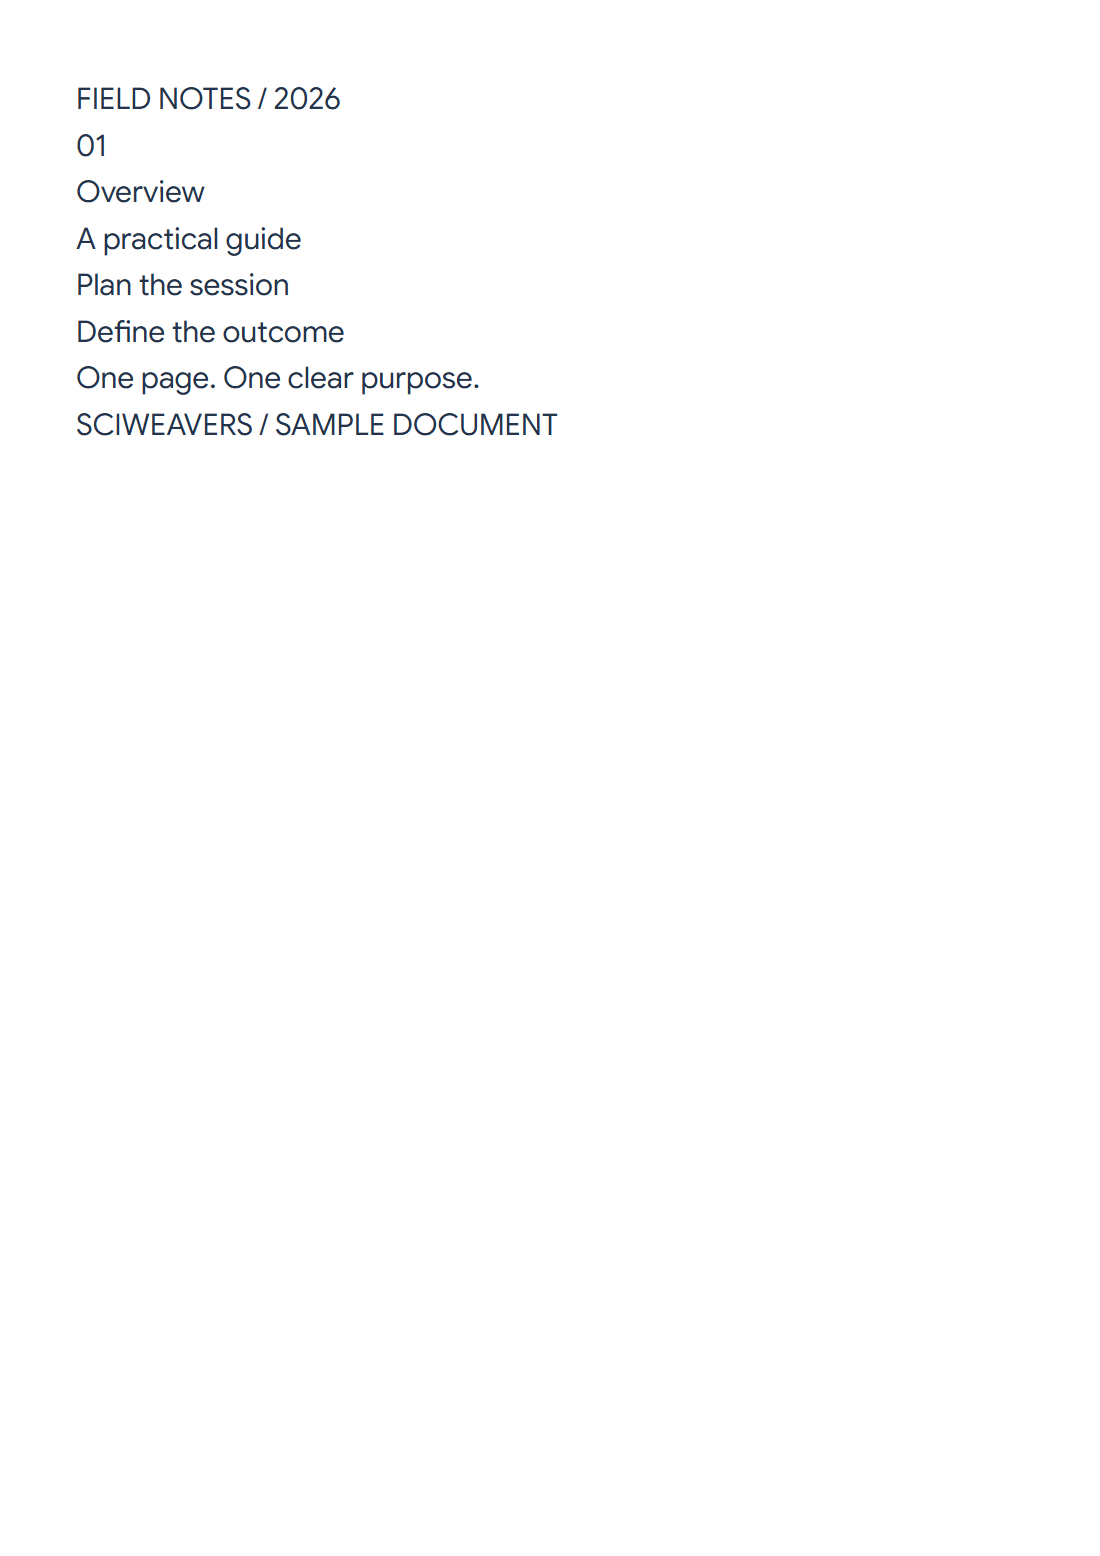

Използвайте PDF OCR, за да разпознаете думи от изображения на страници. Нашият пример започва със сканиран документ от четири страници, съдържащ само изображения, и разпознава първата му страница, „Overview“, в редактируем текст.
Изберете страница или област
Заредете PDF файла и отидете на страницата, от която се нуждаете. Използвайте цялата страница или коригирайте правоъгълника за избор около необходимия текст. Примерът използва цялата страница 1.
Друга страница или област изисква отделна операция по разпознаване. Инструментът не обработва автоматично всяка страница от качения PDF файл.
Изберете език, двигател и формат
Изберете езика, отпечатан на страницата. За нашия пример на английски език оставете Future като OCR двигател и изберете Editable text (.txt).
Изберете Classic, когато се нуждаете от неговия PDF с възможност за търсене, който запазва изходното изображение със слой от невидим разпознат текст. Future предоставя редактируем текст, Word и преформатиран PDF само с текст.
Разпознайте, коригирайте и изтеглете
Изберете Start и попълнете показаната отметка за проверка. Сравнете разпознатия резултат с изходното изображение. Нашето изтегляне правилно включва „Overview“, „Plan the session“ и „Define the outcome“.
Коригирайте имена, числа и несигурни думи, преди да копирате или изтеглите текста. Корекциите актуализират редактируемите експорти; позиционираният PDF с възможност за търсене на Classic запазва първоначалното разпознаване, така че прегледайте този файл отделно.
Прецизирайте разпознатия текст с „Интелигентно редактиране“
За резултат в TXT или Word изберете Smart edit до Copy. Изберете пасаж, върху който да работите, или не избирайте нищо, за да използвате целия чернови текст. Изберете Summarize text, Paraphrase text, Fix grammar или Suggest a title, след което изберете Apply. Действието за заглавие добавя заглавие над текста.
Проверявайте всяка промяна от ИИ спрямо сканираното изображение, особено имена, числа и липсващи думи. Предложението остава в „Интелигентно редактиране“, докато не изберете Apply Changes. Изтеглянията в TXT и Word след това използват редактирания чист текст. Formatted copy изтегля отделен HTML файл със стилизиране на редактора; оригиналното сканирано изображение и текстовият слой на PDF файла с възможност за търсене на Classic не се променят.
Често задавани въпроси
Мога ли да разпозная само един параграф?
Да. Изберете правоъгълник около него, преди да започнете. Проверете краищата, така че близкият текст да бъде изключен, а важните думи да не бъдат отрязани.
Ще запази ли Future оригиналния дизайн на страницата в своя PDF?
Неговият PDF е преформатиран документ само с текст. Изберете PDF с възможност за търсене на Classic, когато целта е запазване на изображението на сканираната страница със слой от текст.
Може ли „Интелигентно редактиране“ да промени PDF файла с възможност за търсене?
Не. „Интелигентно редактиране“ е достъпно с резултати в TXT и Word. „Apply Changes“ актуализира редактируемия текст; то не пренаписва сканираната страница или генериран по-рано PDF с възможност за търсене.
Опитайте с вашия документ
Прегледайте резултата, след което запишете версията, от която се нуждаете.