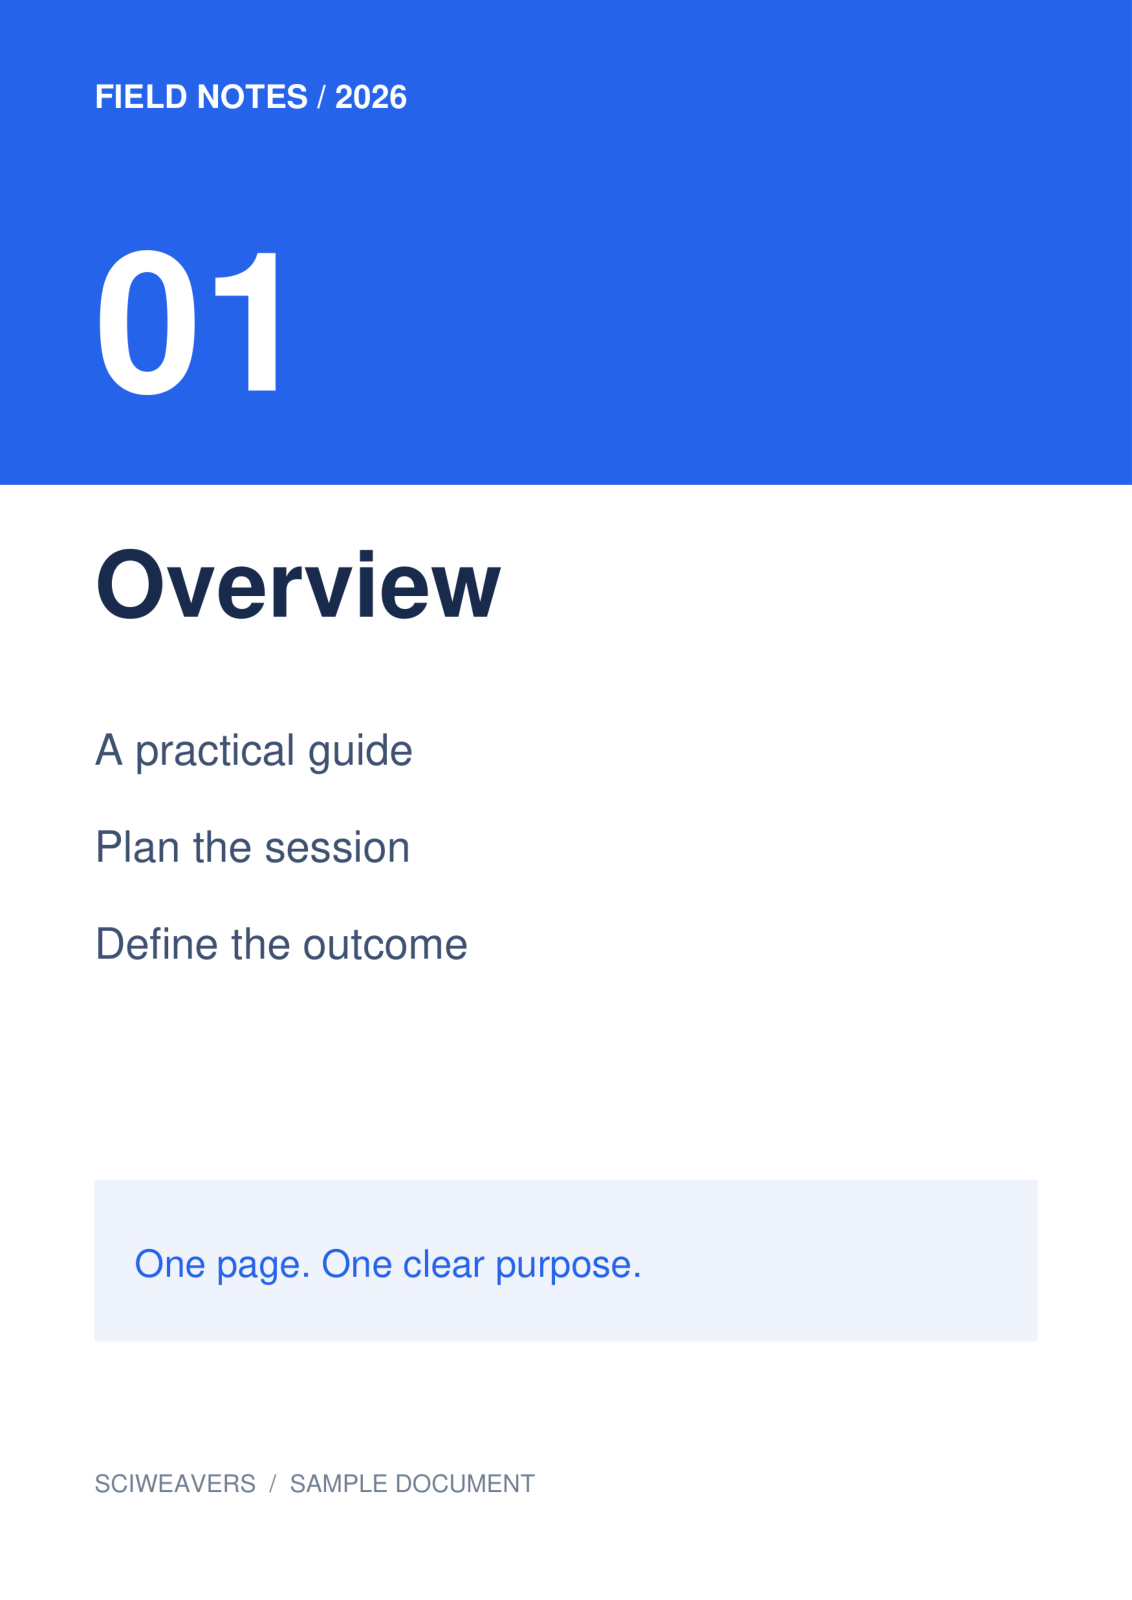
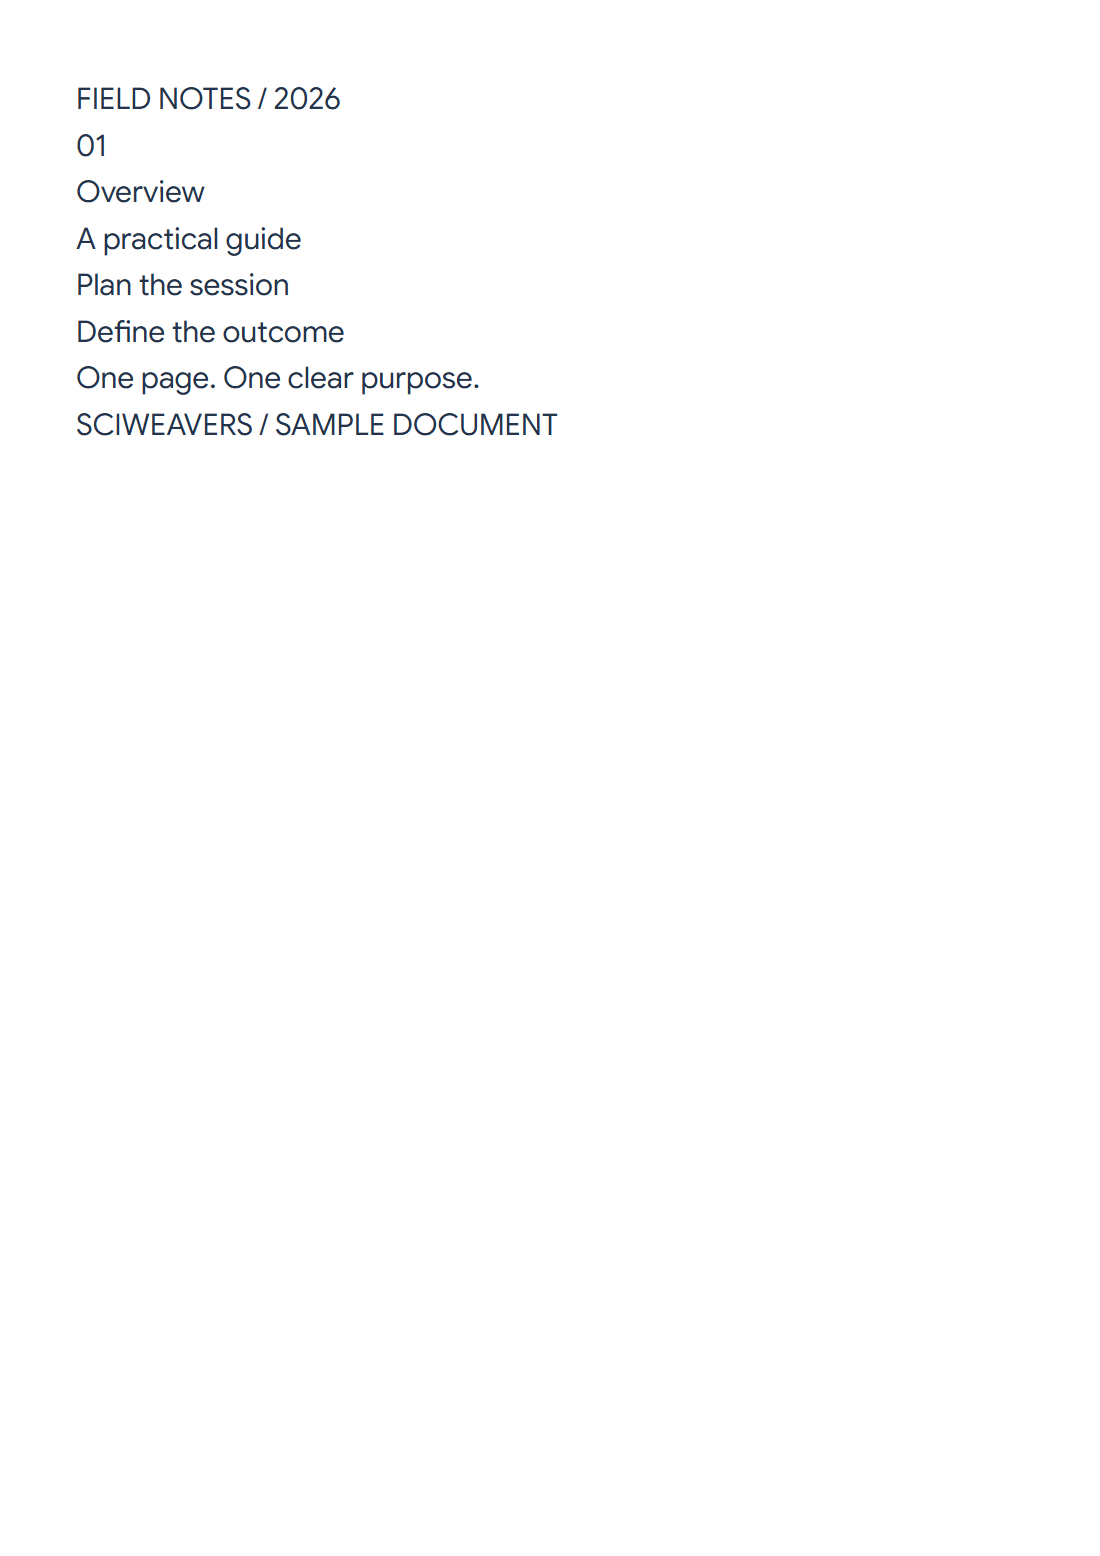

از PDF OCR برای شناسایی کلمات از تصاویر صفحه استفاده کنید. مثال ما با یک فایل اسکنشده چهار صفحهای که فقط شامل تصویر است شروع میشود و صفحه اول آن، یعنی Overview، را به متن قابل ویرایش تبدیل میکند.
یک صفحه یا ناحیه انتخاب کنید
فایل PDF را بارگذاری کرده و به صفحه مورد نیاز خود بروید. از کل صفحه استفاده کنید یا یک مستطیل انتخابی دور متن مورد نیاز تنظیم کنید. این مثال از تمام صفحه 1 استفاده میکند.
صفحه یا ناحیه دیگر نیاز به یک عملیات شناسایی جداگانه دارد. این ابزار بهطور خودکار تمام صفحات PDF بارگذاریشده را پردازش نمیکند.
زبان، موتور و فرمت را انتخاب کنید
زبانی که روی صفحه چاپ شده است را انتخاب کنید. برای نمونه انگلیسی ما، Future را به عنوان موتور OCR نگه دارید و Editable text (.txt) را انتخاب کنید.
زمانی که به PDF قابل جستجو نیاز دارید، Classic را انتخاب کنید؛ این گزینه تصویر منبع را با یک لایه متن شناساییشده نامرئی حفظ میکند. Future متن قابل ویرایش، Word و یک PDF فقط متنی با چیدمان مجدد ارائه میدهد.
شناسایی، اصلاح و دانلود کنید
Start را انتخاب کرده و چکباکس تأیید نمایش داده شده را تکمیل کنید. نتیجه شناساییشده را با تصویر منبع مقایسه کنید. فایل دانلودی ما بهدرستی شامل Overview، Plan the session و Define the outcome است.
قبل از کپی یا دانلود متن، نامها، اعداد و کلمات نامطمئن را اصلاح کنید. اصلاحات، خروجیهای قابل ویرایش را بهروزرسانی میکنند؛ PDF قابل جستجوی Classic، شناسایی اصلی را حفظ میکند، بنابراین آن فایل را جداگانه بررسی کنید.
متن شناساییشده را با Smart edit بهبود ببخشید
برای نتیجه TXT یا Word، گزینه Smart edit را در کنار Copy انتخاب کنید. بخشی را برای کار روی آن متن انتخاب کنید، یا هیچچیز را انتخاب نکنید تا از کل پیشنویس استفاده شود. Summarize text، Paraphrase text، Fix grammar یا Suggest a title را انتخاب کرده و سپس Apply را بزنید. عملیات عنوان، یک سرتیتر به بالای متن اضافه میکند.
هر تغییر هوش مصنوعی را با فایل اسکنشده چک کنید، بهویژه نامها، اعداد و کلمات جا افتاده. پیشنهاد تا زمانی که Apply Changes را انتخاب نکنید در Smart edit باقی میماند. دانلودهای TXT و Word سپس از متن ساده ویرایششده استفاده میکنند. Formatted copy یک فایل HTML جداگانه با استایل ویرایشگر دانلود میکند؛ فایل اسکنشده اصلی و لایه متنی PDF قابل جستجوی Classic تغییر نمیکنند.
سوالات متداول
آیا میتوانم فقط یک پاراگراف را شناسایی کنم؟
بله. قبل از شروع، یک مستطیل دور آن انتخاب کنید. لبهها را چک کنید تا متنهای اطراف حذف شوند و کلمات مهم قطع نشوند.
آیا Future طراحی اصلی صفحه را در PDF خود حفظ میکند؟
PDF آن یک سند فقط متنی با چیدمان مجدد است. زمانی که هدف حفظ تصویر صفحه اسکنشده همراه با لایه متنی است، PDF قابل جستجوی Classic را انتخاب کنید.
آیا Smart edit میتواند PDF قابل جستجو را تغییر دهد؟
خیر. Smart edit با نتایج TXT و Word در دسترس است. Apply Changes متن قابل ویرایش را بهروز میکند؛ این کار صفحه اسکنشده یا PDF قابل جستجوی تولیدشده قبلی را بازنویسی نمیکند.
آن را با سند خود امتحان کنید
نتیجه را بازبینی کرده و سپس نسخه مورد نیاز خود را ذخیره کنید.