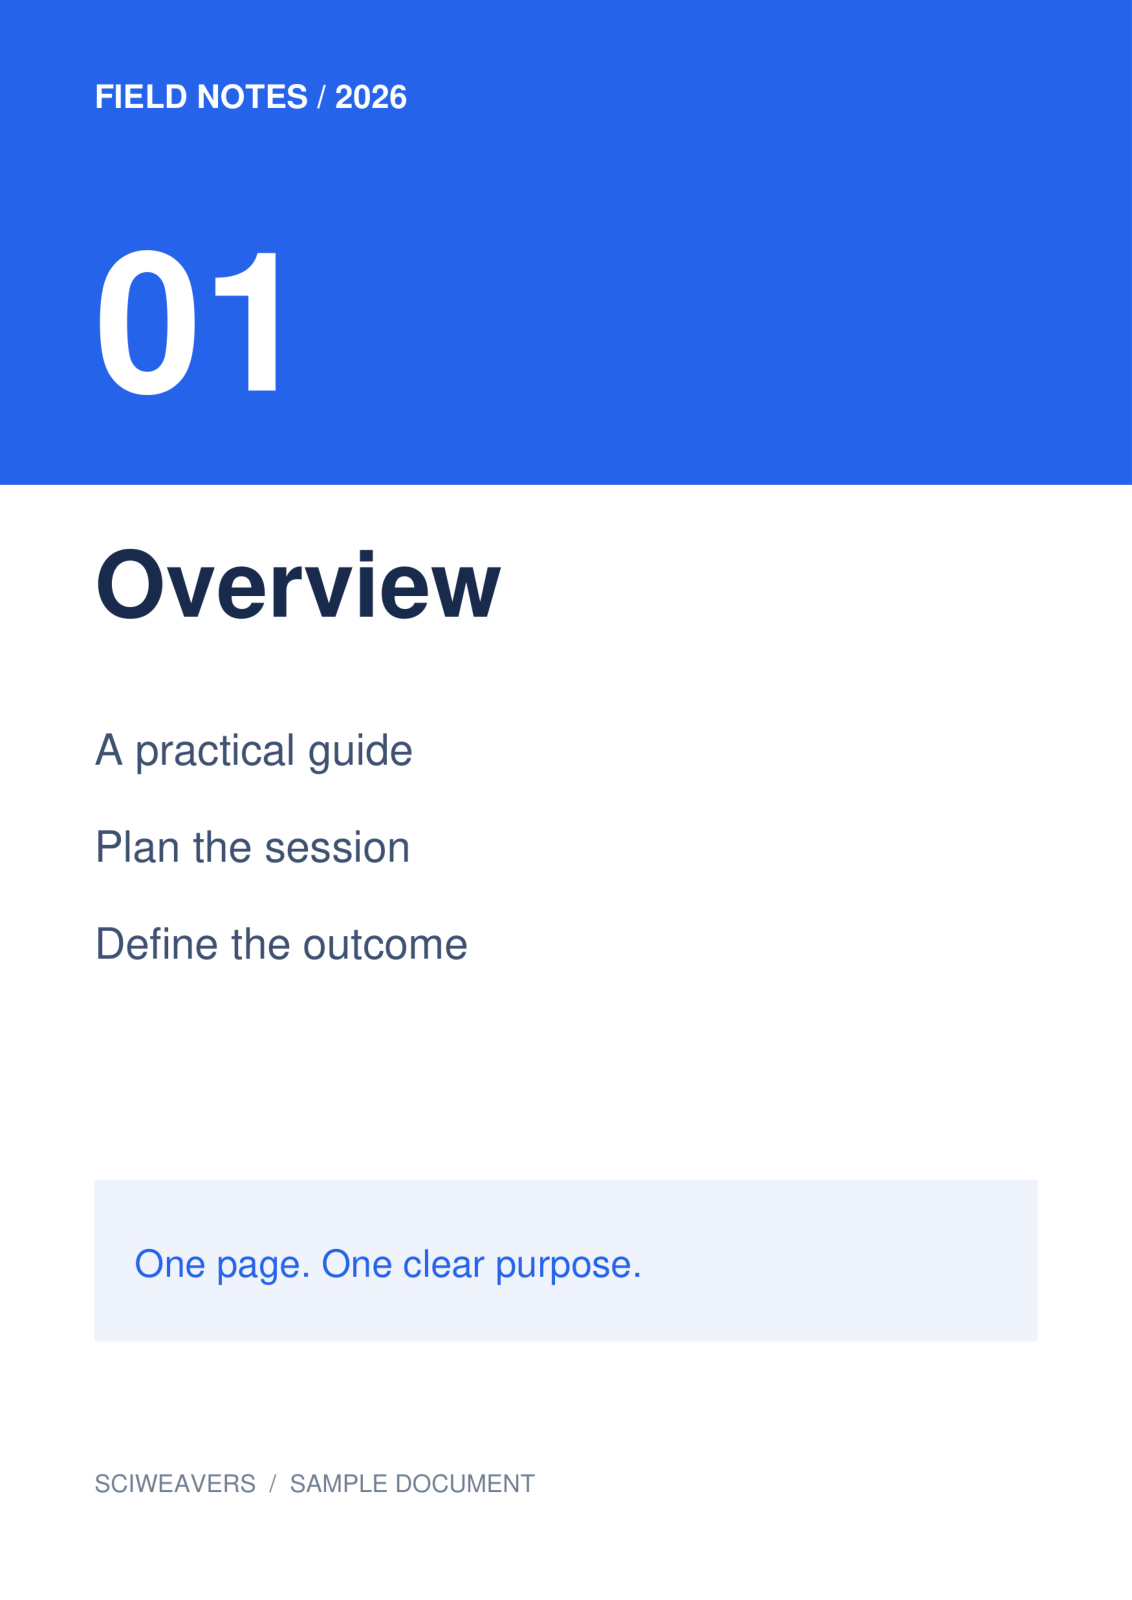
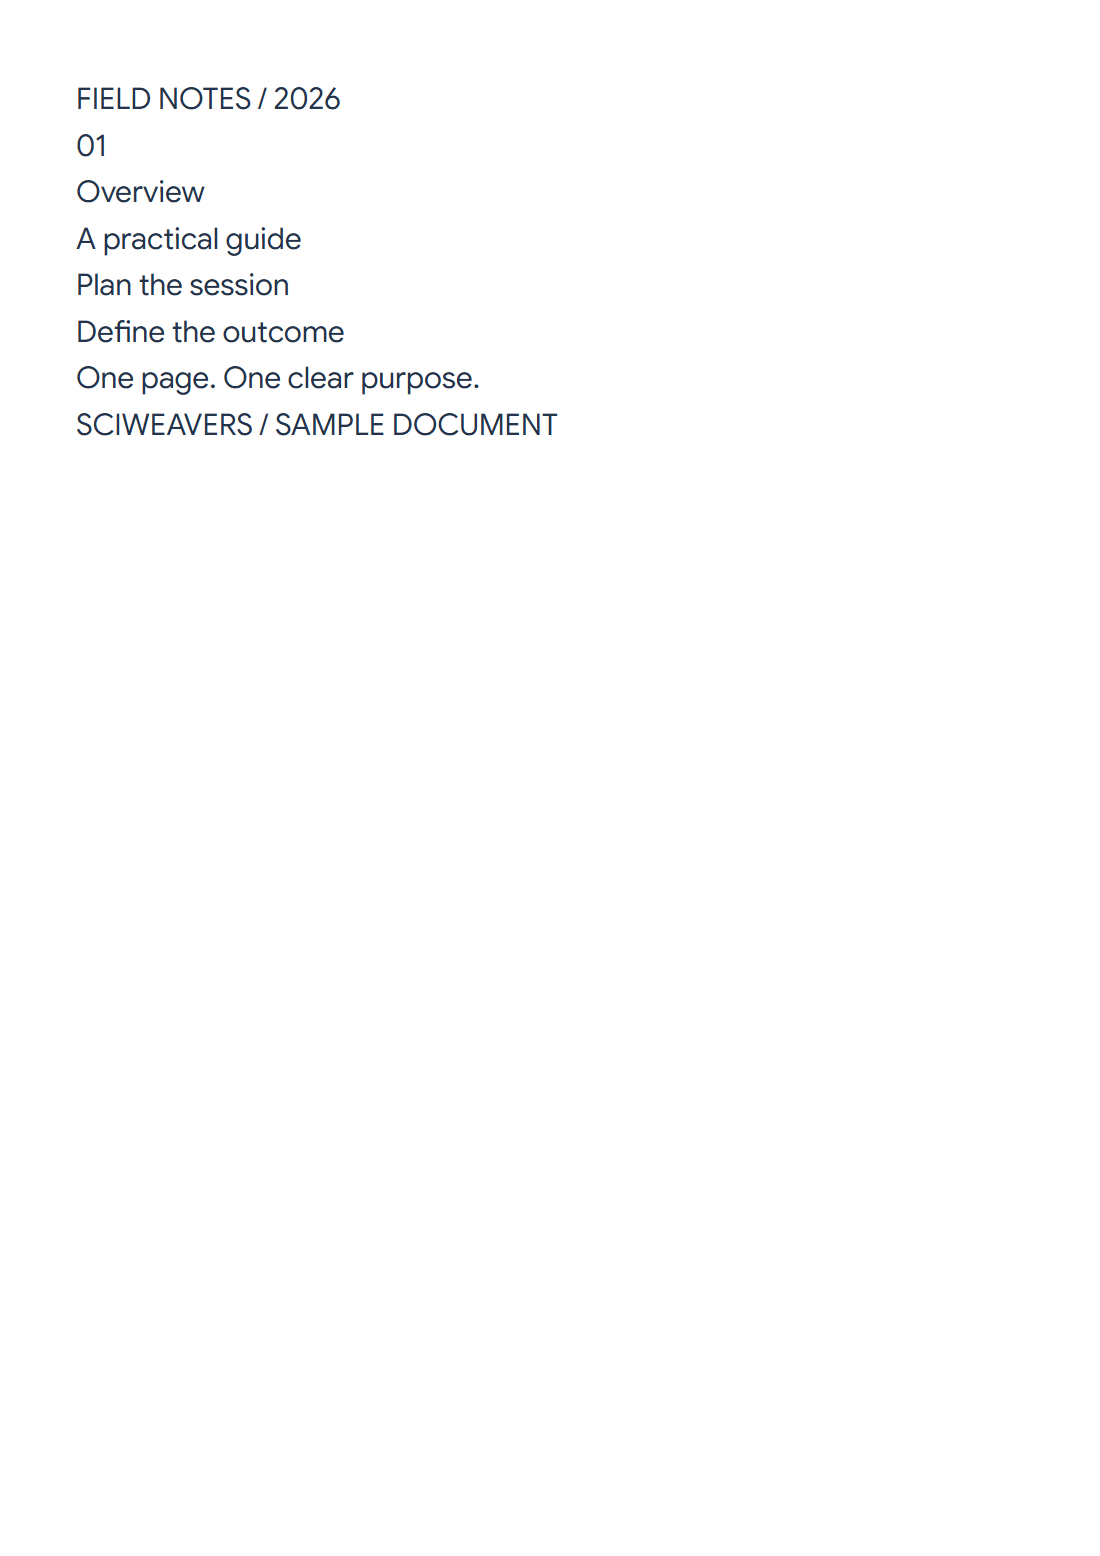

Gebruik PDF OCR om woorden uit pagina-afbeeldingen te herkennen. Ons voorbeeld begint met een scan van vier pagina's die alleen uit afbeeldingen bestaat en herkent de eerste pagina, Overzicht, naar bewerkbare tekst.
Kies een pagina of gebied
Laad de PDF en navigeer naar de pagina die je nodig hebt. Gebruik de hele pagina of pas een selectierechthoek aan rond de benodigde tekst. Het voorbeeld gebruikt de volledige pagina 1.
Een andere pagina of een ander gebied vereist een afzonderlijke herkenningsactie. De tool verwerkt niet automatisch elke pagina van de geüploade PDF.
Kies taal, engine en formaat
Kies de taal die op de pagina is afgedrukt. Voor ons Engelse voorbeeld behoud je Future als de OCR-engine en kies je Bewerkbare tekst (.txt).
Kies Classic wanneer je een doorzoekbare PDF nodig hebt, die de bronafbeelding behoudt met een onzichtbare laag met herkende tekst. Future biedt bewerkbare tekst, Word en een opnieuw ingedeelde PDF met alleen tekst.
Herkennen, corrigeren en downloaden
Kies Start en voltooi het weergegeven verificatievakje. Vergelijk het herkende resultaat met de bronafbeelding. Onze download bevat correct Overzicht, Plan de sessie en Definieer het resultaat.
Corrigeer namen, cijfers en onzekere woorden voordat je tekst kopieert of downloadt. Correcties worden bijgewerkt in bewerkbare exports; de gepositioneerde doorzoekbare PDF van Classic behoudt de oorspronkelijke herkenning, dus controleer dat bestand afzonderlijk.
Verfijn de herkende tekst met Slim bewerken
Voor een TXT- of Word-resultaat kies je Slim bewerken naast Kopiëren. Selecteer een passage om aan die tekst te werken, of laat niets geselecteerd om het hele concept te gebruiken. Kies Tekst samenvatten, Tekst parafraseren, Grammatica corrigeren of Titel voorstellen en kies vervolgens Toepassen. De titelactie voegt een kop toe boven de tekst.
Controleer elke AI-wijziging aan de hand van de scan, vooral namen, cijfers en ontbrekende woorden. De suggestie blijft in Slim bewerken totdat je Wijzigingen toepassen kiest. TXT- en Word-downloads gebruiken daarna de bewerkte platte tekst. Geformatteerde kopie downloadt een afzonderlijk HTML-bestand met editor-opmaak; de oorspronkelijke scan en de tekstlaag van de doorzoekbare Classic PDF veranderen niet.
Veelgestelde vragen
Kan ik slechts één alinea herkennen?
Ja. Selecteer er een rechthoek omheen voordat je begint. Controleer de randen zodat nabijgelegen tekst wordt uitgesloten en belangrijke woorden niet worden afgesneden.
Behoudt Future het oorspronkelijke paginaontwerp in de PDF?
De PDF hiervan is een opnieuw ingedeeld document met alleen tekst. Kies de doorzoekbare PDF van Classic wanneer het doel is om de gescande pagina-afbeelding met een tekstlaag te behouden.
Kan Slim bewerken de doorzoekbare PDF wijzigen?
Nee. Slim bewerken is beschikbaar bij TXT- en Word-resultaten. Wijzigingen toepassen werkt de bewerkbare tekst bij; het herschrijft niet de gescande pagina of een eerder gegenereerde doorzoekbare PDF.
Probeer het met jouw document
Controleer het resultaat en sla vervolgens de versie op die je nodig hebt.