

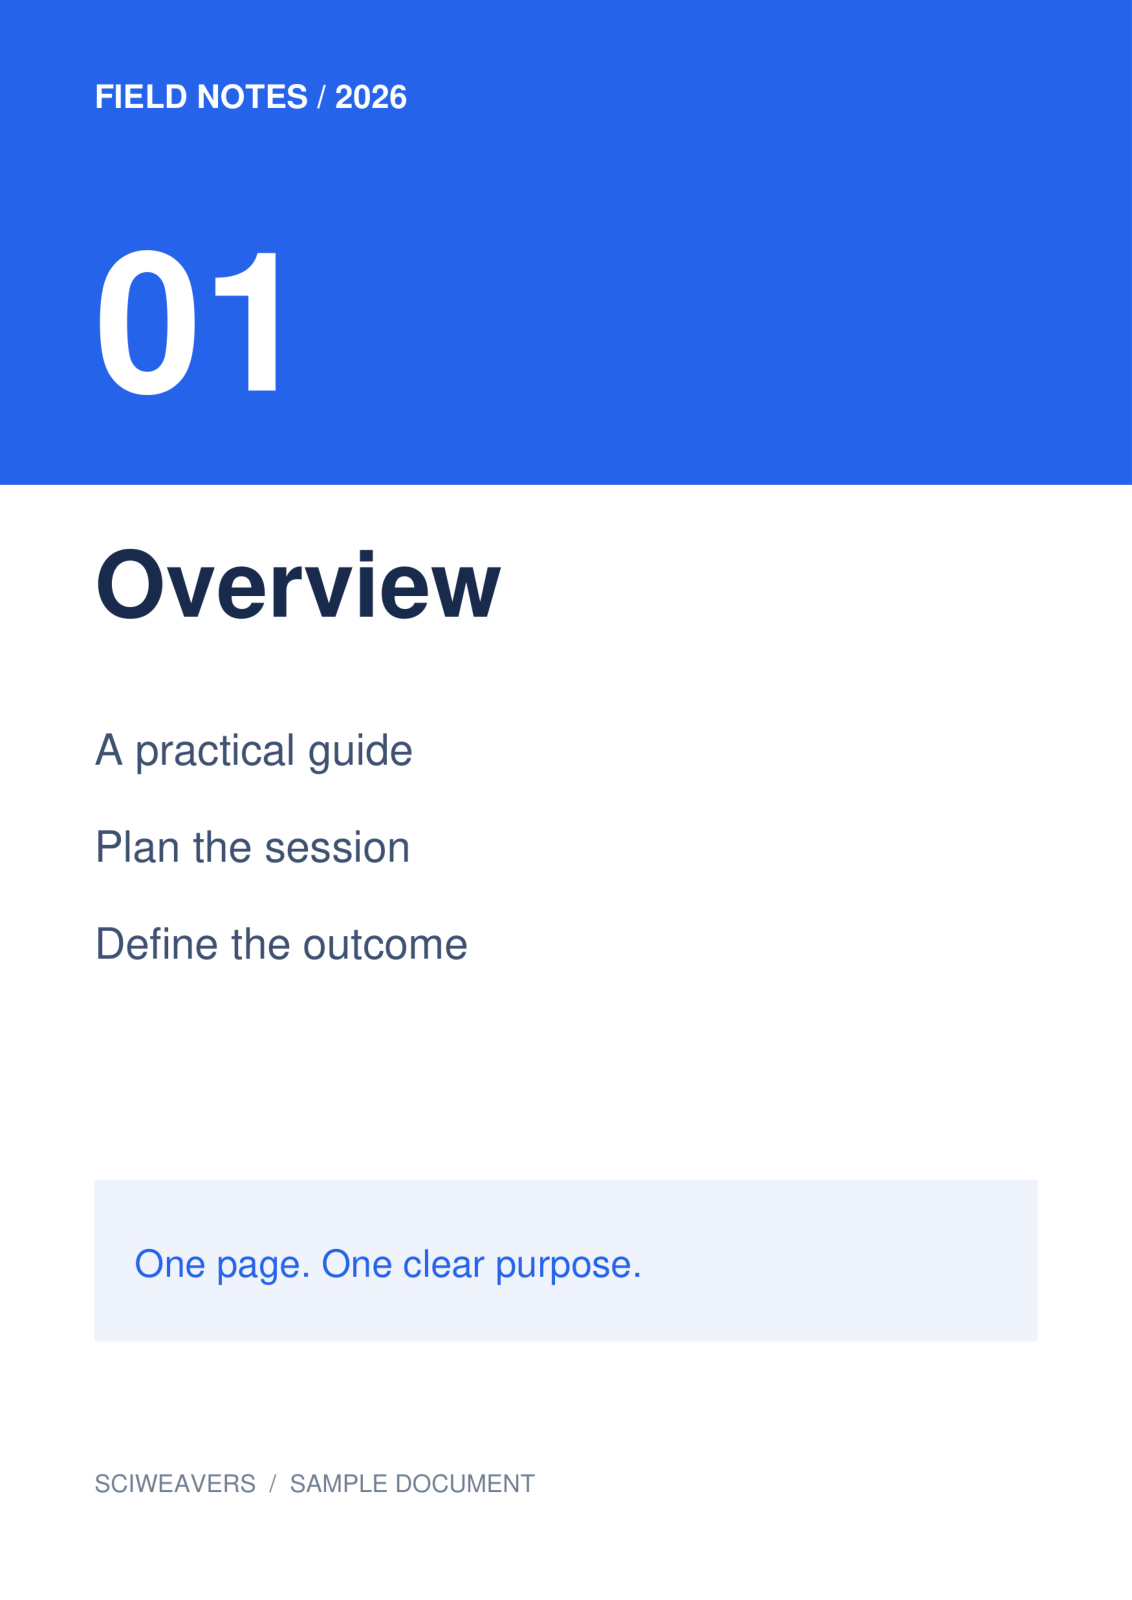
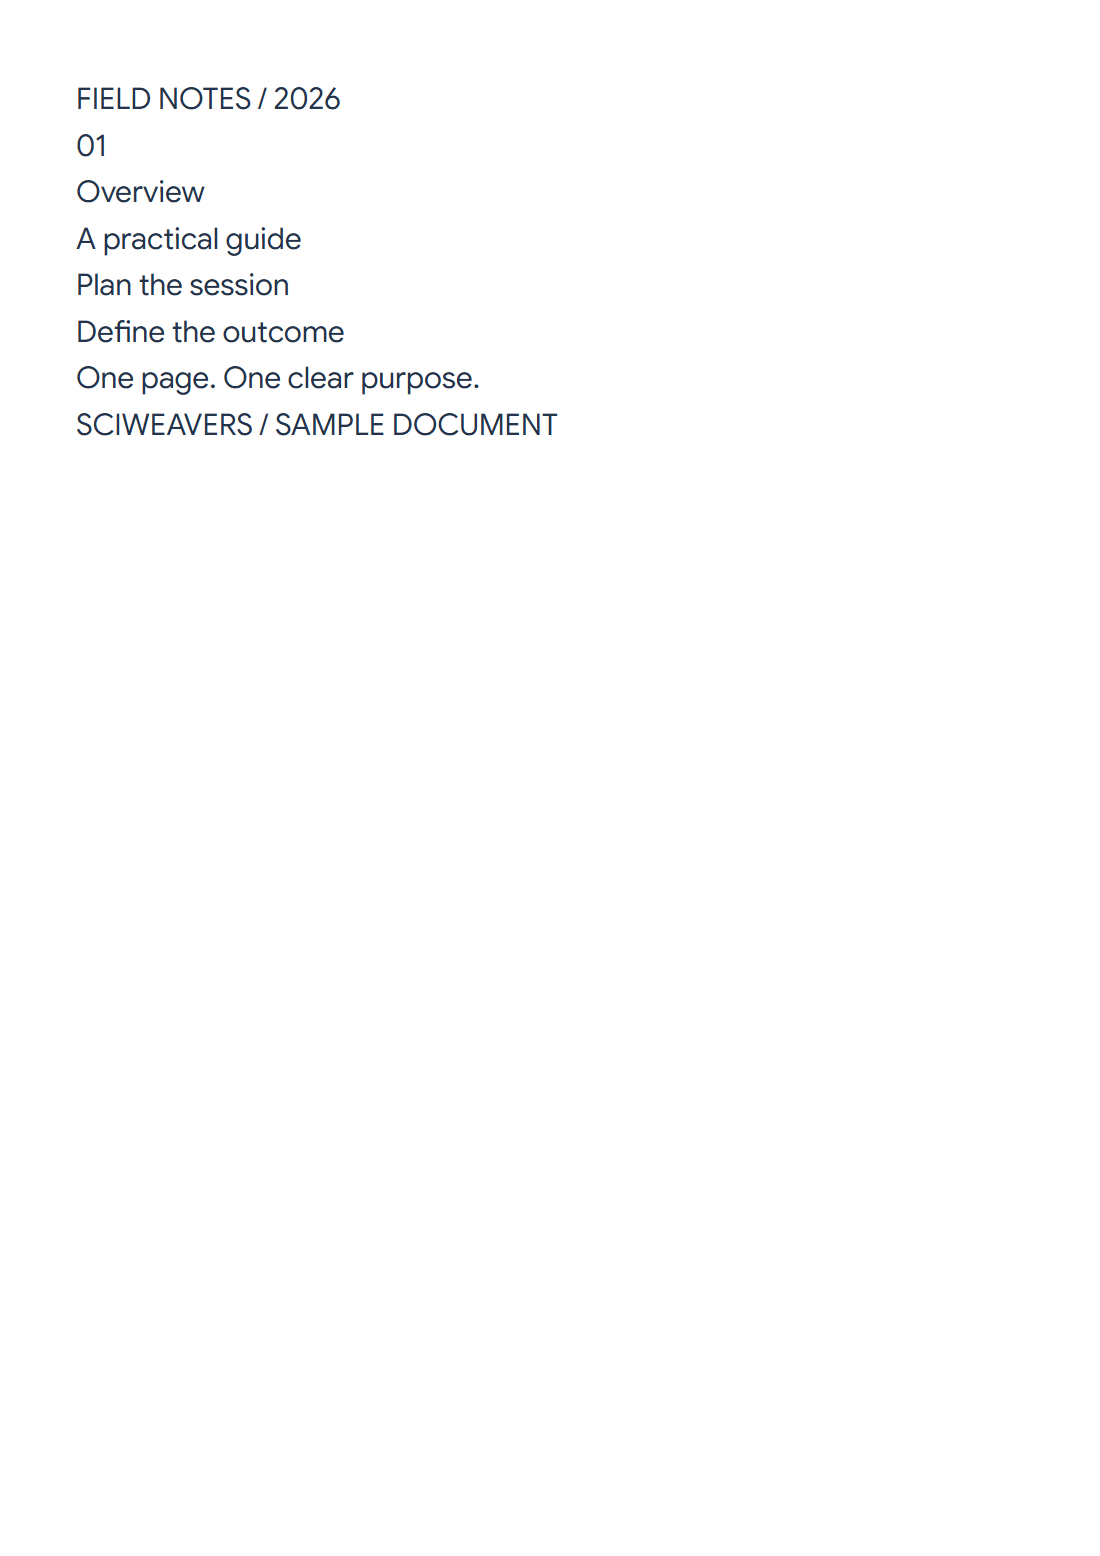

Используйте PDF OCR для распознавания слов из изображений страниц. Наш пример начинается с четырехстраничного скана, состоящего только из изображений, и распознает его первую страницу, Overview, в редактируемый текст.
Выберите страницу или область
Загрузите PDF и перейдите на нужную страницу. Используйте всю страницу или настройте прямоугольник выделения вокруг нужного текста. В примере используется вся страница 1.
Для другой страницы или области требуется отдельное действие распознавания. Инструмент не обрабатывает автоматически все страницы загруженного PDF.
Для бледного или испачканного скана выберите Улучшить изображение над предварительным просмотром страницы. Отрегулируйте яркость, контрастность или очистку фона; используйте ластик или нарисуйте прямоугольник, чтобы удалить ненужные пометки. Сравните Оригинал и Улучшено, а затем выберите Применить изменения. Правки применяются к текущей странице. Проверьте выбор перед запуском OCR.
Выберите язык, движок и формат
Выберите язык, напечатанный на странице. Для нашего английского примера оставьте Future в качестве движка OCR и выберите Editable text (.txt).
Выберите Classic, если вам нужен PDF с возможностью поиска, который сохраняет исходное изображение со скрытым слоем распознанного текста. Future предоставляет редактируемый текст, Word и PDF только с текстом с перекомпоновкой.
Распознайте, исправьте и скачайте
Выберите Start и выполните отображаемую проверку. Сравните распознанный результат с исходным изображением. Наш файл для скачивания правильно включает Overview, Plan the session и Define the outcome.
Исправьте имена, цифры и сомнительные слова перед копированием или скачиванием текста. Исправления обновляют редактируемые экспорты; PDF с возможностью поиска в Classic сохраняет исходное распознавание, поэтому проверяйте этот файл отдельно.
Улучшите распознанный текст с помощью Smart edit
Для получения результата в формате TXT или Word выберите Smart edit рядом с Copy. Выделите фрагмент для работы с этим текстом или оставьте выделение пустым, чтобы использовать весь черновик. Выберите Summarize text, Paraphrase text, Fix grammar или Suggest a title, затем выберите Apply. Действие с заголовком добавляет заголовок над текстом.
Проверяйте каждое изменение ИИ по скану, особенно имена, цифры и пропущенные слова. Предложение остается в Умное редактирование, пока вы не выберете Применить изменения. Загрузки TXT и Word затем используют отредактированный обычный текст. Умное редактирование по умолчанию загружает Word (.docx); выберите PDF или HTML для получения другой отформатированной копии. Исходный скан и текстовый слой Классический с возможностью поиска PDF не изменяются.
Часто задаваемые вопросы
Можно ли распознать только один абзац?
Да. Выделите прямоугольник вокруг него перед началом. Проверьте края, чтобы соседний текст был исключен, а важные слова не были обрезаны.
Сохранит ли Future исходный дизайн страницы в своем PDF?
Его PDF — это перекомпонованный документ только с текстом. Выбирайте PDF с возможностью поиска в Classic, если цель — сохранить изображение отсканированной страницы со слоем текста.
Может ли Smart edit изменить PDF с возможностью поиска?
Нет. Smart edit доступен для результатов в формате TXT и Word. Apply Changes обновляет редактируемый текст; он не перезаписывает отсканированную страницу или ранее созданный PDF с возможностью поиска.
Попробуйте на своем документе
Проверьте результат, затем сохраните нужную версию.


