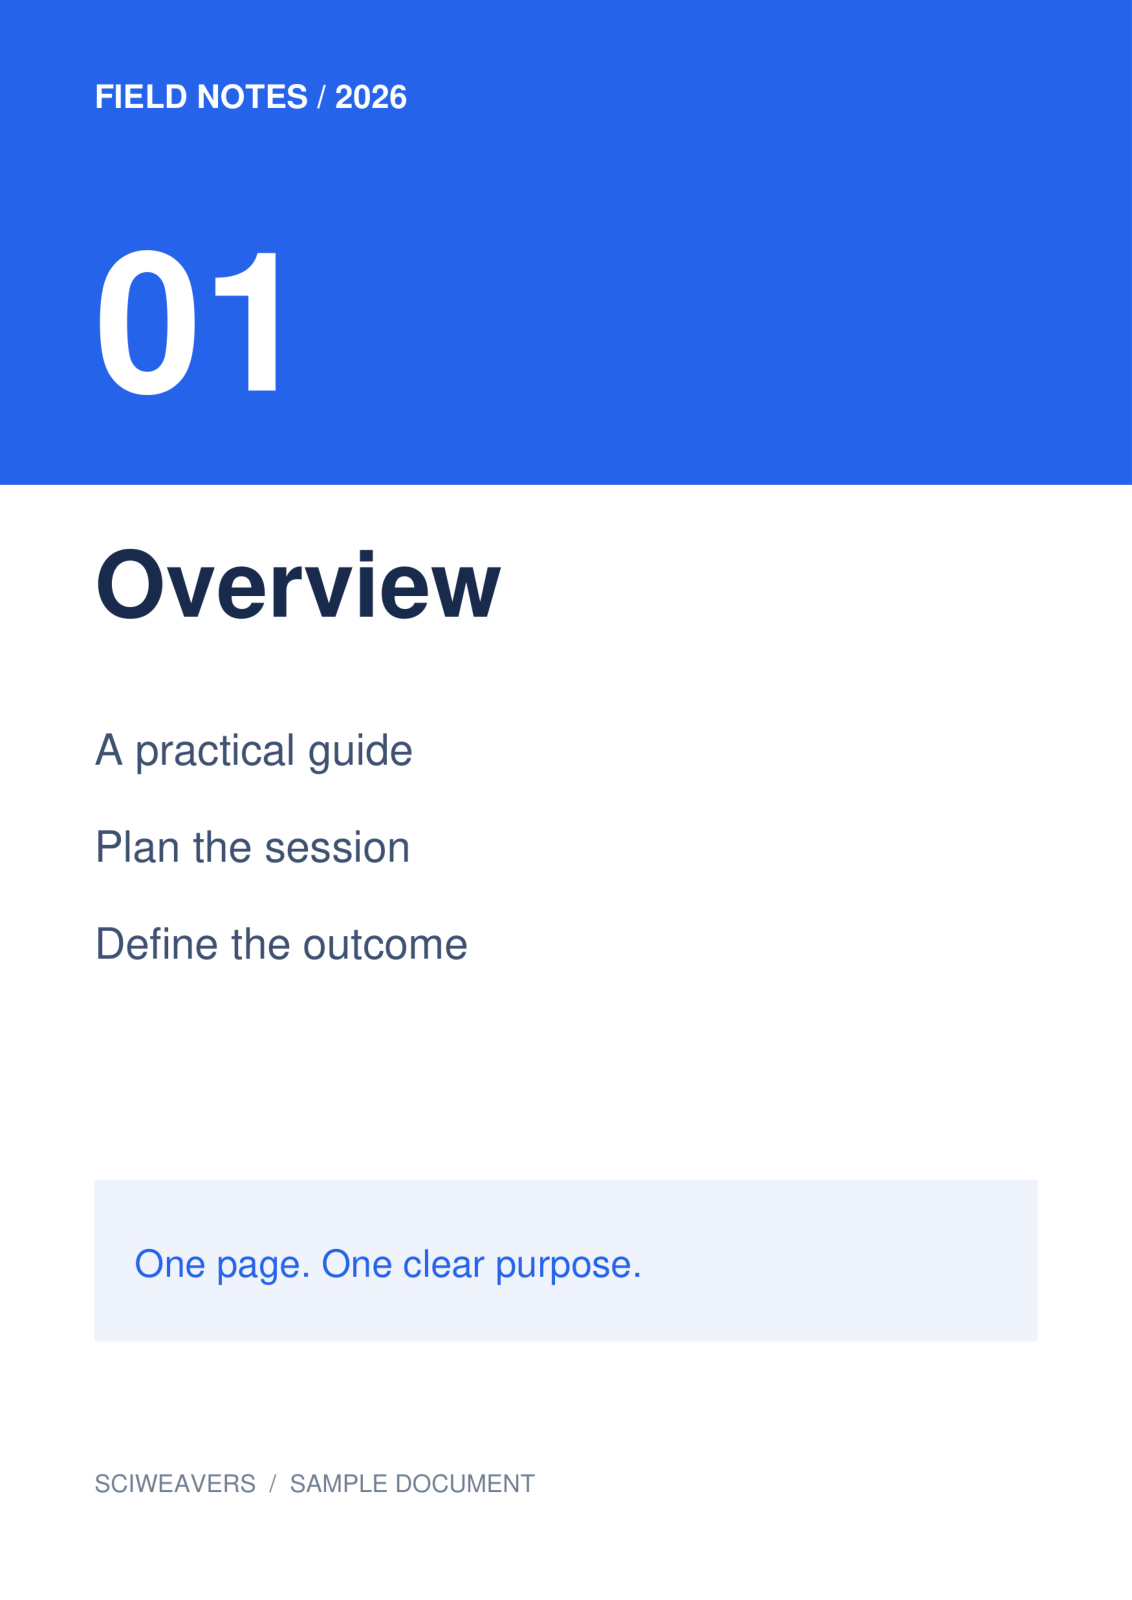
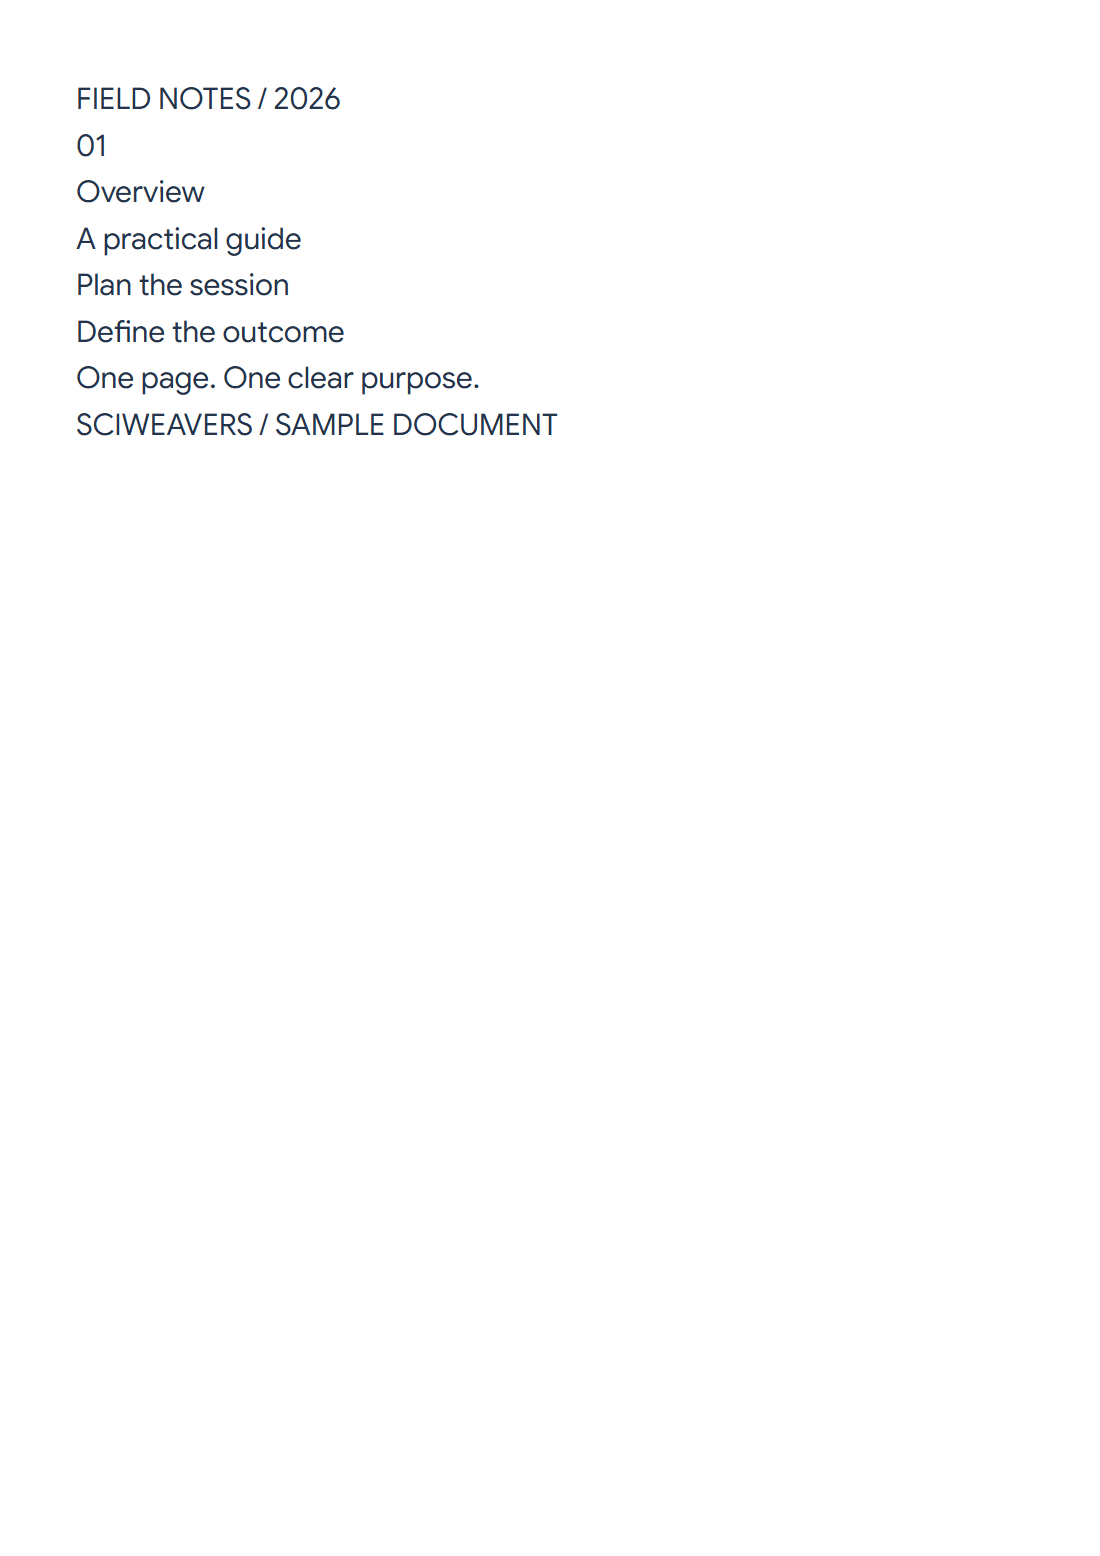

Use PDF OCR para reconhecer palavras a partir de imagens de página. Nosso exemplo começa com uma digitalização de quatro páginas contendo apenas imagens e reconhece sua primeira página, Visão geral, em texto editável.
Escolha uma página ou área
Carregue o PDF e navegue até a página necessária. Use a página inteira ou ajuste um retângulo de seleção ao redor do texto desejado. O exemplo usa toda a página 1.
Outra página ou área requer uma ação de reconhecimento separada. A ferramenta não processa automaticamente todas as páginas do PDF carregado.
Escolha idioma, mecanismo e formato
Escolha o idioma impresso na página. Para nosso exemplo em inglês, mantenha Future como o mecanismo de OCR e escolha Texto editável (.txt).
Escolha Classic quando precisar de seu PDF pesquisável, que retém a imagem original com uma camada de texto reconhecido invisível. O Future fornece texto editável, Word e um PDF apenas de texto com fluxo refeito.
Reconhecer, corrigir e baixar
Escolha Iniciar e complete a caixa de seleção de verificação exibida. Compare o resultado reconhecido com a imagem original. Nosso download inclui corretamente Visão geral, Planejar a sessão e Definir o resultado.
Corrija nomes, números e palavras incertas antes de copiar ou baixar o texto. As correções atualizam as exportações editáveis; o PDF pesquisável posicionado do Classic retém o reconhecimento original, portanto, revise esse arquivo separadamente.
Refine o texto reconhecido com a Edição inteligente
Para um resultado em TXT ou Word, escolha Edição inteligente ao lado de Copiar. Selecione uma passagem para trabalhar nesse texto ou não deixe nada selecionado para usar o rascunho inteiro. Escolha Resumir texto, Parafrasear texto, Corrigir gramática ou Sugerir um título, e então escolha Aplicar. A ação de título adiciona um cabeçalho acima do texto.
Verifique cada alteração da IA em relação à digitalização, especialmente nomes, números e palavras ausentes. A sugestão permanece na Edição inteligente até que você escolha Aplicar alterações. Os downloads em TXT e Word usam então o texto simples editado. Cópia formatada baixa um arquivo HTML separado com estilo do editor; a digitalização original e a camada de texto do PDF pesquisável Classic não mudam.
Perguntas comuns
Posso reconhecer apenas um parágrafo?
Sim. Selecione um retângulo ao redor dele antes de começar. Verifique as bordas para que o texto próximo seja excluído e palavras importantes não sejam cortadas.
O Future manterá o design original da página em seu PDF?
Seu PDF é um documento apenas de texto com fluxo refeito. Escolha o PDF pesquisável do Classic quando o objetivo for reter a imagem da página digitalizada com uma camada de texto.
A Edição inteligente pode alterar o PDF pesquisável?
Não. A Edição inteligente está disponível com resultados em TXT e Word. Aplicar alterações atualiza o texto editável; não reescreve a página digitalizada ou um PDF pesquisável gerado anteriormente.
Experimente com seu documento
Revise o resultado e salve a versão que você precisa.