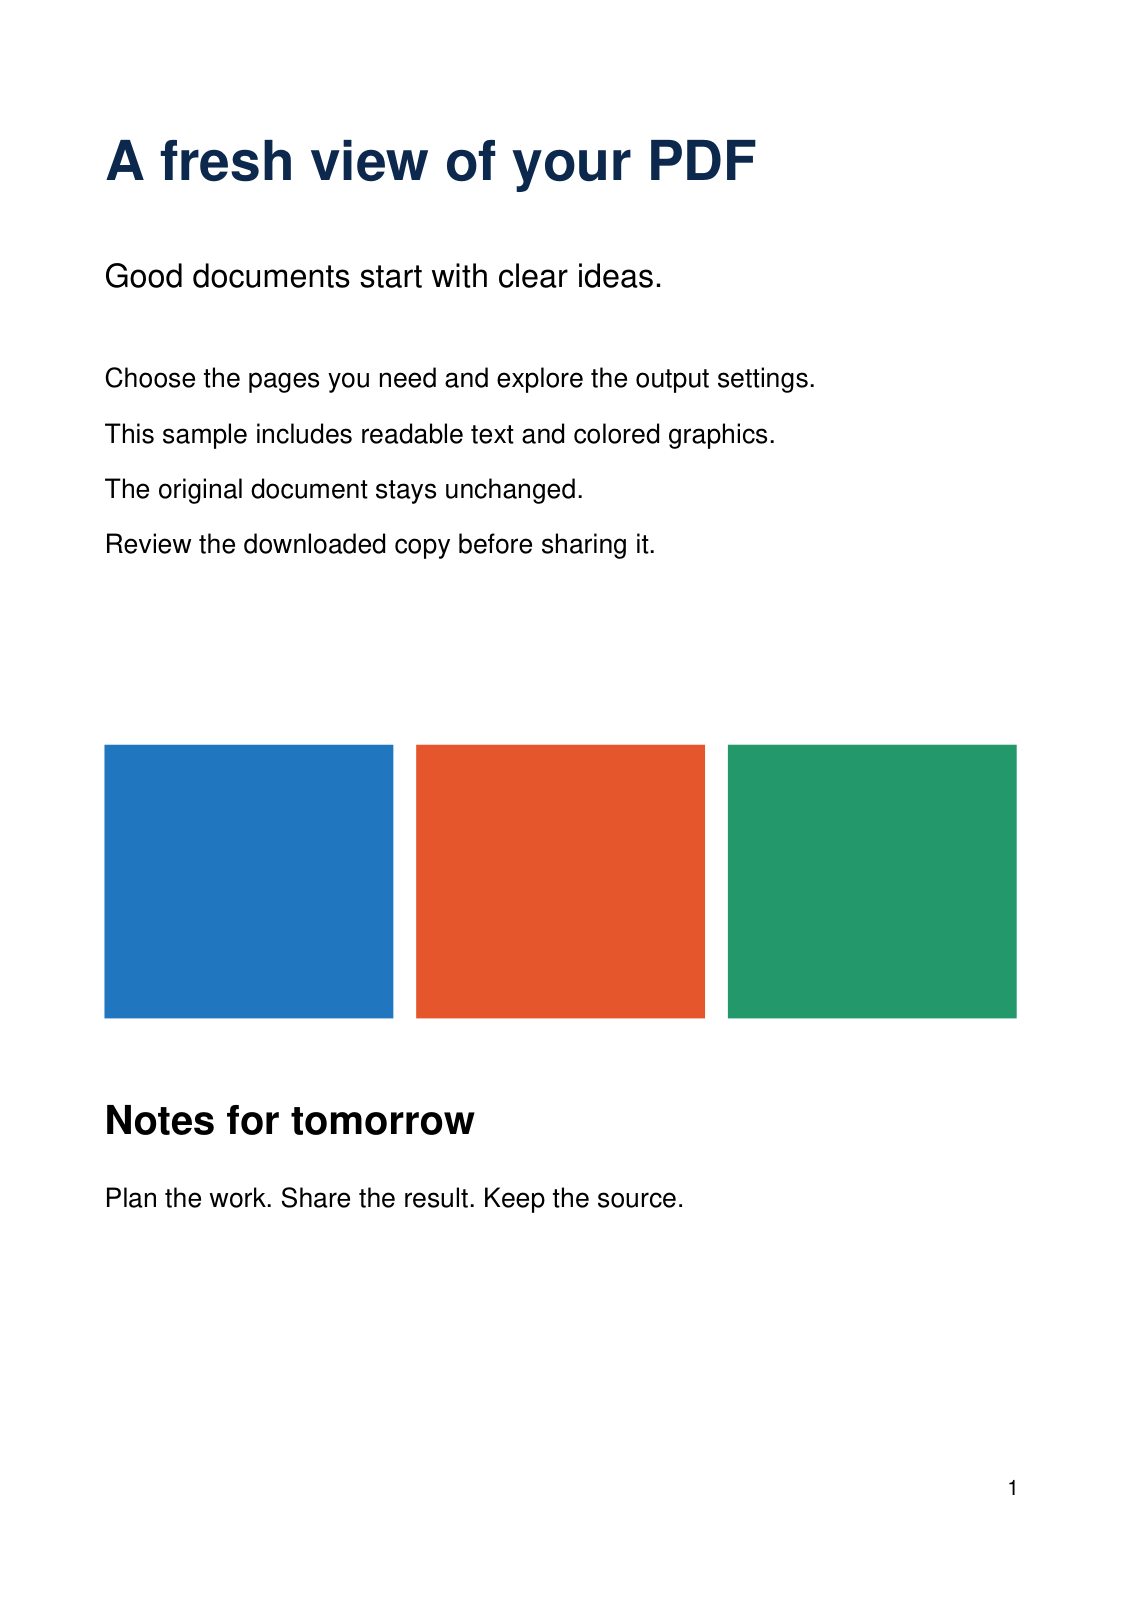
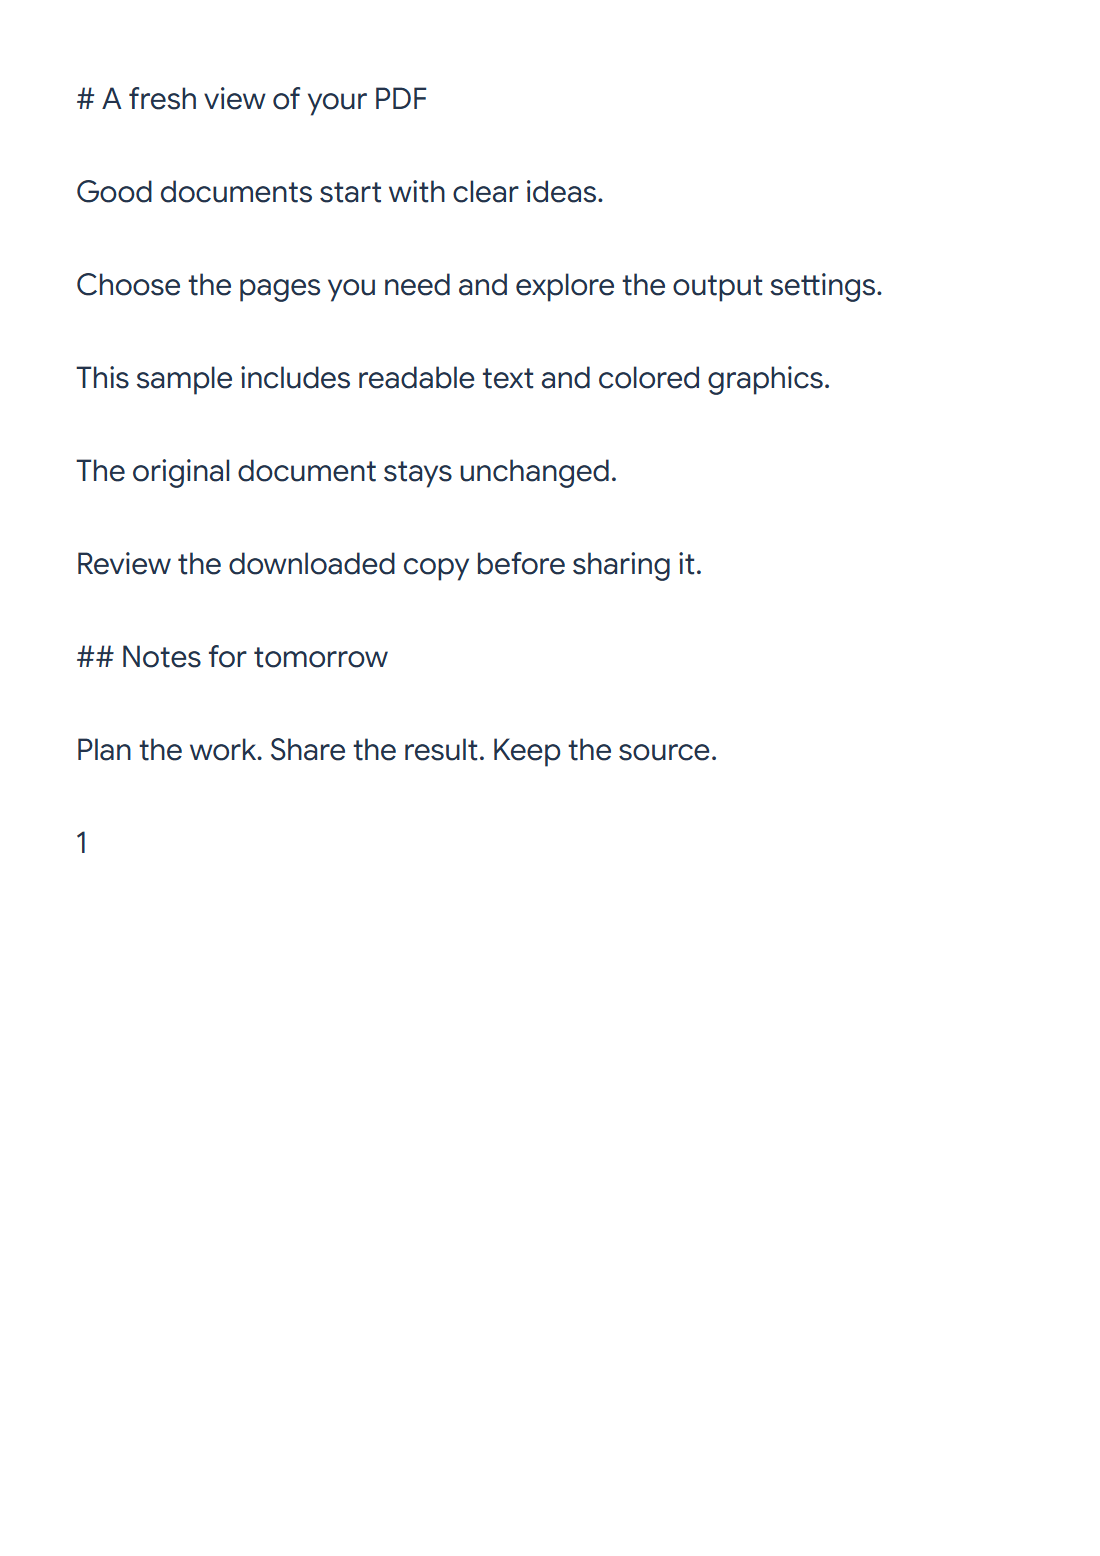

Используйте PDF в Markdown для извлечения текста и возможных заголовков, затем проверьте редактируемый исходный код. Наш двухстраничный образец экспортирует Markdown-документ размером 700 байт.
Выберите исходные страницы
Загрузите PDF и оставьте Страницы для обработки пустыми для обеих страниц образца или введите диапазон. Отсканированные изображения требуют OCR перед этим текстовым преобразованием.
Конвертируйте и проверьте Markdown
Выберите Начать. Результаты показывают редактируемый Markdown и визуализированный Предварительный просмотр. На узком экране переключайтесь между их вкладками.
Основной заголовок образца становится заголовком первого уровня, а «Заметки на завтра» — заголовком второго уровня. Определение использует размер текста, поэтому крупная декоративная надпись может потребовать корректировки.
Отредактируйте структуру и скачайте
Исправьте уровни заголовков, интервалы, списки и порядок чтения в исходном коде. Предварительный просмотр обновляется по мере редактирования. Элементы управления форматированием помогают добавить акценты, списки и явные ссылки.
Скопируйте или скачайте .md, когда исходный код и предварительный просмотр совпадут. Эти действия используют отредактированный исходный код; исходный PDF остается без изменений.
Часто задаваемые вопросы
Почему заголовок получил неверный уровень?
Экстрактор использует размер текста, а не понимание полной структуры документа. Настройте маркеры # и проверьте Предварительный просмотр.
Получает ли Предварительный просмотр связанные изображения?
Текущий предварительный просмотр отображает ссылки на изображения как текст без загрузки удаленных изображений. Просмотрите их в приложении, где вы позже опубликуете Markdown.
Попробуйте с вашим документом
Проверьте результат, затем сохраните нужную версию.