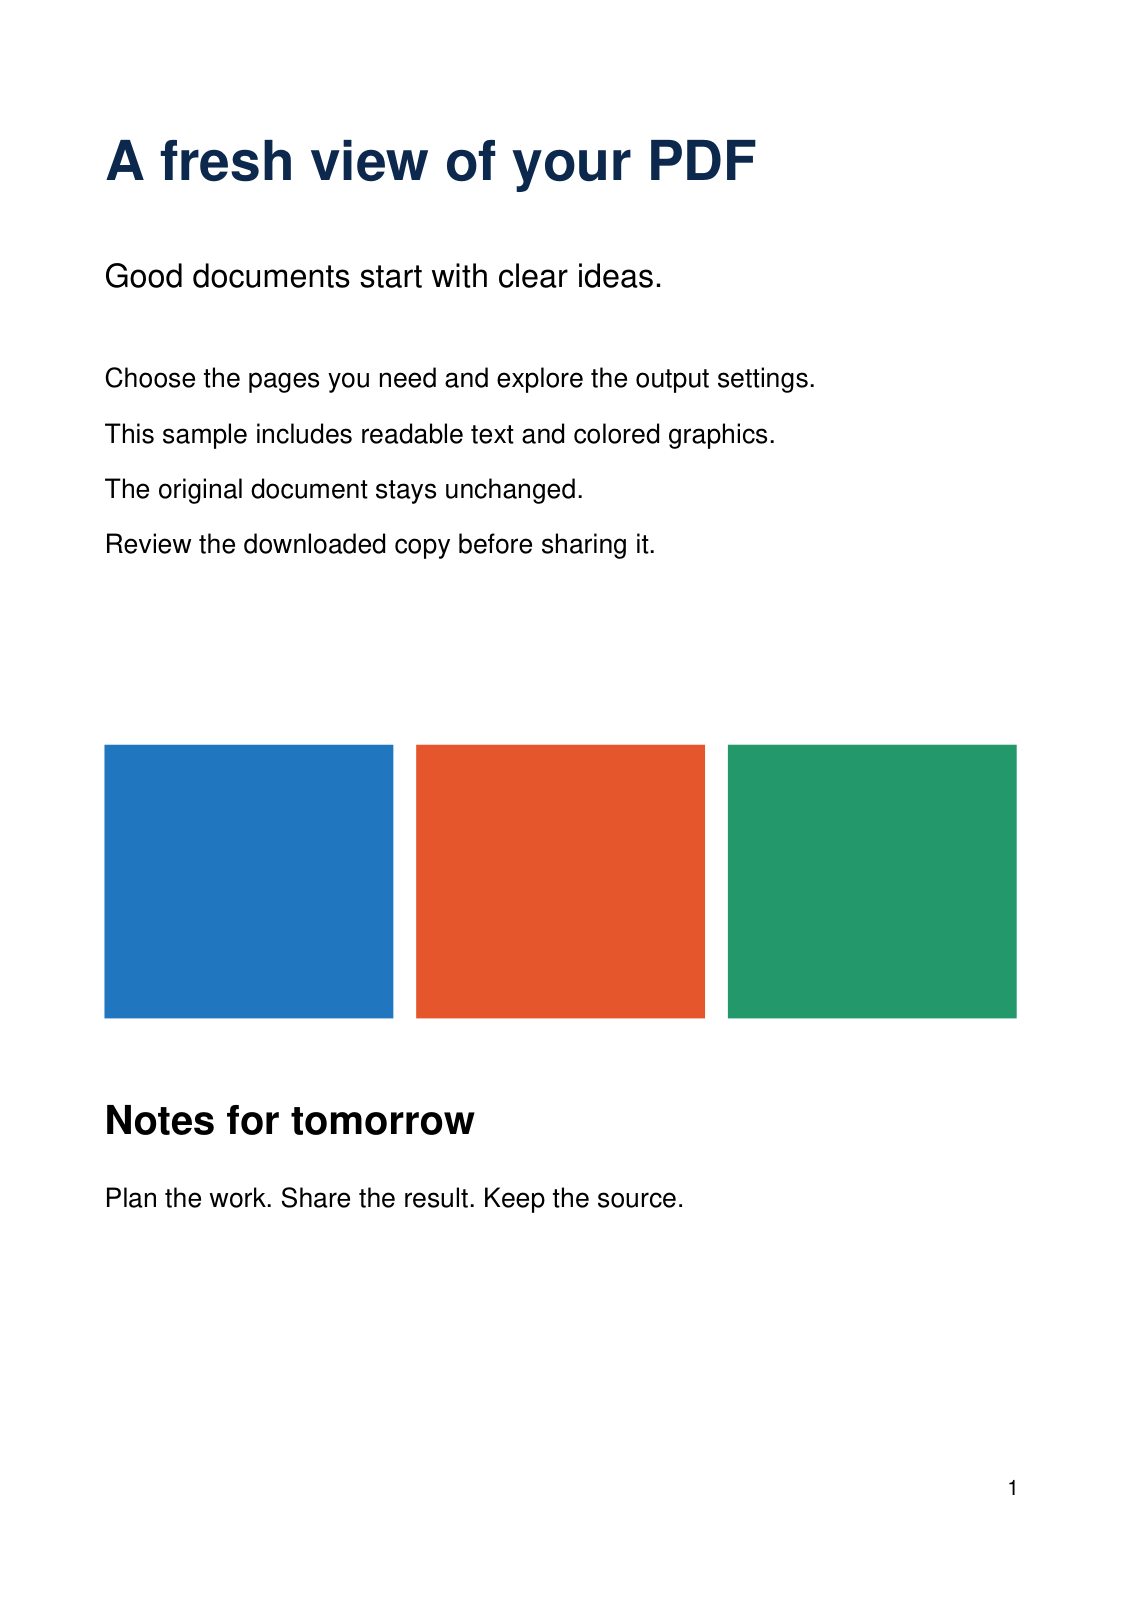
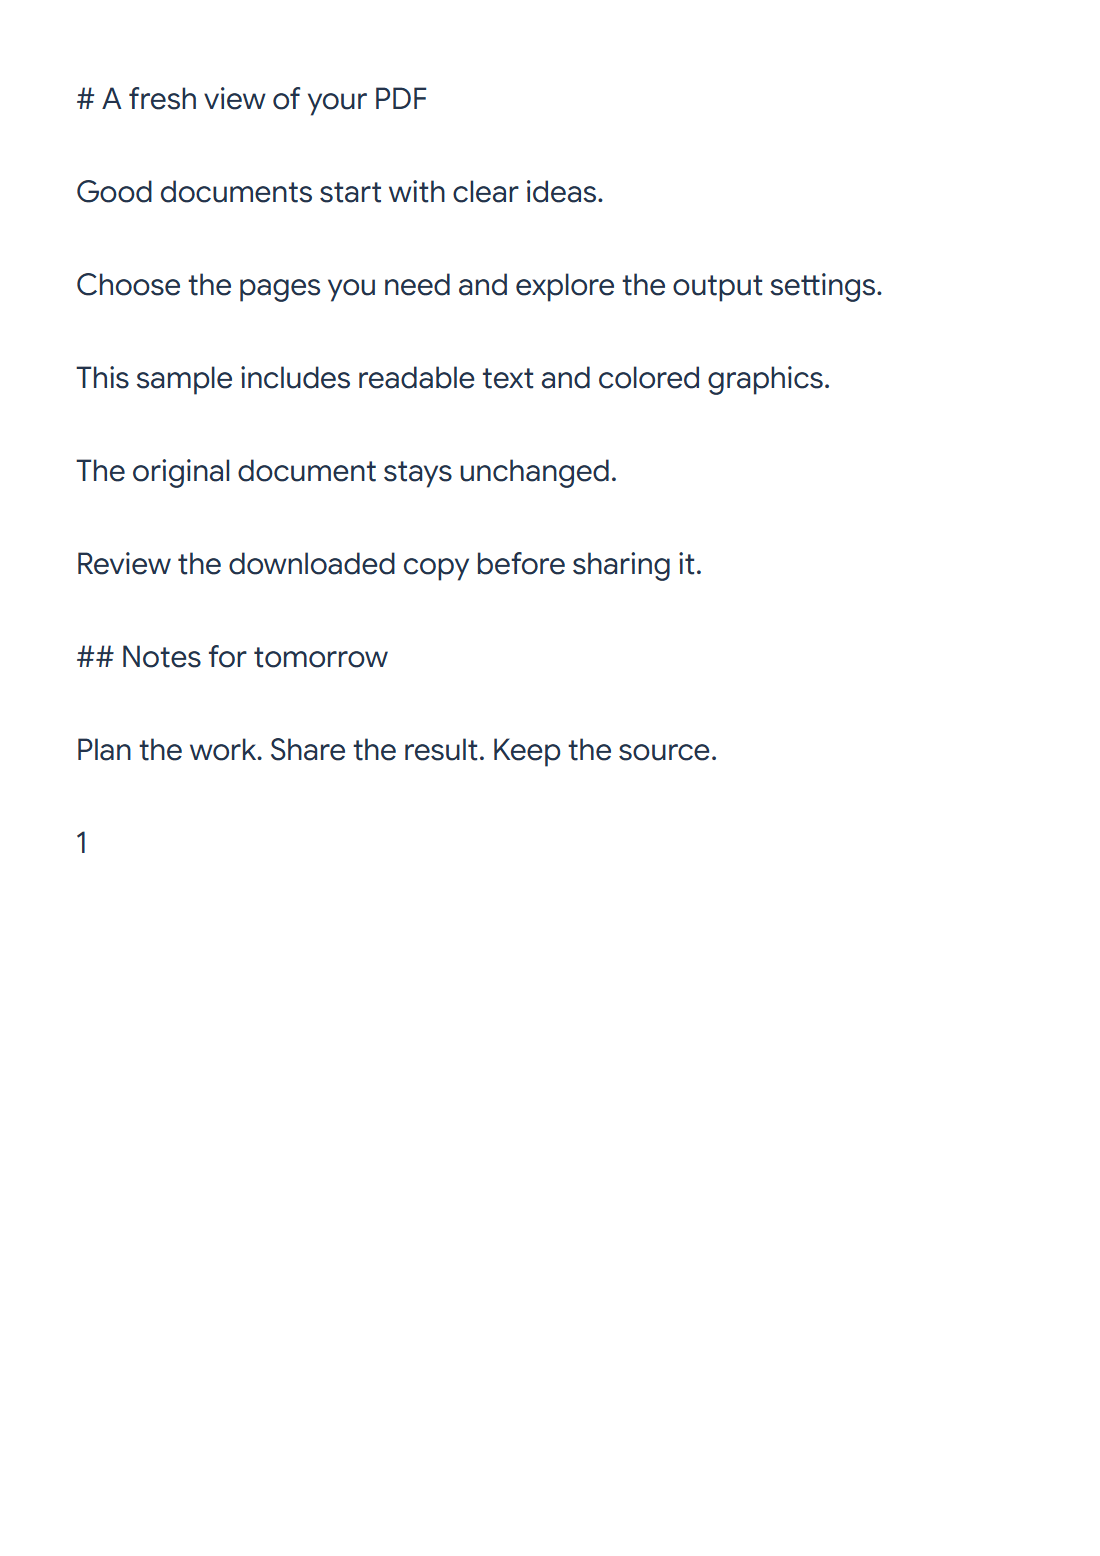

Použijte PDF do Markdownu k extrakci textu a pravděpodobných nadpisů, poté zkontrolujte upravitelný zdroj. Náš dvoustránkový vzorek exportuje 700bajtový dokument Markdown.
Vyberte zdrojové stránky
Načtěte PDF a ponechte Stránky ke zpracování prázdné pro obě vzorové stránky, nebo zadejte rozsah. Skenované obrázky vyžadují před touto textovou konverzí OCR.
Převeďte a zkontrolujte Markdown
Zvolte Start. Výsledky zobrazí upravitelný Markdown a vykreslený Náhled. Na úzké obrazovce přepínejte mezi jejich kartami.
Hlavní název vzorku se stane nadpisem první úrovně a „Poznámky na zítřek“ se stanou nadpisem druhé úrovně. Detekce využívá velikost textu, takže velký dekorativní popisek může vyžadovat opravu.
Upravte strukturu a stáhněte
Opravte úrovně nadpisů, mezery, seznamy a pořadí čtení ve zdroji. Náhled se při úpravách aktualizuje. Formátovací ovládací prvky pomáhají přidat důraz, seznamy a explicitní odkazy.
Zkopírujte nebo stáhněte .md, jakmile se zdroj a náhled shodují. Tyto akce využívají upravený zdroj; původní PDF zůstává nezměněno.
Časté dotazy
Proč má nadpis špatnou úroveň?
Extraktor používá velikost textu namísto pochopení kompletní osnovy dokumentu. Upravte značky # a zkontrolujte Náhled.
Načítá Náhled propojené obrázky?
Aktuální náhled zobrazuje odkazy na obrázky jako text bez načítání vzdálených obrázků. Zkontrolujte je v aplikaci, kde budete později Markdown publikovat.
Vyzkoušejte to se svým dokumentem
Zkontrolujte výsledek a poté uložte verzi, kterou potřebujete.