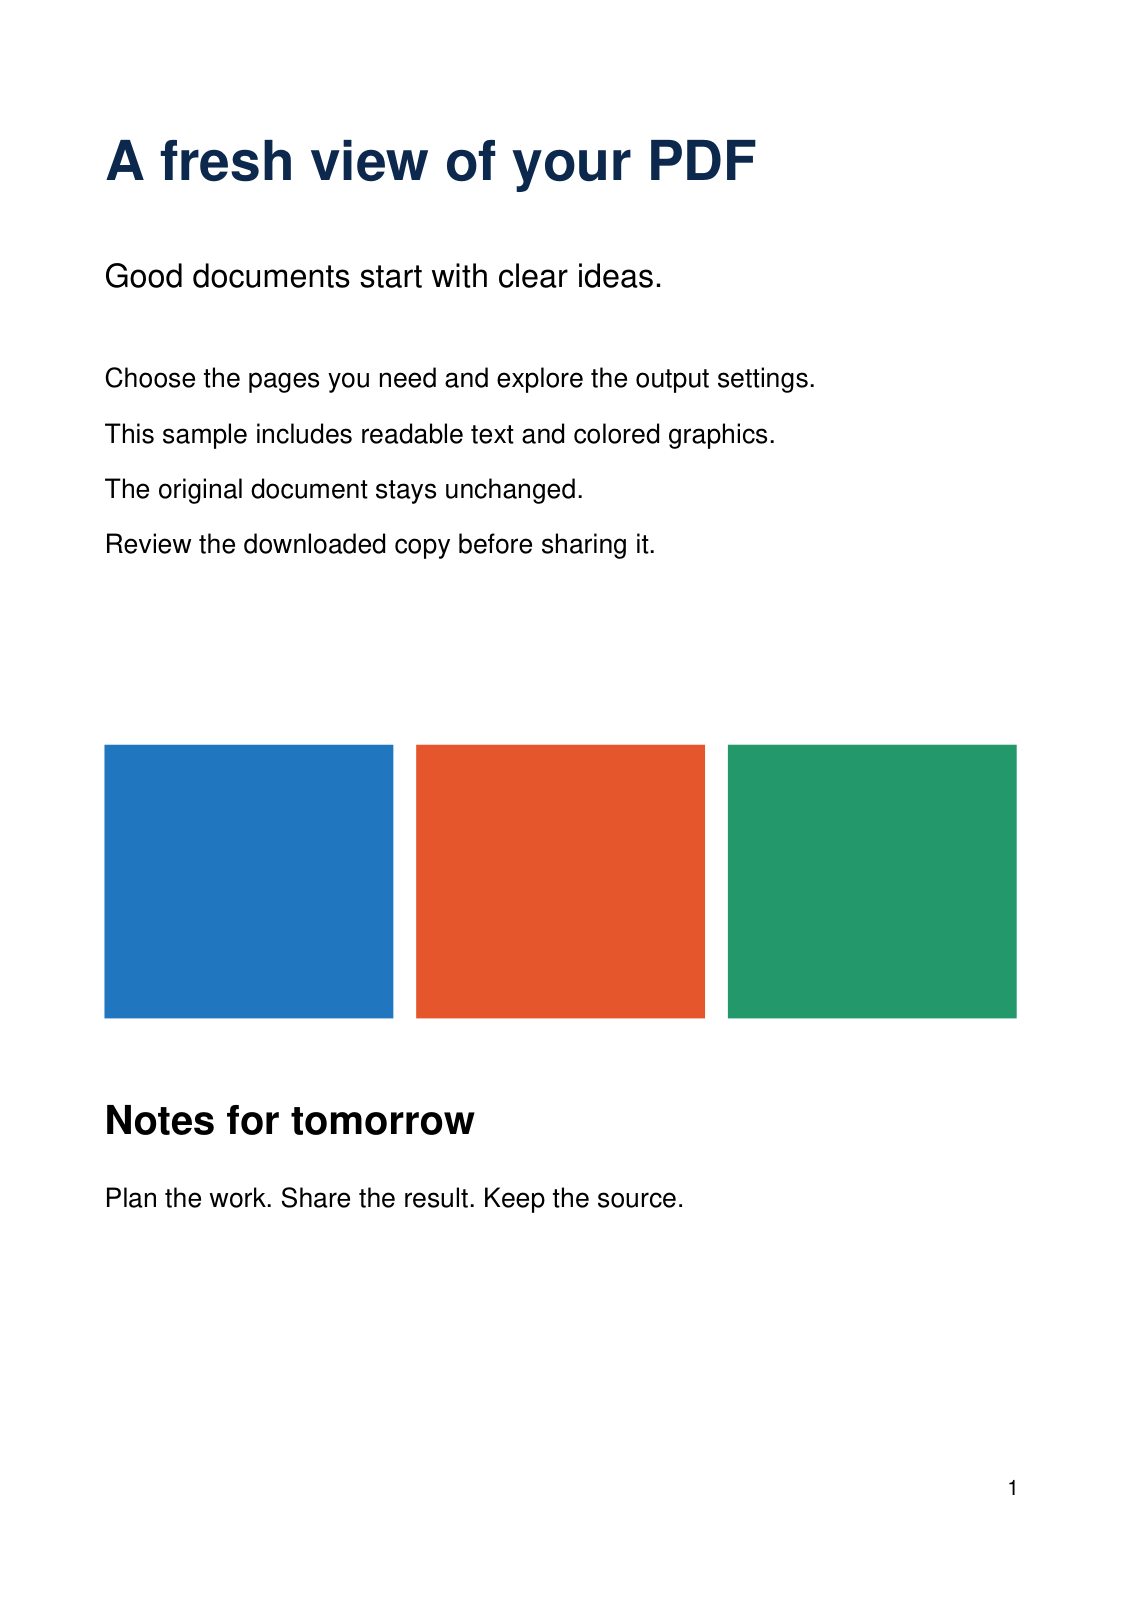
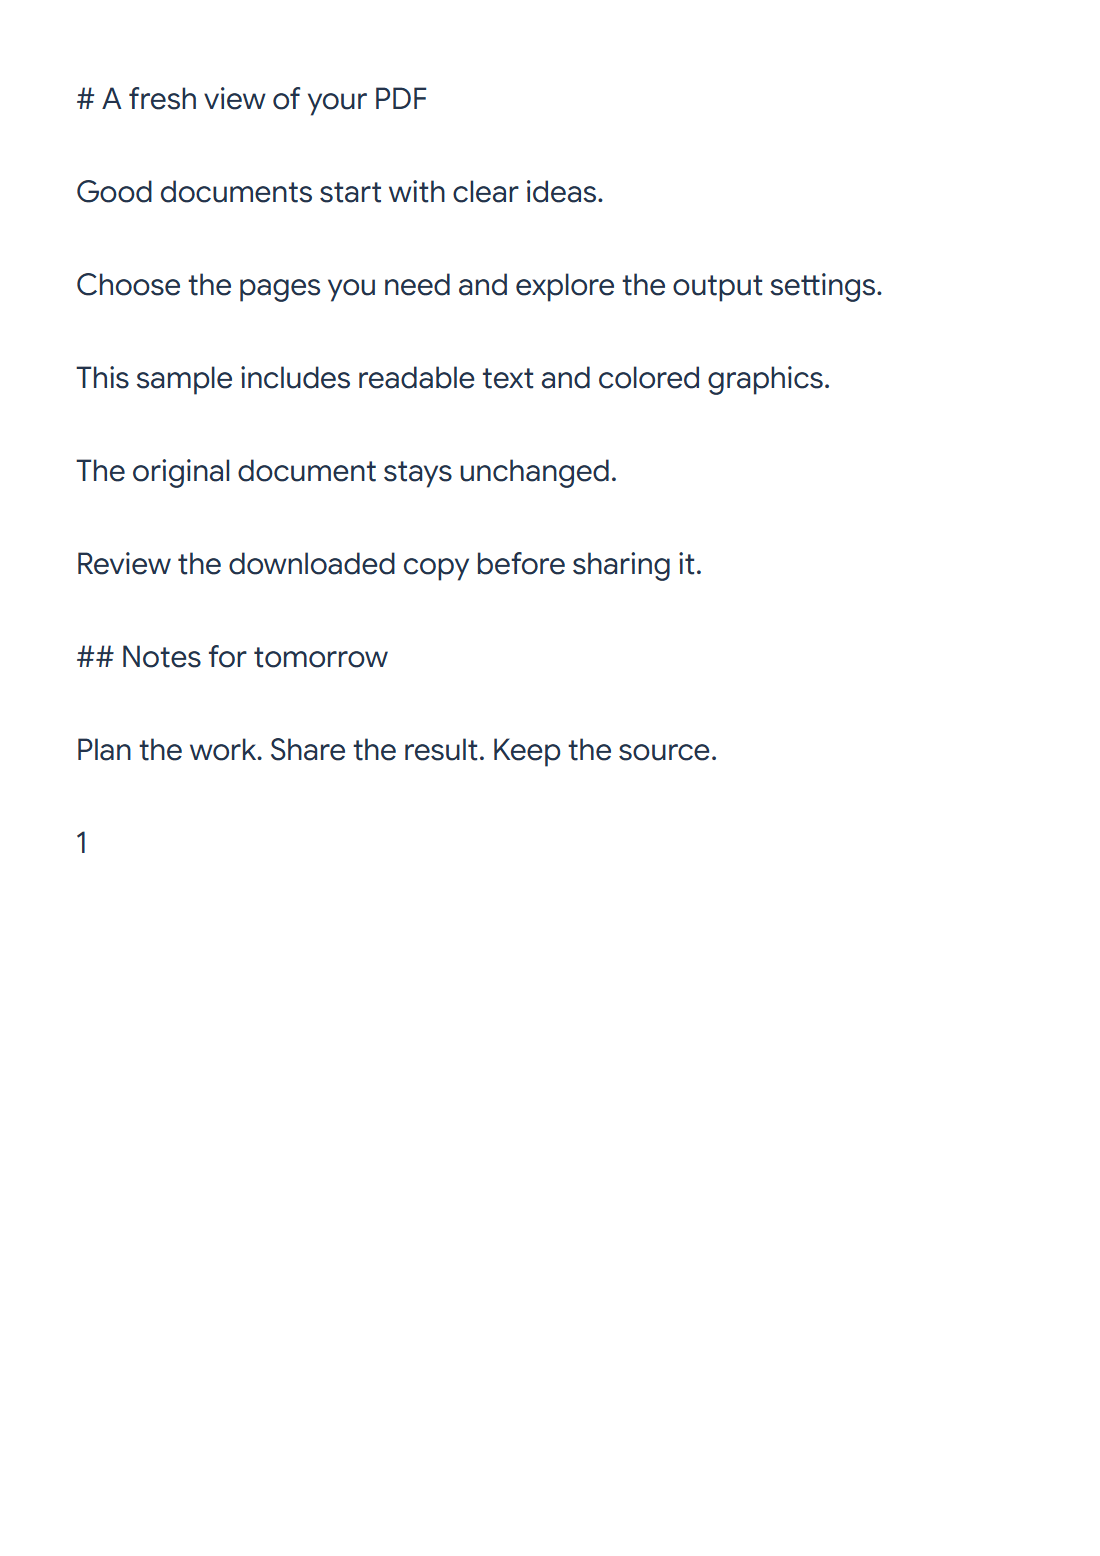

Użyj PDF na Markdown, aby wyodrębnić tekst i prawdopodobne nagłówki, a następnie przejrzyj edytowalne źródło. Nasz dwustronicowy przykład eksportuje dokument Markdown o rozmiarze 700 bajtów.
Wybierz strony źródłowe
Wczytaj plik PDF i pozostaw Strony do przetworzenia puste dla obu przykładowych stron lub wprowadź zakres. Skanowane obrazy wymagają OCR przed tą konwersją opartą na tekście.
Konwertuj i przejrzyj Markdown
Wybierz Start. Wyniki pokazują edytowalny Markdown oraz wygenerowany Podgląd. Na wąskim ekranie przełączaj się między kartami.
Główny tytuł przykładu staje się nagłówkiem pierwszego poziomu, a „Notatki na jutro” nagłówkiem drugiego poziomu. Wykrywanie opiera się na rozmiarze tekstu, więc duża etykieta dekoracyjna może wymagać poprawy.
Edytuj strukturę i pobierz
Popraw poziomy nagłówków, odstępy, listy i kolejność czytania w źródle. Podgląd aktualizuje się podczas edycji. Kontrolki formatowania pomagają dodawać wyróżnienia, listy i bezpośrednie linki.
Skopiuj lub pobierz plik .md, gdy źródło i podgląd są zgodne. Te działania wykorzystują edytowane źródło; oryginalny plik PDF pozostaje niezmieniony.
Często zadawane pytania
Dlaczego nagłówek otrzymał niewłaściwy poziom?
Ekstraktor używa rozmiaru tekstu zamiast analizy pełnego konspektu dokumentu. Dostosuj znaczniki # i sprawdź Podgląd.
Czy podgląd pobiera podlinkowane obrazy?
Bieżący podgląd wyświetla odniesienia do obrazów jako tekst bez ładowania obrazów zdalnych. Przejrzyj je w aplikacji, w której później opublikujesz Markdown.
Wypróbuj ze swoim dokumentem
Przejrzyj wynik, a następnie zapisz wersję, której potrzebujesz.