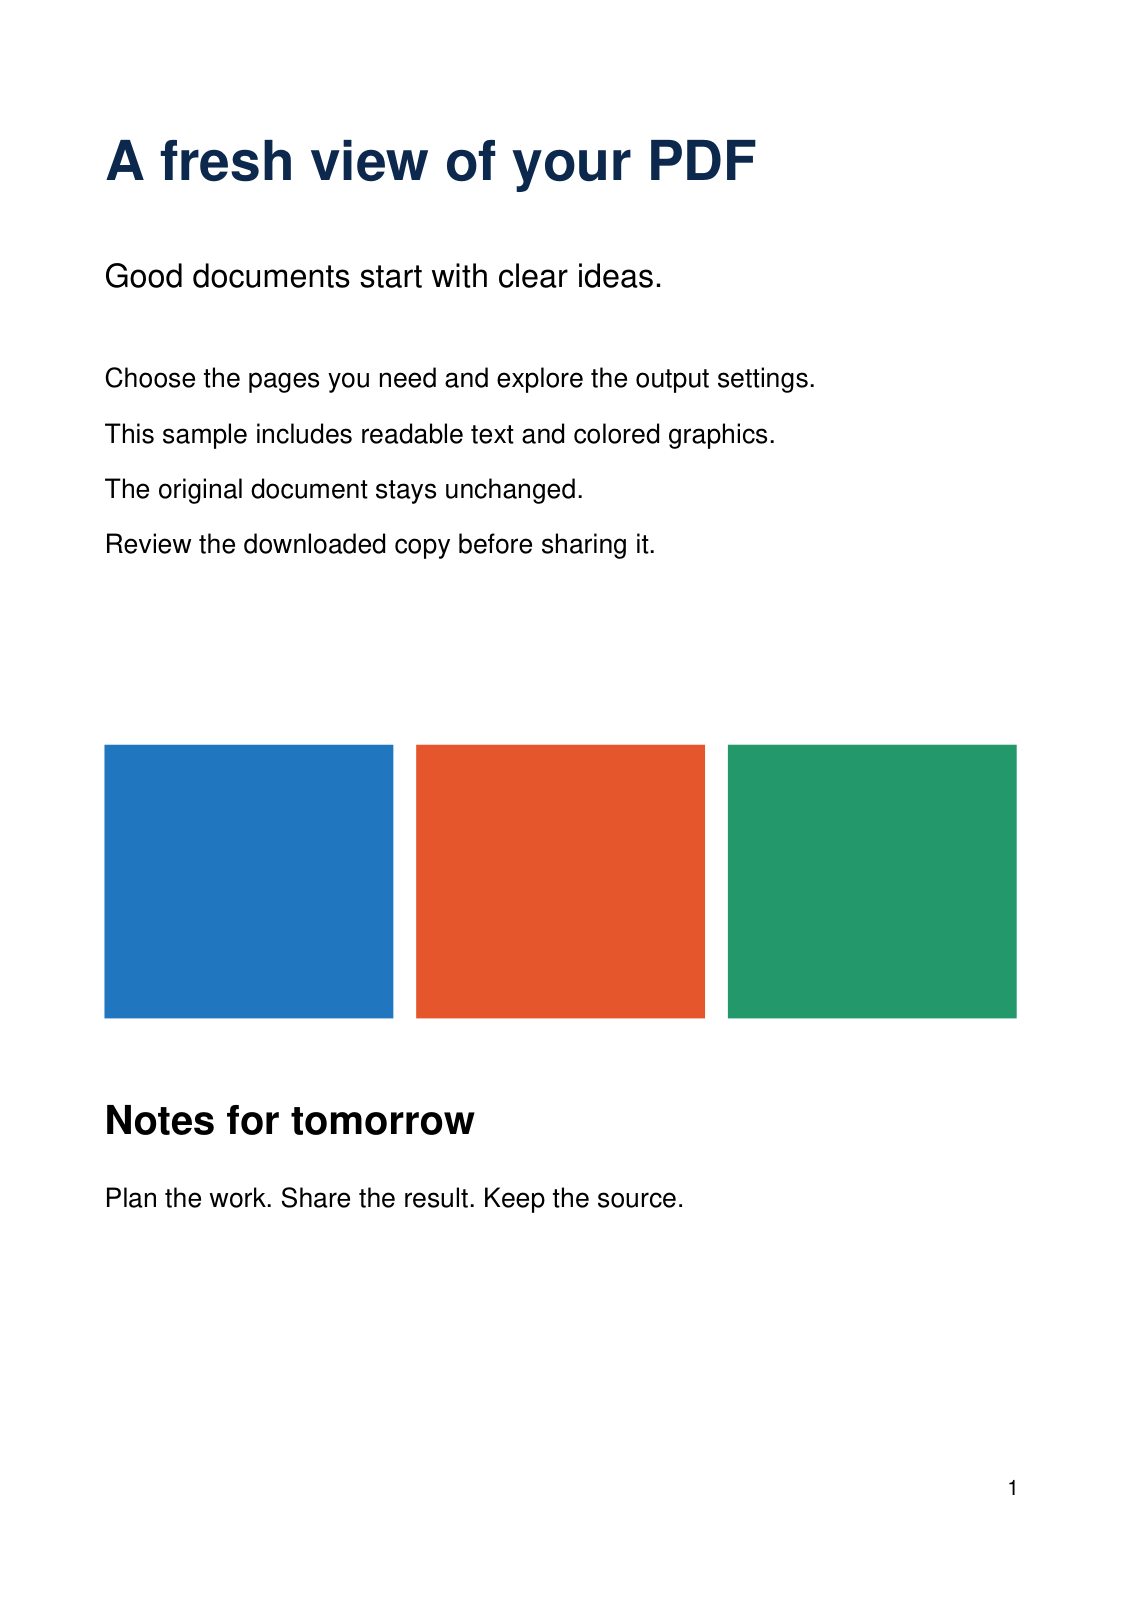
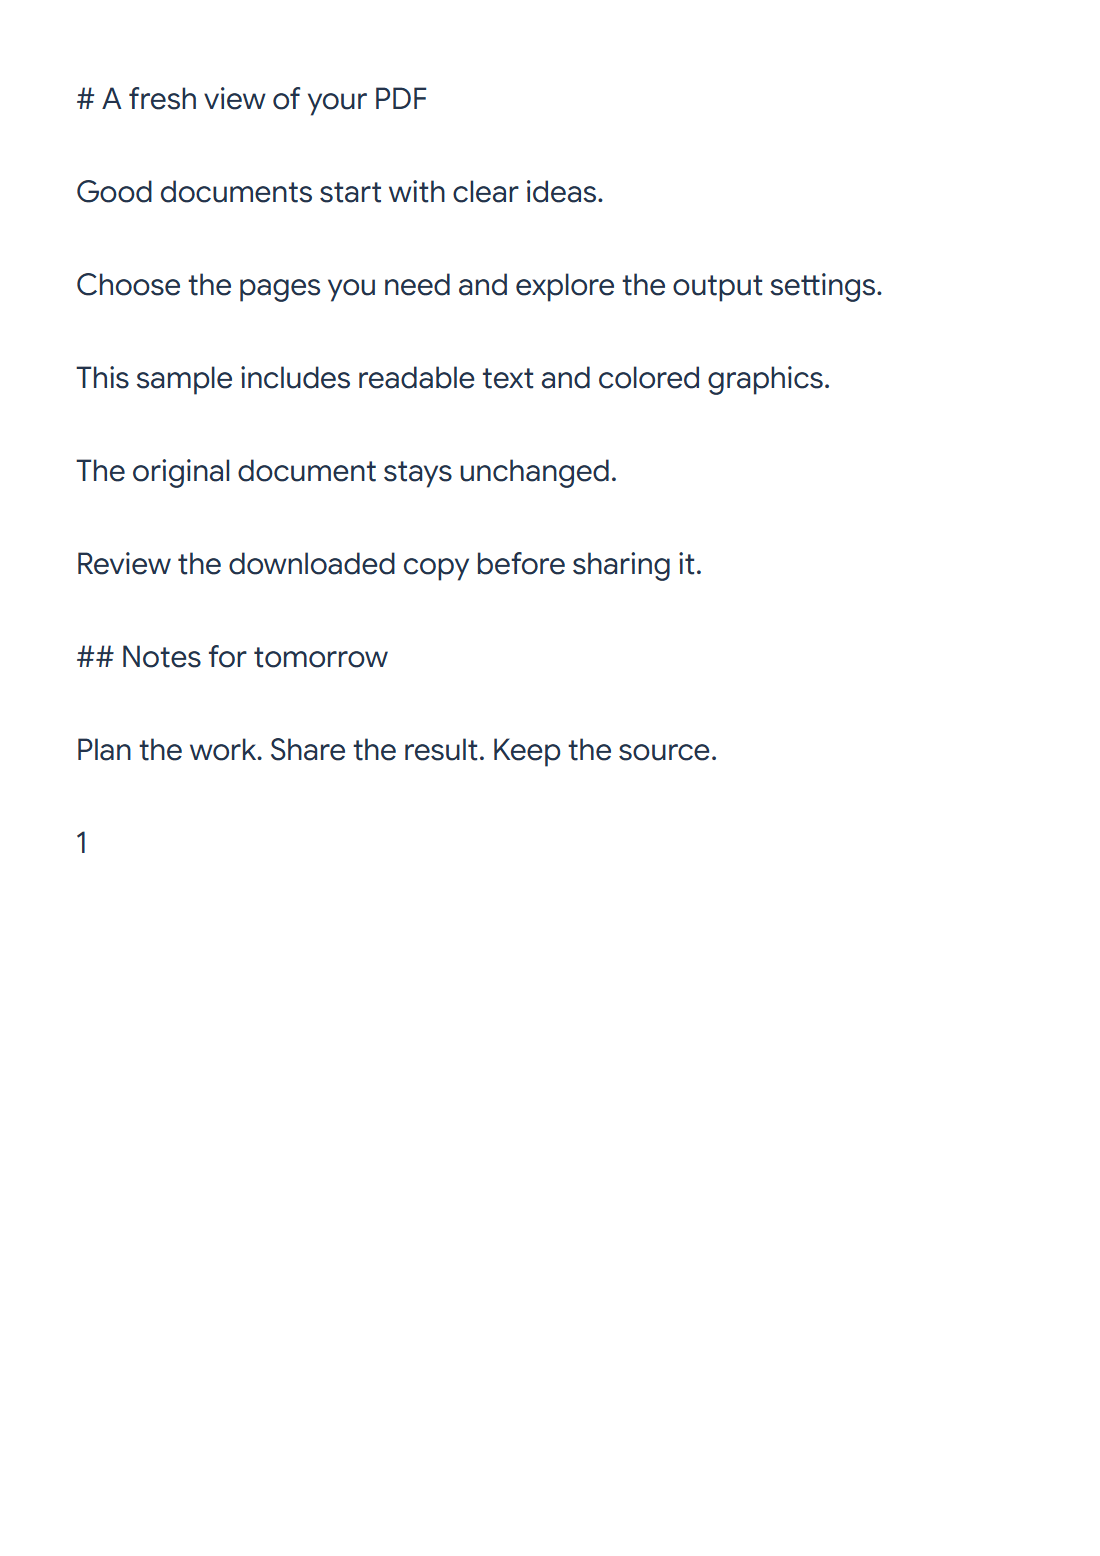

टेक्स्ट और संभावित हेडिंग निकालने के लिए PDF to Markdown का उपयोग करें, फिर एडिट करने योग्य सोर्स की समीक्षा करें। हमारा दो-पेज का सैंपल एक 700-बाइट की Markdown डॉक्यूमेंट एक्सपोर्ट करता है।
सोर्स पेज चुनें
PDF लोड करें और दोनों सैंपल पेजों के लिए Pages to process को खाली छोड़ दें, या कोई रेंज दर्ज करें। स्कैन की गई छवियों को इस टेक्स्ट-आधारित कन्वर्जन से पहले OCR की आवश्यकता होती है।
Markdown को बदलें और समीक्षा करें
Start चुनें। परिणाम एडिट करने योग्य Markdown और एक रेंडर किया गया Preview दिखाते हैं। छोटी स्क्रीन पर, उनके टैब के बीच स्विच करें।
सैंपल का मुख्य शीर्षक लेवल-वन हेडिंग बन जाता है, और 'Notes for tomorrow' लेवल-टू हेडिंग बन जाता है। डिटेक्शन टेक्स्ट साइज़ का उपयोग करता है, इसलिए एक बड़े सजावटी लेबल को सुधारने की आवश्यकता हो सकती है।
संरचना को एडिट करें और डाउनलोड करें
सोर्स में हेडिंग लेवल, स्पेसिंग, लिस्ट और पढ़ने के क्रम को सुधारें। एडिट करते समय प्रीव्यू अपडेट होता है। फॉर्मेटिंग कंट्रोल जोर देने, लिस्ट और स्पष्ट लिंक जोड़ने में मदद करते हैं।
जब सोर्स और प्रीव्यू सहमत हों तो .md कॉपी या डाउनलोड करें। ये क्रियाएं एडिट किए गए सोर्स का उपयोग करती हैं; मूल PDF अपरिवर्तित रहता है।
सामान्य प्रश्न
हेडिंग का लेवल गलत क्यों हो गया?
एक्सट्रैक्टर पूरे डॉक्यूमेंट आउटलाइन को समझने के बजाय टेक्स्ट साइज़ का उपयोग करता है। # मार्करों को समायोजित करें और प्रीव्यू देखें।
क्या प्रीव्यू लिंक की गई छवियों को फ़ेच करता है?
वर्तमान प्रीव्यू रिमोट छवियों को लोड किए बिना इमेज रेफरेंस को टेक्स्ट के रूप में प्रदर्शित करता है। उनकी समीक्षा उस एप्लिकेशन में करें जहां आप बाद में Markdown प्रकाशित करते हैं।
इसे अपने डॉक्यूमेंट के साथ आज़माएं
परिणाम की समीक्षा करें, फिर वह वर्शन सहेजें जिसकी आपको आवश्यकता है।