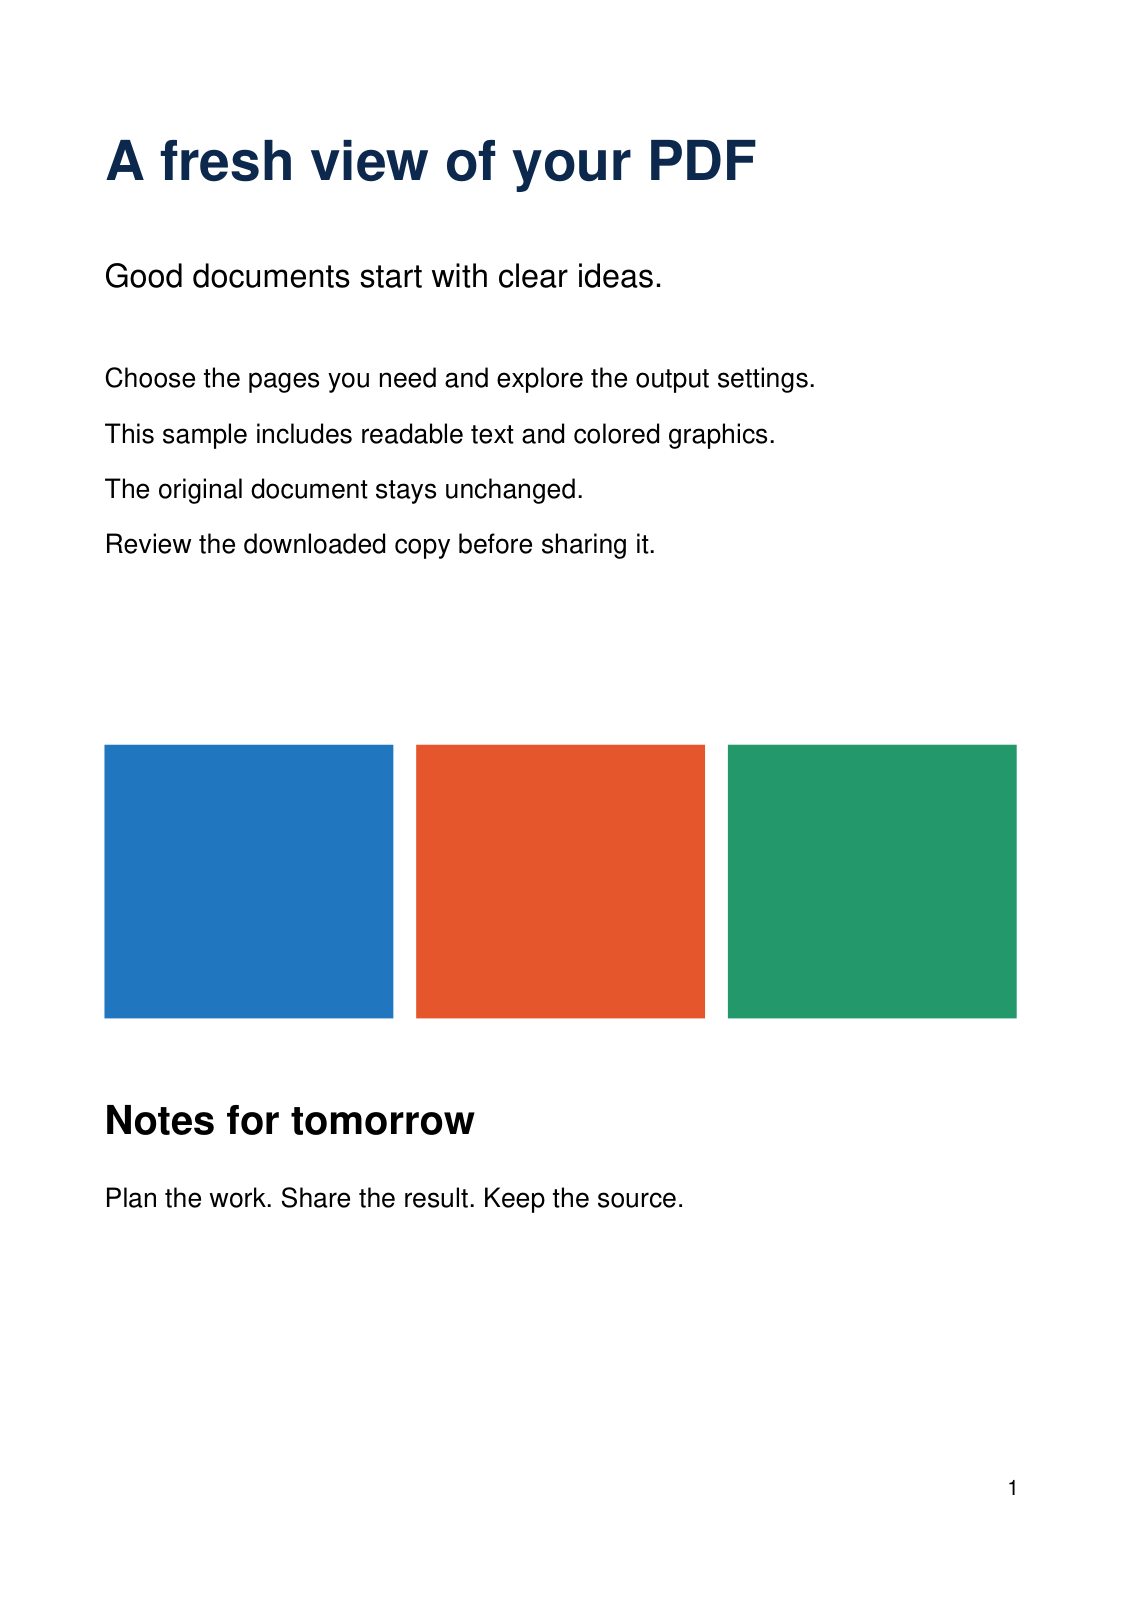
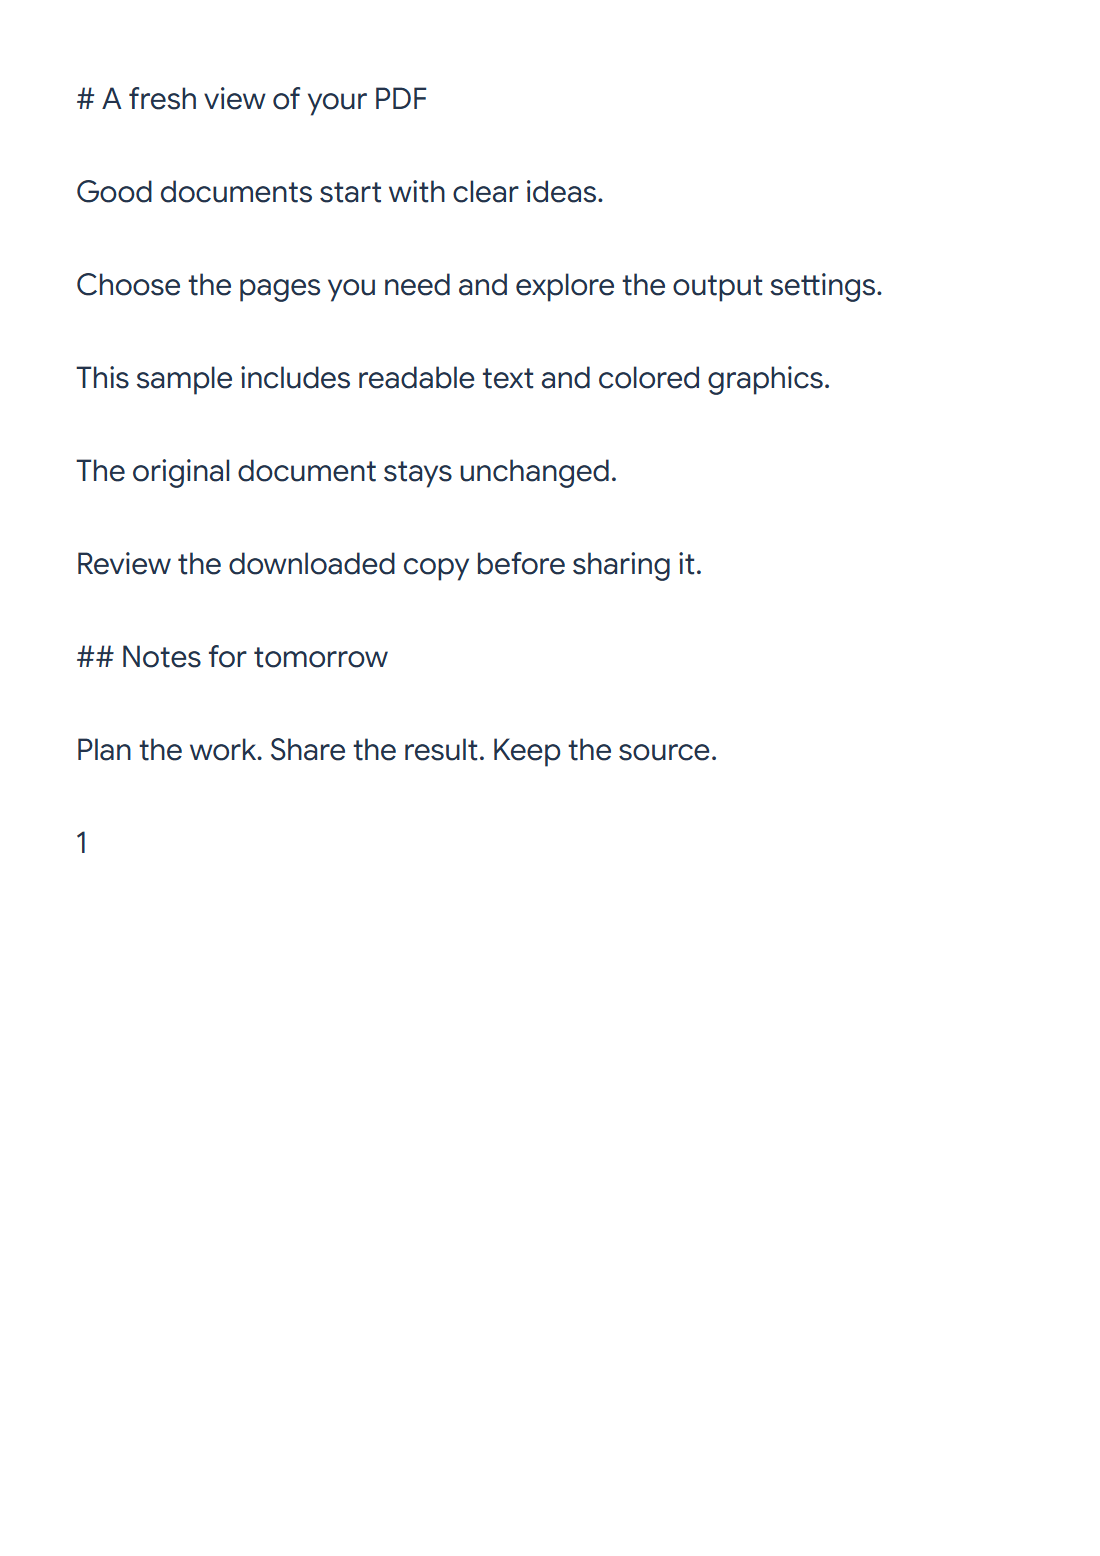

Bruk PDF til Markdown for å trekke ut tekst og sannsynlige overskrifter, og gå deretter gjennom den redigerbare kilden. Vårt eksempel på to sider eksporterer et 700-byte Markdown-dokument.
Velg kildesidene
Last inn PDF-en og la Sider som skal behandles stå tom for begge eksempelsidene, eller skriv inn et område. Skannede bilder trenger OCR før denne tekstbaserte konverteringen.
Konverter og gå gjennom Markdown-filen
Velg Start. Resultatene viser redigerbar Markdown og en rendret Forhåndsvisning. På en smal skjerm kan du bytte mellom fanene.
Eksemplets hovedtittel blir en overskrift på nivå én, og «Notes for tomorrow» blir en overskrift på nivå to. Gjenkjenningen bruker tekststørrelse, så en stor dekorativ etikett kan trenge korrigering.
Rediger strukturen og last ned
Korriger overskriftsnivåer, avstand, lister og leserekkefølge i kilden. Forhåndsvisningen oppdateres mens du redigerer. Formateringskontroller hjelper deg med å legge til utheving, lister og eksplisitte lenker.
Kopier eller last ned .md når kilden og forhåndsvisningen stemmer overens. Disse handlingene bruker den redigerte kilden; den originale PDF-en forblir uendret.
Vanlige spørsmål
Hvorfor fikk en overskrift feil nivå?
Ekstraktoren bruker tekststørrelse fremfor å forstå hele dokumentstrukturen. Juster #-markørene og sjekk forhåndsvisningen.
Henter forhåndsvisningen lenkede bilder?
Den nåværende forhåndsvisningen viser bildereferanser som tekst uten å laste inn eksterne bilder. Se gjennom dem i applikasjonen der du senere publiserer Markdown-filen.
Prøv det med dokumentet ditt
Gå gjennom resultatet, og lagre deretter versjonen du trenger.