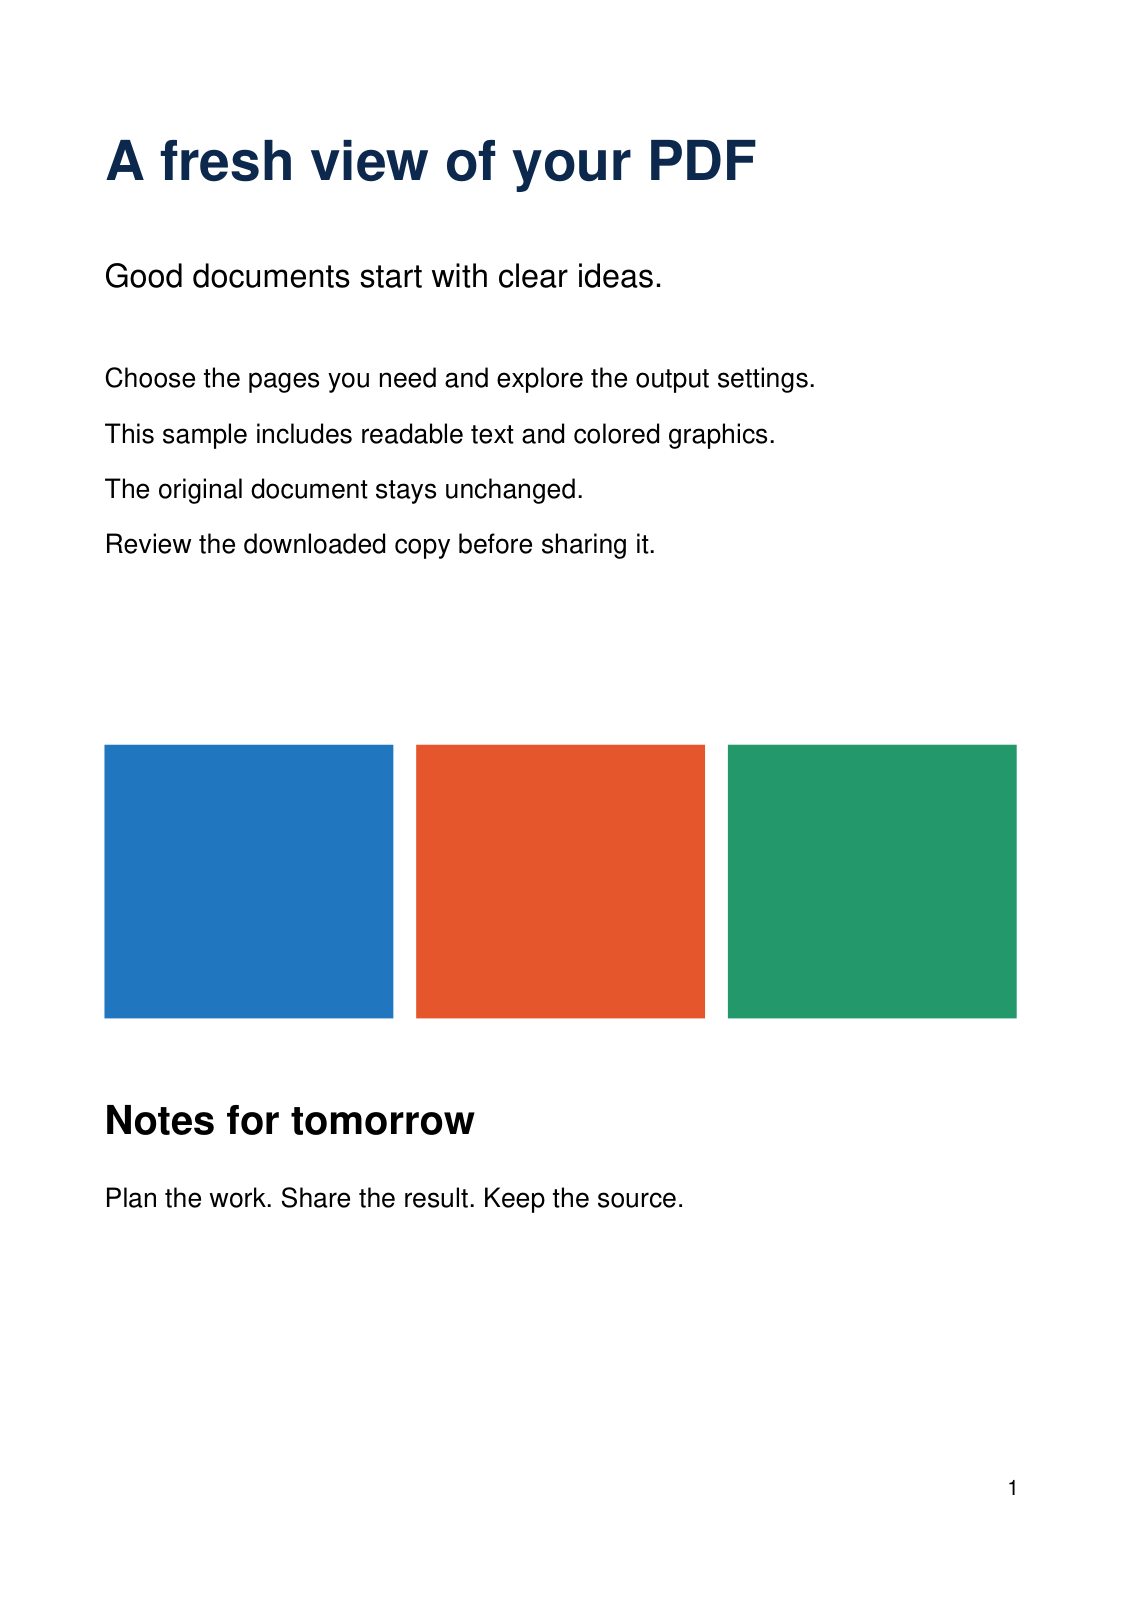
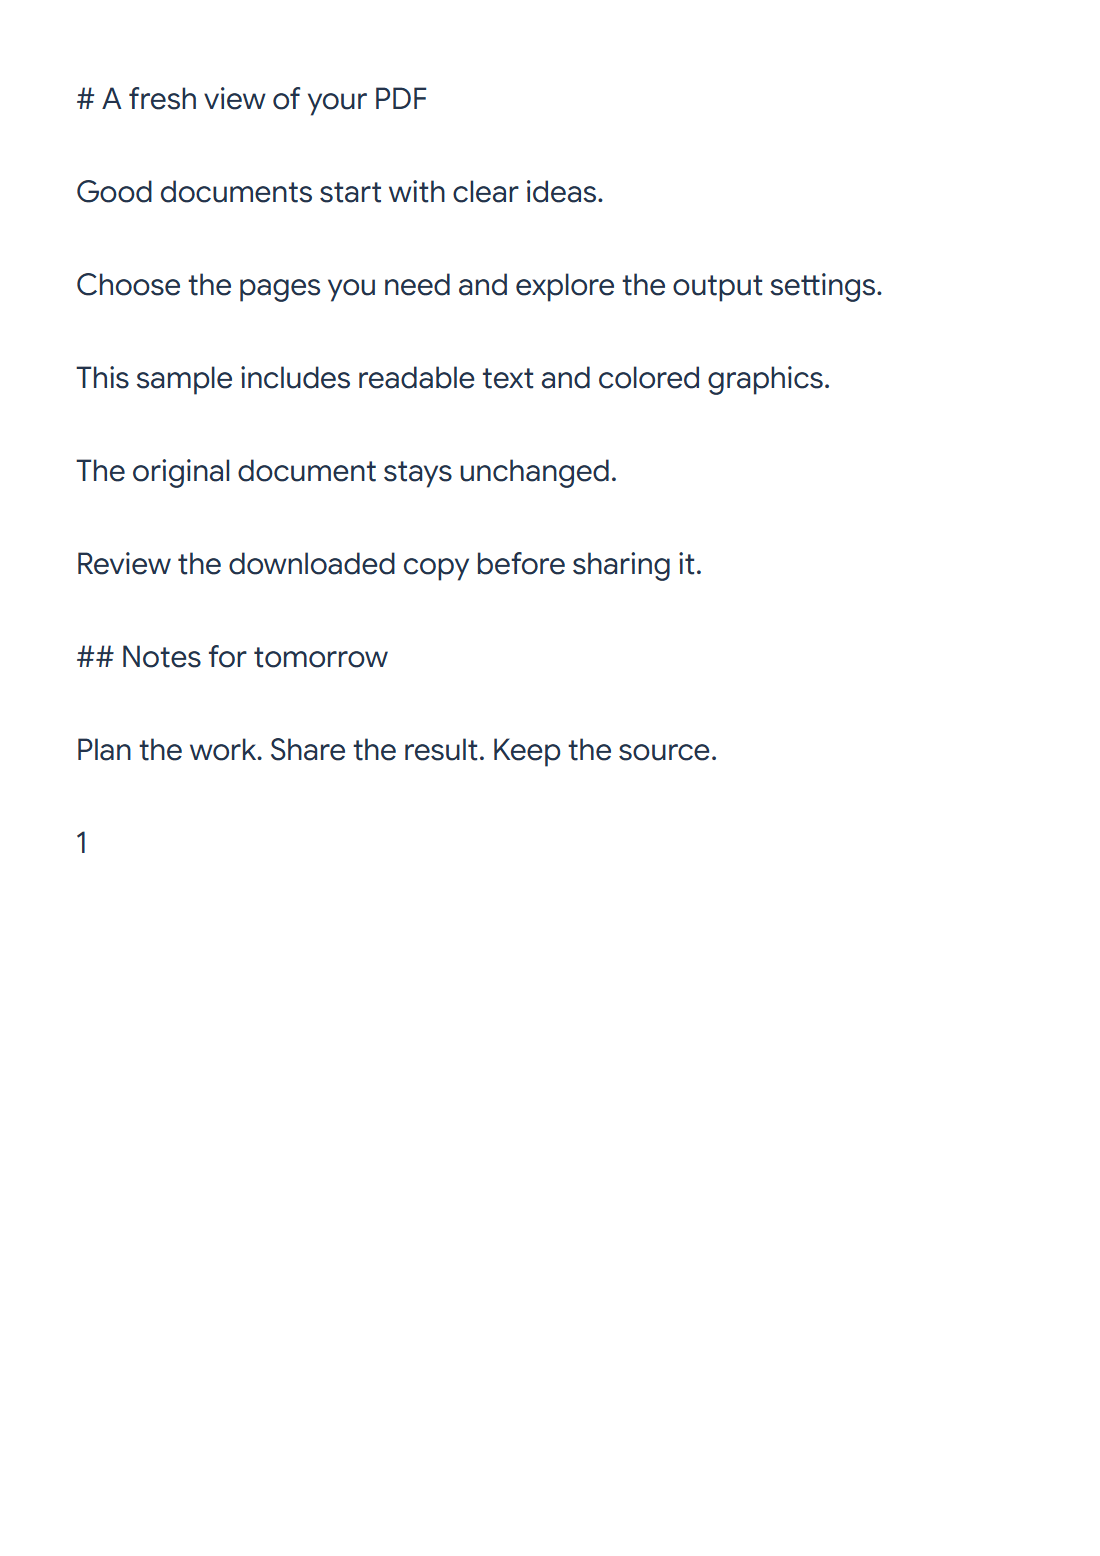

Brug PDF til Markdown til at udtrække tekst og sandsynlige overskrifter, og gennemse derefter den redigerbare kilde. Vores eksempel på to sider eksporterer et 700-byte Markdown-dokument.
Vælg kildesiderne
Indlæs PDF'en og lad Sider der skal behandles stå tom for begge eksempelsider, eller indtast et interval. scannede billeder kræver OCR før denne tekstbaserede konvertering.
Konverter og gennemse Markdown
Vælg Start. Resultaterne viser redigerbar Markdown og en vist Forhåndsvisning. På en smal skærm kan du skifte mellem fanerne.
Eksemplets hovedtitel bliver til en overskrift på niveau 1, og 'Noter til i morgen' bliver til en overskrift på niveau 2. Detektering bruger tekststørrelse, så en stor dekorativ etiket kan kræve rettelse.
Rediger strukturen og download
Ret overskriftsniveauer, afstand, lister og læserækkefølge i kilden. Forhåndsvisningen opdateres, mens du redigerer. Formateringskontroller hjælper med at tilføje fremhævning, lister og eksplicitte links.
Kopiér eller download .md, når kilden og forhåndsvisningen stemmer overens. Disse handlinger bruger den redigerede kilde; den originale PDF forbliver uændret.
Almindelige spørgsmål
Hvorfor fik en overskrift det forkerte niveau?
Ekstraktoren bruger tekststørrelse frem for at forstå dokumentets fulde struktur. Juster #-markørerne og tjek Forhåndsvisning.
Henter forhåndsvisningen linkede billeder?
Den nuværende forhåndsvisning viser billedreferencer som tekst uden at indlæse eksterne billeder. Gennemse dem i det program, hvor du senere publicerer din Markdown.
Prøv det med dit dokument
Gennemse resultatet, og gem derefter den version, du har brug for.