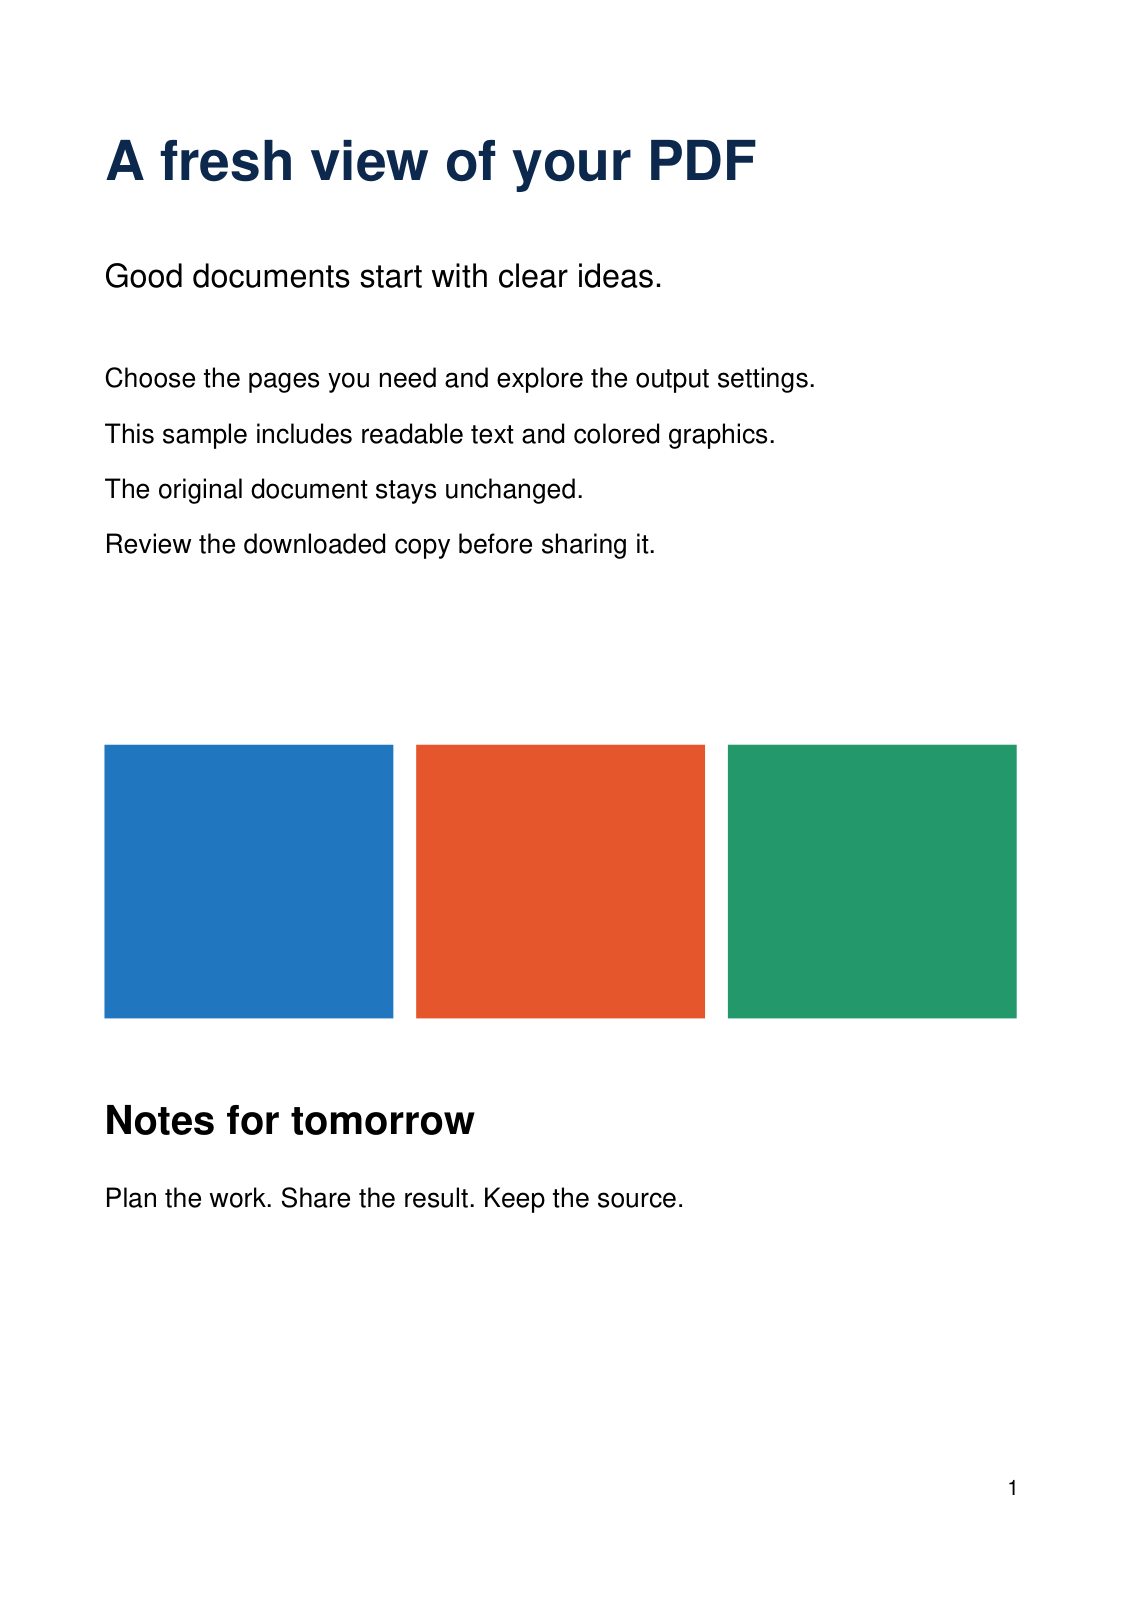
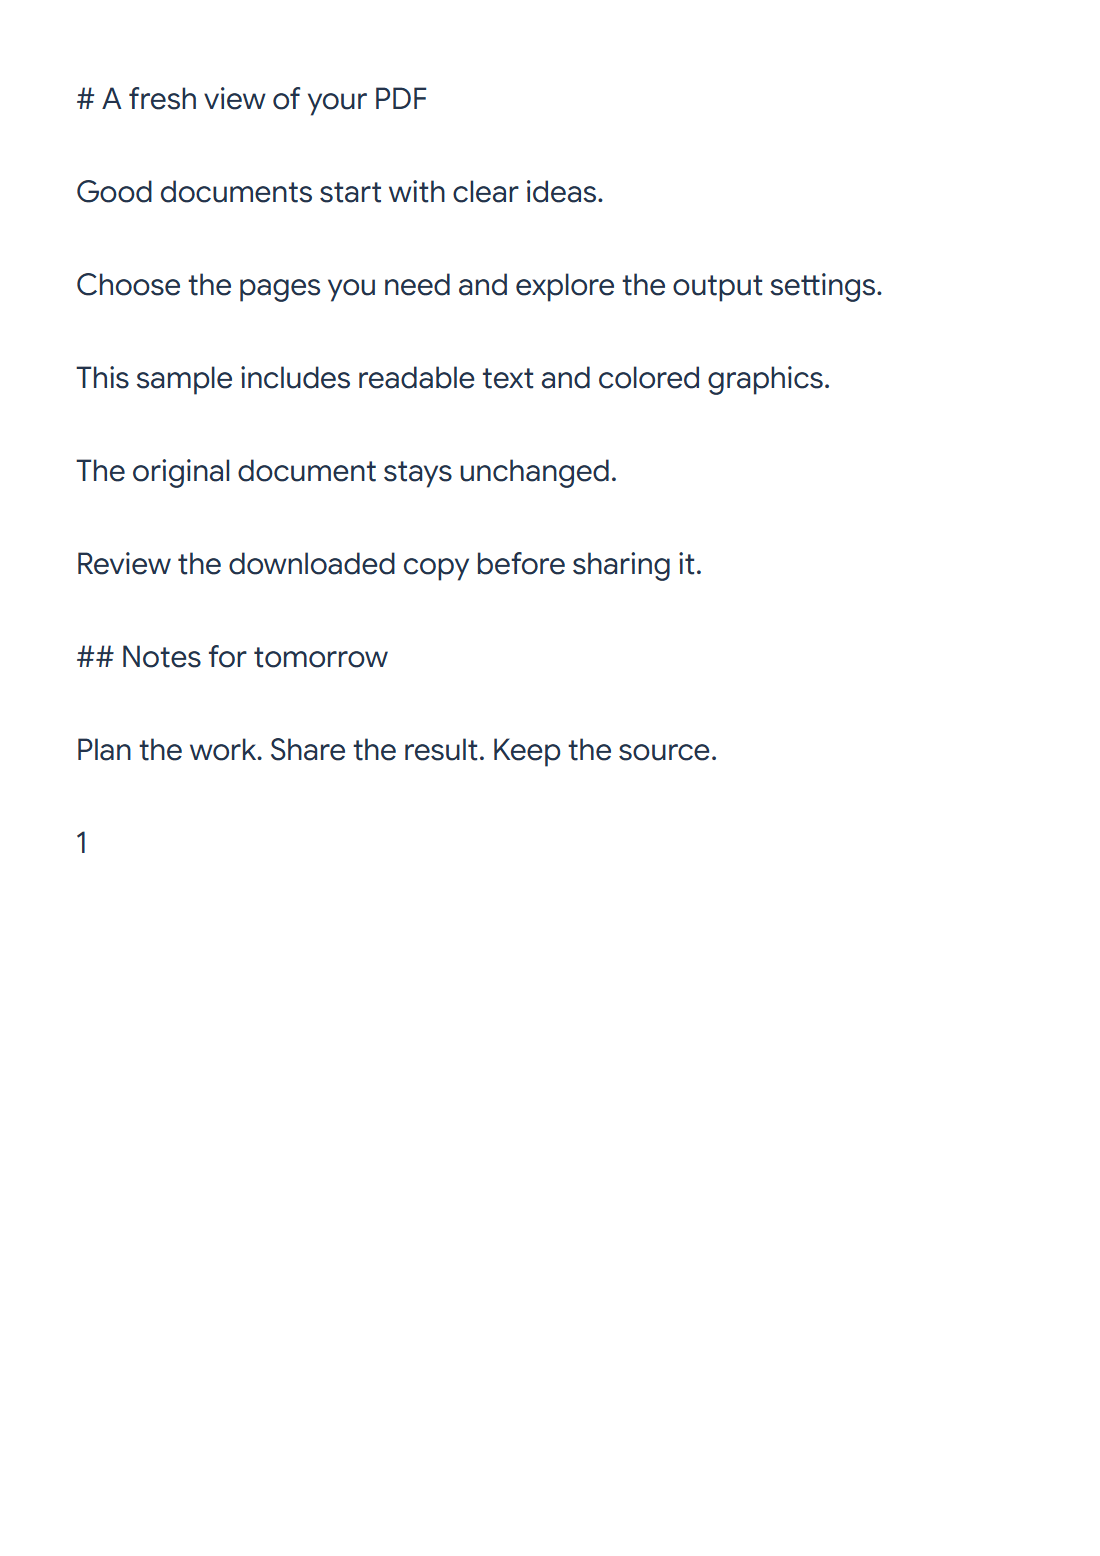

Utilisez PDF vers Markdown pour extraire le texte et les titres probables, puis révisez la source modifiable. Notre exemple de deux pages génère un document Markdown de 700 octets.
Choisissez les pages sources
Chargez le PDF et laissez Pages à traiter vide pour les deux pages de l'exemple, ou saisissez une plage. Les images numérisées nécessitent une OCR avant cette conversion basée sur le texte.
Convertissez et révisez le Markdown
Choisissez Démarrer. Les résultats affichent le Markdown modifiable et un Aperçu rendu. Sur un écran étroit, basculez entre les onglets.
Le titre principal de l'exemple devient un titre de niveau un, et « Notes for tomorrow » devient un titre de niveau deux. La détection utilise la taille du texte, une étiquette décorative large peut donc nécessiter une correction.
Modifiez la structure et téléchargez
Corrigez les niveaux de titre, l'espacement, les listes et l'ordre de lecture dans la source. L'aperçu se met à jour au fur et à mesure de vos modifications. Les contrôles de formatage aident à ajouter de l'emphase, des listes et des liens explicites.
Copiez ou téléchargez le fichier .md lorsque la source et l'aperçu correspondent. Ces actions utilisent la source modifiée ; le PDF original reste inchangé.
Questions fréquentes
Pourquoi un titre a-t-il reçu le mauvais niveau ?
L'extracteur utilise la taille du texte plutôt que de comprendre le plan complet du document. Ajustez les marqueurs # et vérifiez l'Aperçu.
L'aperçu récupère-t-il les images liées ?
L'aperçu actuel affiche les références d'image sous forme de texte sans charger les images distantes. Examinez-les dans l'application où vous publierez ultérieurement le Markdown.
Essayez avec votre document
Examinez le résultat, puis enregistrez la version dont vous avez besoin.