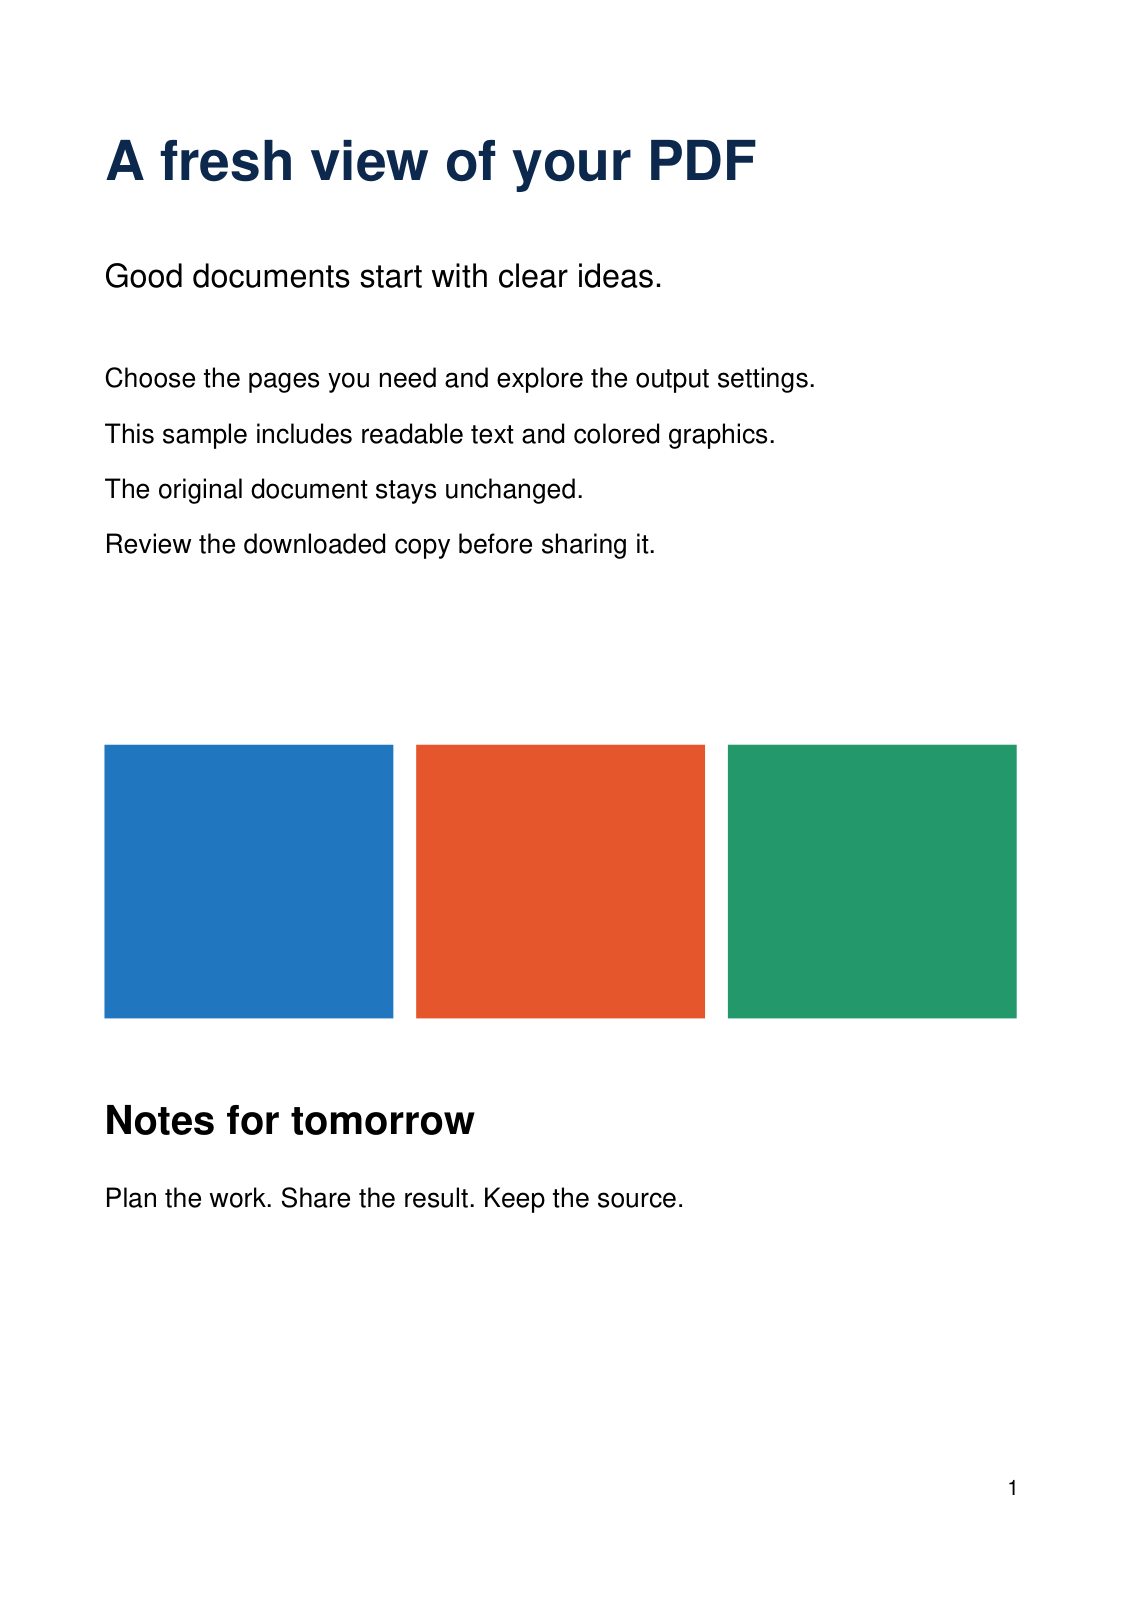
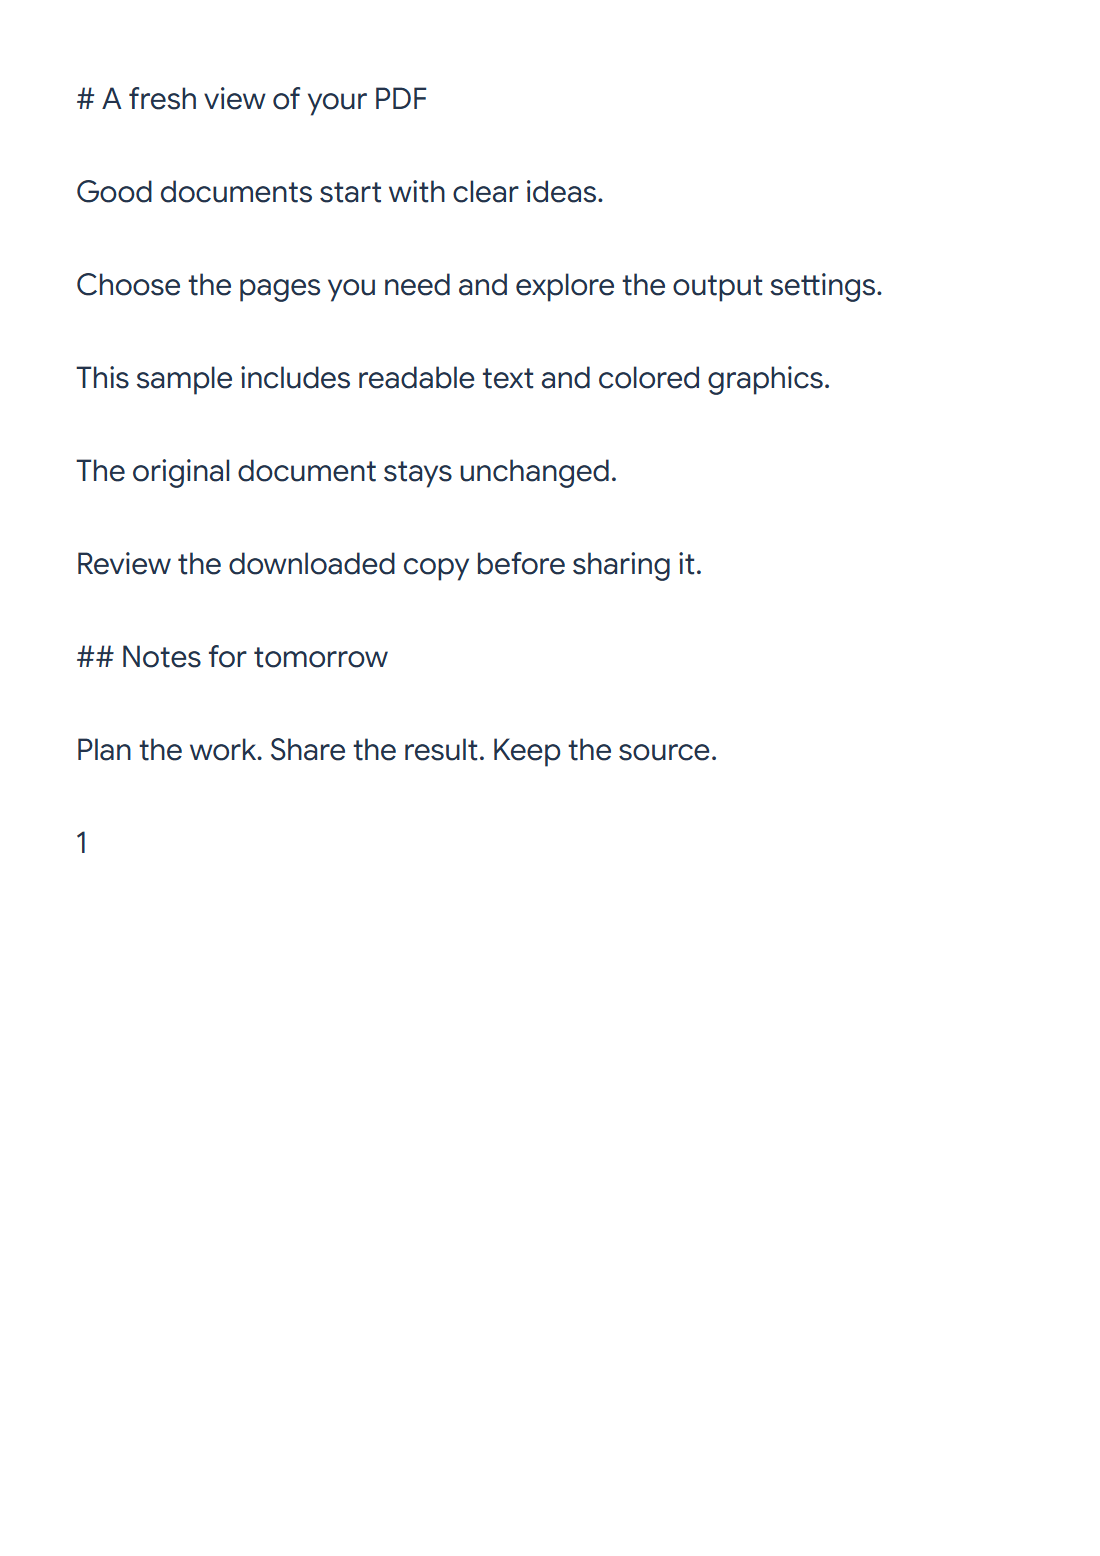

ٹیکسٹ اور ممکنہ سرخیوں کو نکالنے کے لیے PDF to Markdown کا استعمال کریں، پھر قابل ترمیم سورس کا جائزہ لیں۔ ہمارا دو صفحات کا نمونہ ایک 700-بائٹ کی مارک ڈاؤن دستاویز برآمد کرتا ہے۔
سورس صفحات کا انتخاب کریں
پی ڈی ایف لوڈ کریں اور دونوں نمونہ صفحات کے لیے Pages to process کو خالی چھوڑ دیں، یا کوئی رینج درج کریں۔ اس ٹیکسٹ پر مبنی تبدیلی سے پہلے اسکین شدہ تصاویر کو OCR کی ضرورت ہوتی ہے۔
مارک ڈاؤن کو تبدیل اور جائزہ لیں
Start کا انتخاب کریں۔ نتائج قابل ترمیم Markdown اور ایک رینڈر شدہ Preview دکھاتے ہیں۔ چھوٹی اسکرین پر، ان کے ٹیبز کے درمیان سوئچ کریں۔
نمونے کا مرکزی عنوان لیول ون کی سرخی بن جاتا ہے، اور 'Notes for tomorrow' لیول ٹو کی سرخی بن جاتا ہے۔ شناخت ٹیکسٹ کے سائز کا استعمال کرتی ہے، لہذا ایک بڑے آرائشی لیبل کو درستگی کی ضرورت ہو سکتی ہے۔
ساخت میں ترمیم کریں اور ڈاؤن لوڈ کریں
سورس میں سرخی کی سطحوں، وقفہ کاری، فہرستوں اور پڑھنے کی ترتیب کو درست کریں۔ ترمیم کرتے وقت پیش نظارہ اپ ڈیٹ ہوتا ہے۔ فارمیٹنگ کنٹرولز زور دینے، فہرستیں اور واضح لنکس شامل کرنے میں مدد کرتے ہیں۔
جب سورس اور پیش نظارہ متفق ہوں تو .md کاپی یا ڈاؤن لوڈ کریں۔ یہ اقدامات ترمیم شدہ سورس کا استعمال کرتے ہیں؛ اصل پی ڈی ایف غیر تبدیل شدہ رہتی ہے۔
عام سوالات
سرخی کو غلط لیول کیوں ملا؟
ایکسٹریکٹر مکمل دستاویز کے خاکہ کو سمجھنے کے بجائے ٹیکسٹ سائز کا استعمال کرتا ہے۔ # مارکرز کو ایڈجسٹ کریں اور پیش نظارہ چیک کریں۔
کیا پیش نظارہ لنک شدہ تصاویر لاتا ہے؟
موجودہ پیش نظارہ ریموٹ تصاویر کو لوڈ کیے بغیر ٹیکسٹ کے طور پر امیج ریفرنسز دکھاتا ہے۔ ان کا جائزہ اس ایپلی کیشن میں لیں جہاں آپ بعد میں مارک ڈاؤن شائع کرتے ہیں۔
اپنی دستاویز کے ساتھ آزمائیں
نتیجے کا جائزہ لیں، پھر اپنی ضرورت کا ورژن محفوظ کریں۔