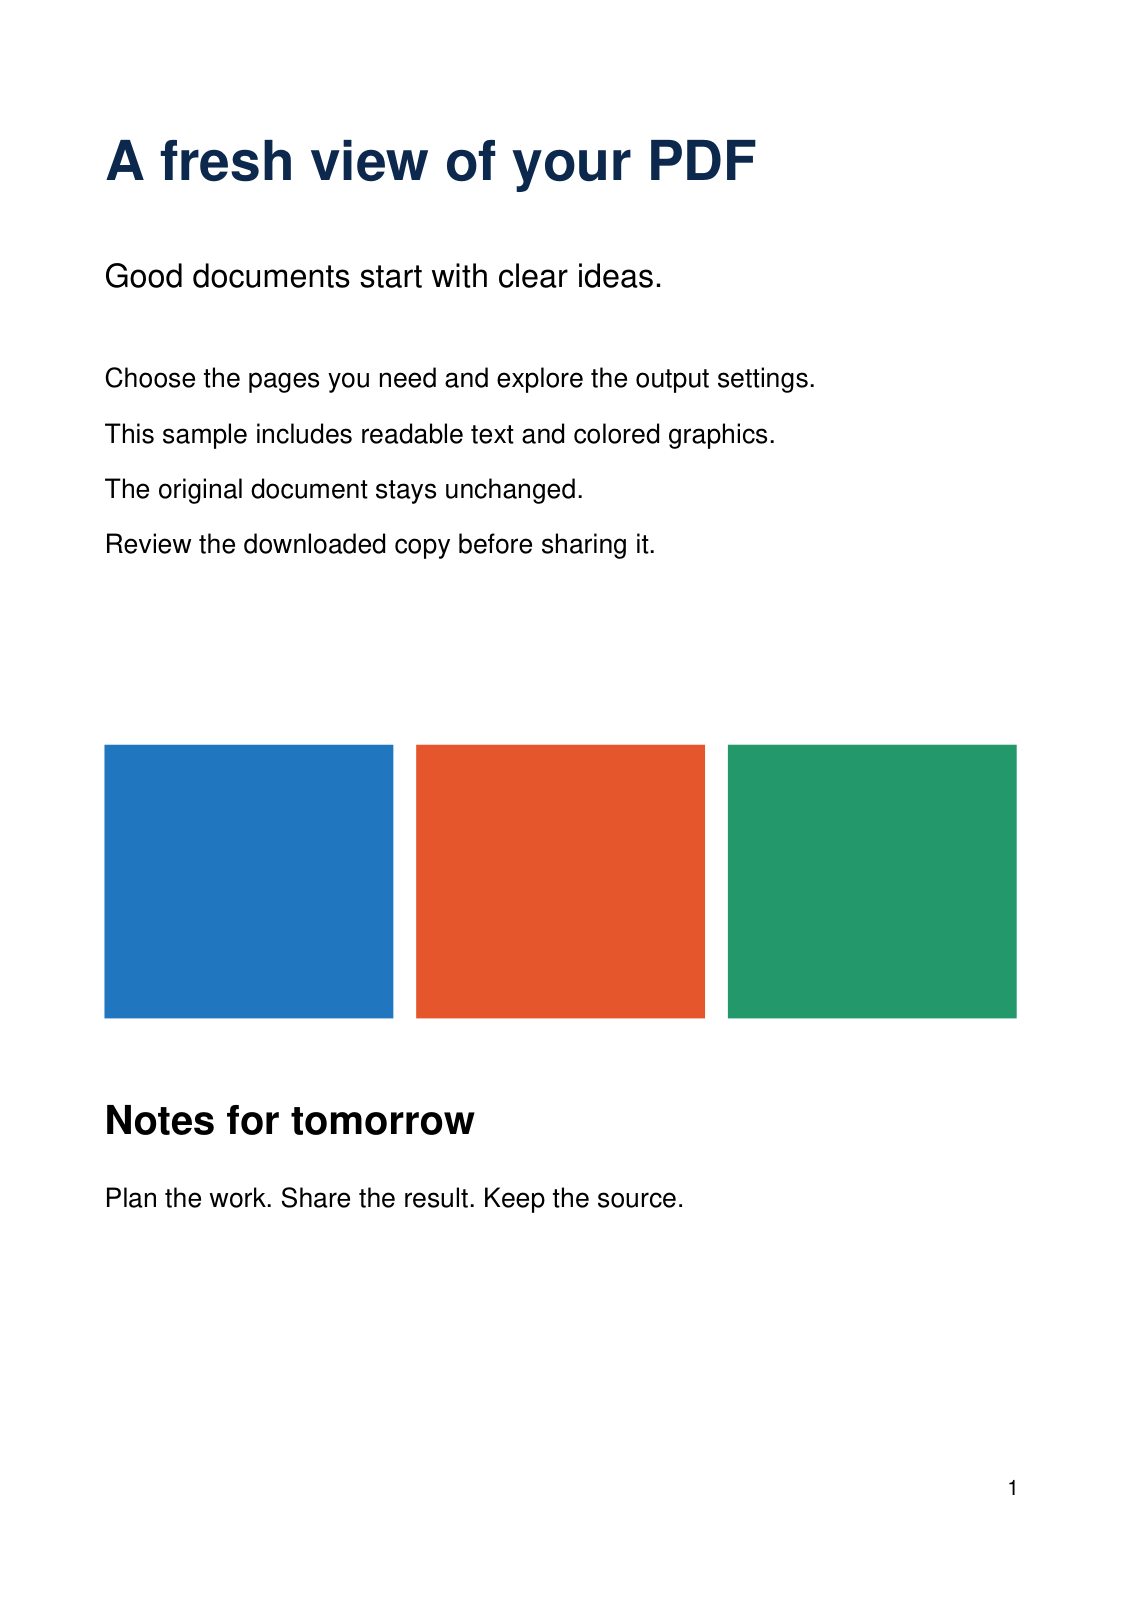
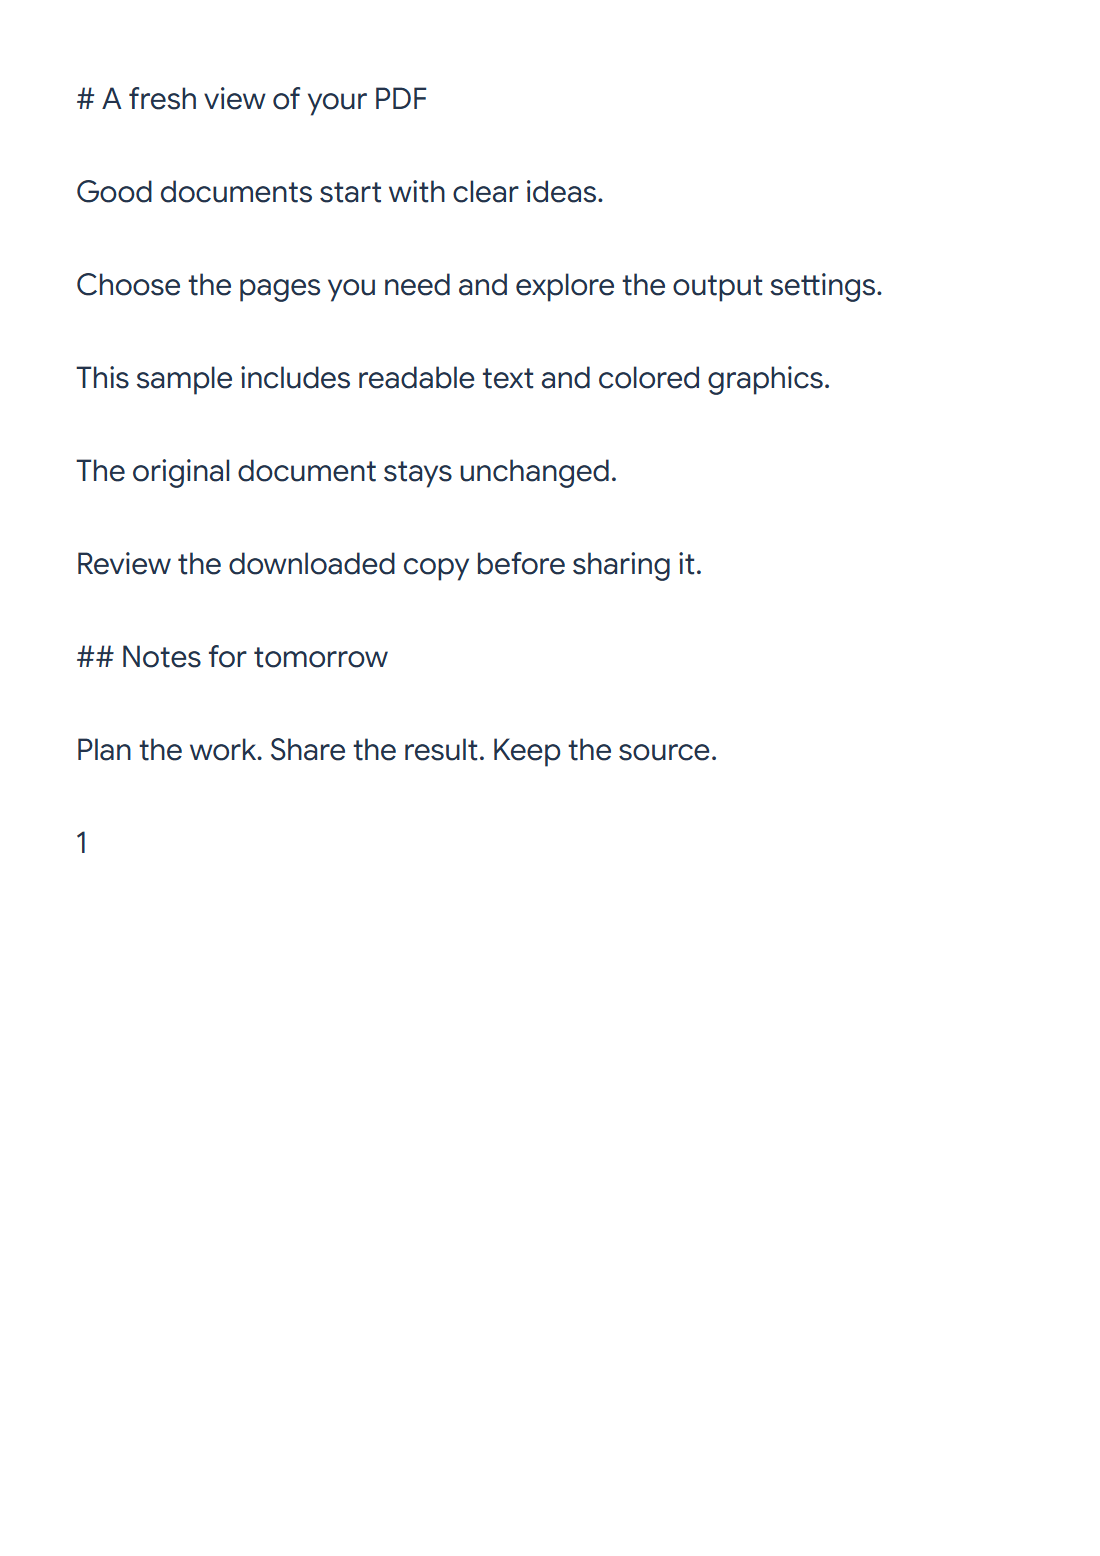

Gebruik PDF naar Markdown om tekst en waarschijnlijke koppen te extraheren en bekijk vervolgens de bewerkbare bron. Ons voorbeeld van twee pagina's exporteert een Markdown-document van 700 bytes.
Kies de bronpagina's
Laad de PDF en laat Pagina's om te verwerken leeg voor beide voorbeeldpagina's, of voer een bereik in. Gescande afbeeldingen hebben OCR nodig vóór deze tekstgebaseerde conversie.
Converteer en controleer de Markdown
Kies Start. De resultaten tonen bewerkbare Markdown en een gerenderd Voorbeeld. Schakel op een smal scherm tussen de tabbladen.
De hoofdtitel van het voorbeeld wordt een kop van het eerste niveau en 'Notes for tomorrow' wordt een kop van het tweede niveau. De detectie gebruikt tekstgrootte, dus een groot decoratief label moet mogelijk worden gecorrigeerd.
Bewerk de structuur en download
Corrigeer kopniveaus, witruimte, lijsten en leesvolgorde in de bron. Het voorbeeld wordt bijgewerkt terwijl je bewerkt. Opmaakbesturingselementen helpen bij het toevoegen van nadruk, lijsten en expliciete links.
Kopieer of download het .md-bestand wanneer de bron en het voorbeeld overeenstemmen. Deze acties gebruiken de bewerkte bron; de originele PDF blijft ongewijzigd.
Veelgestelde vragen
Waarom kreeg een kop het verkeerde niveau?
De extractor gebruikt tekstgrootte in plaats van de volledige documentstructuur te begrijpen. Pas de #-markeringen aan en controleer het Voorbeeld.
Haalt het Voorbeeld gekoppelde afbeeldingen op?
Het huidige voorbeeld toont afbeeldingsverwijzingen als tekst zonder externe afbeeldingen te laden. Controleer deze in de applicatie waar je de Markdown later publiceert.
Probeer het met jouw document
Controleer het resultaat en sla vervolgens de versie op die je nodig hebt.